Nvidia veröffentlicht Nemotron 3.5 Bolt E4B: lokaler Agent für 4 GB VRAM, bei Tool-Calling hinter Qwen3.5-4B
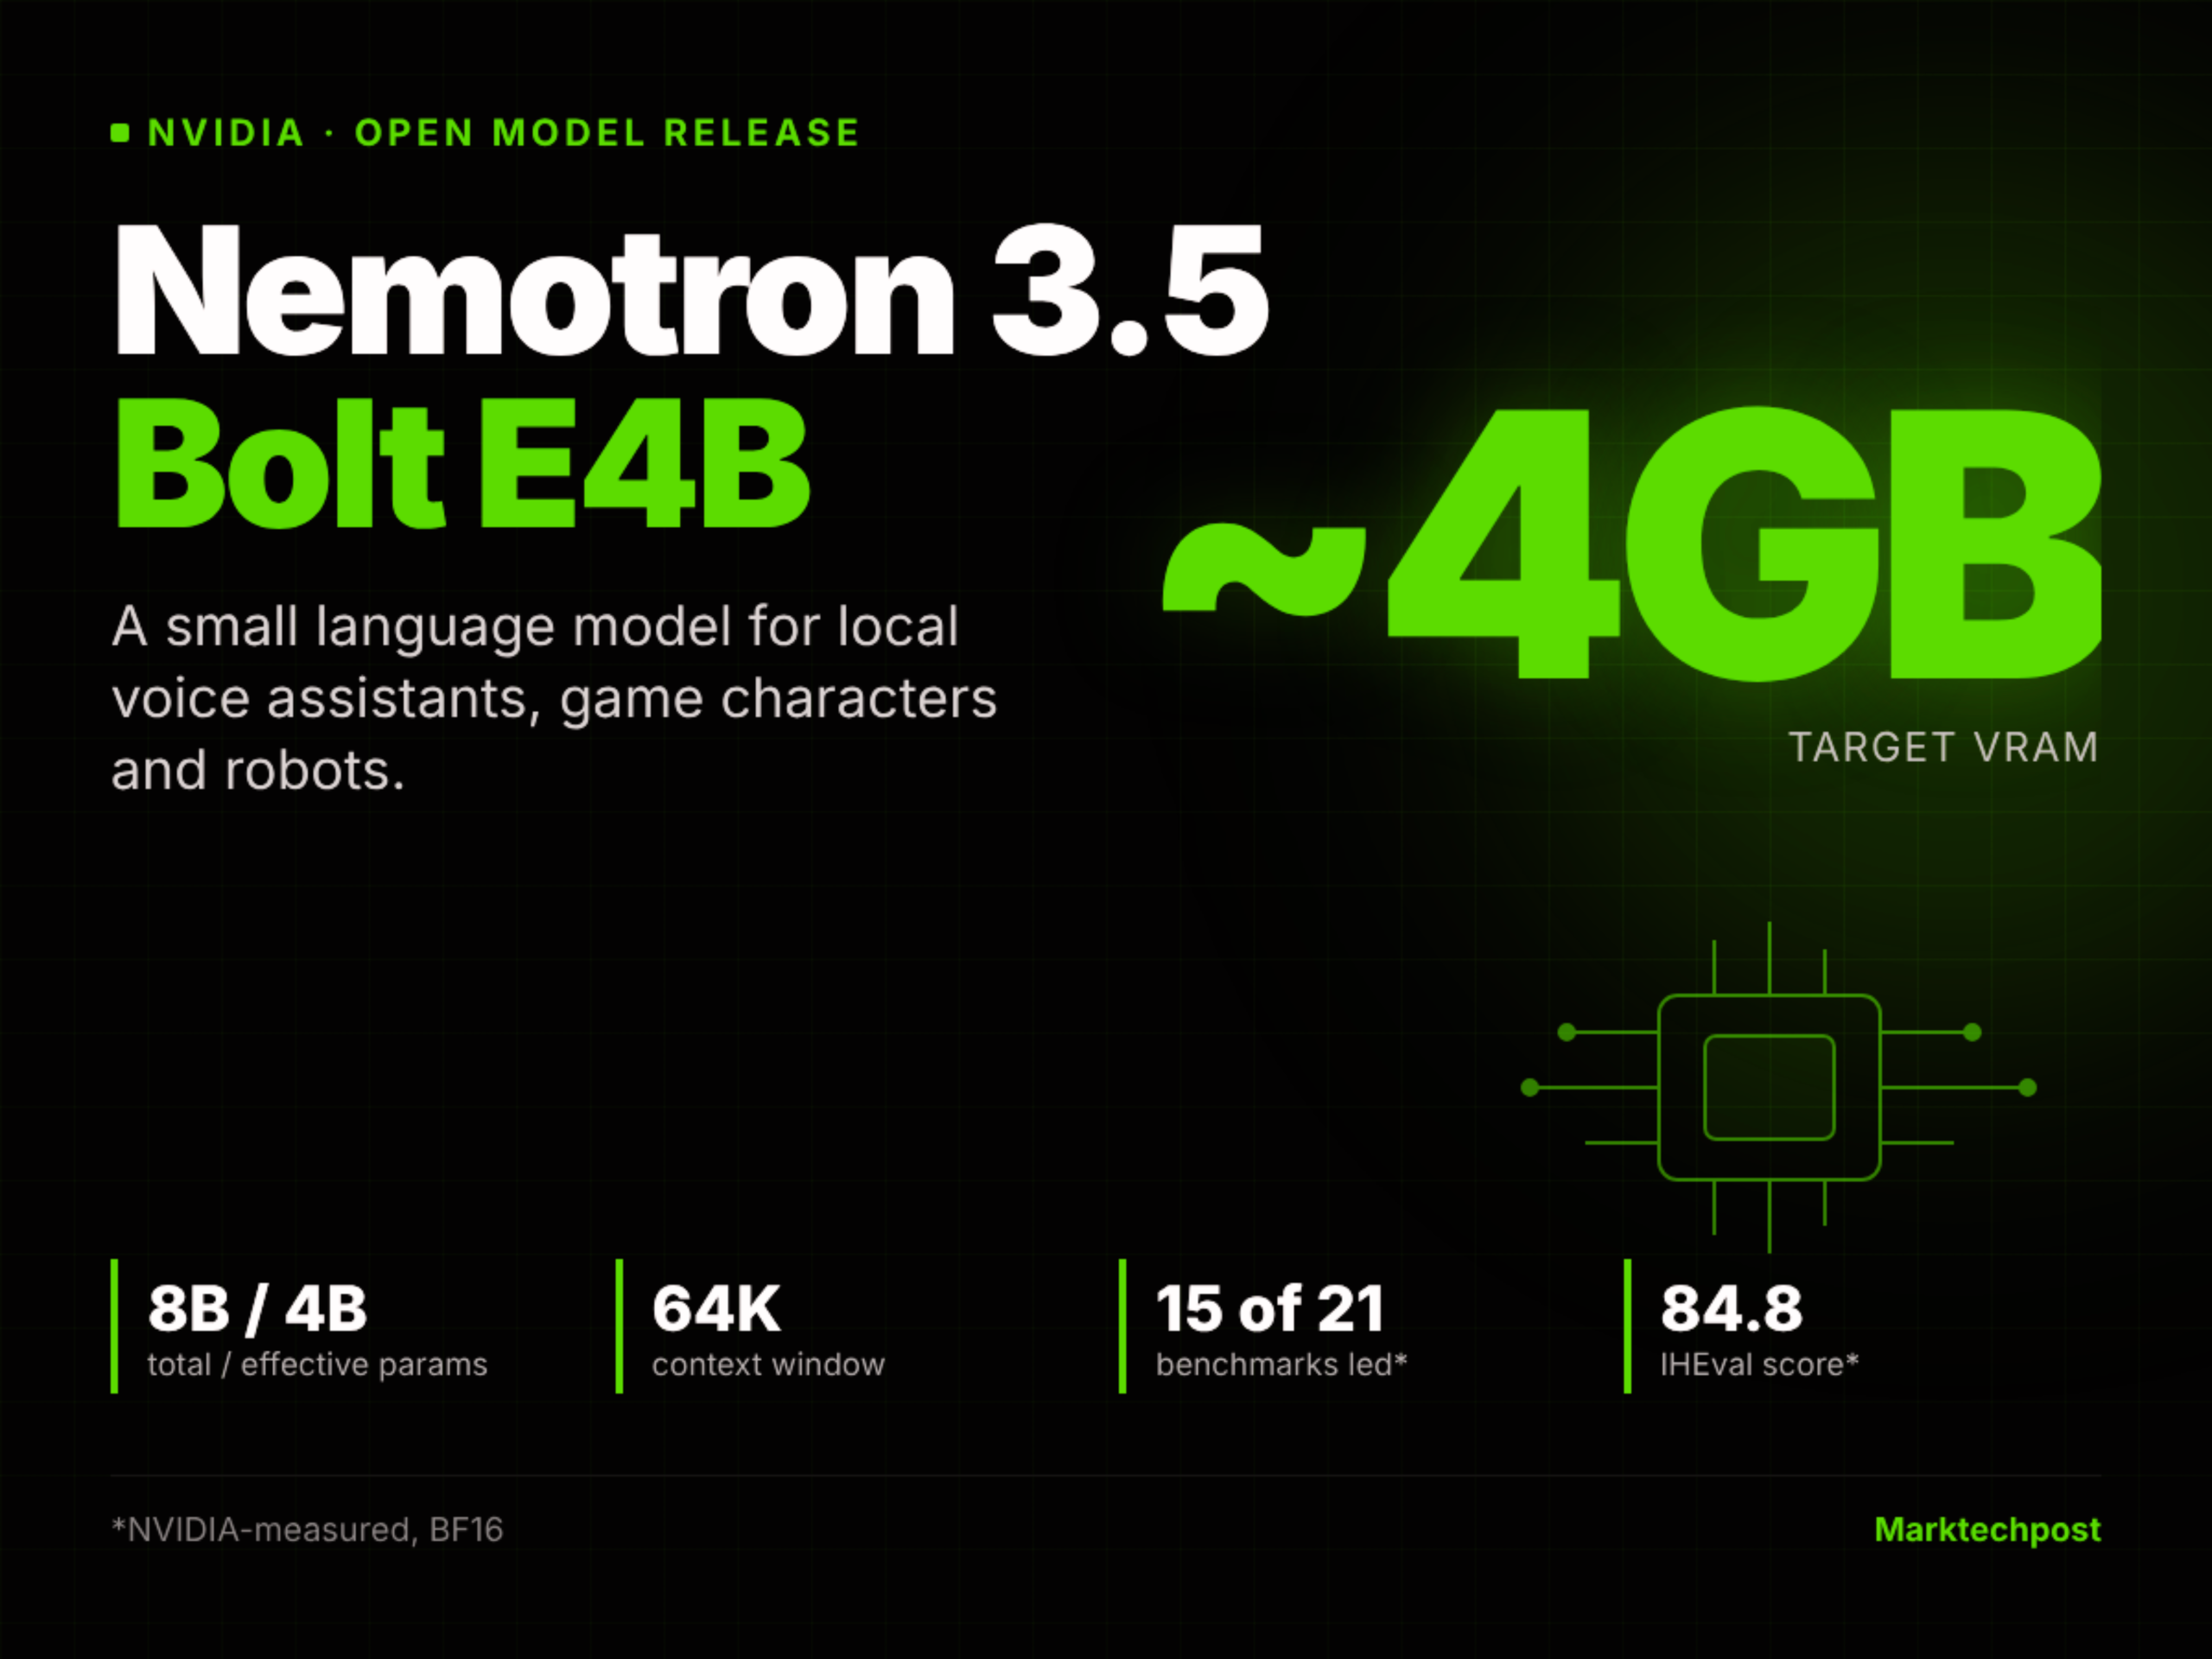
Laut einem Bericht von MarkTechPost vom 23. Oktober 2026 hat Nvidia das Open-Weight-Modell Nemotron 3.5 Bolt E4B veröffentlicht. Es basiert auf Gemma 4 E4B und wurde ausschließlich per Reinforcement Learning nachtrainiert, hat 8 Milliarden Gesamtparameter, 4 Milliarden aktive Parameter und 64K Kontext und richtet sich an lokale Sprachassistenten, Spiel-NPCs und Roboter. Der Hersteller gibt an, in 15 von 21 Benchmarks zu führen, liegt aber bei Tau2-Bench mit 55,1 hinter Qwen3.5-4B mit 75,1.
Was sich geändert hat
Der Bericht von MarkTechPost vom 23. Oktober 2026 besagt, dass Nvidia Nemotron 3.5 Bolt E4B veröffentlicht hat. Ausgehend von Googles Gemma 4 E4B wird die überwachte Feinabstimmung vollständig übersprungen und ausschließlich mit RLVR und RLHF über NeMo-RL und NeMo-Gym nachtrainiert. Jedes Trainingsbeispiel durchläuft gleichzeitig einen Inferenz- und einen Nicht-Inferenz-Modus, wobei das Verhältnis von Nicht-Inferenz- zu Inferenz-Beispielen in einer Charge 2:1 beträgt. Eine Längenstrafe in der GenRM-Umgebung unterdrückt längere Antworten, Datensatz und Rezept sind offengelegt. Das Modell hat 8 Milliarden Gesamtparameter, 4 Milliarden aktive Parameter und 64K Kontext, unterstützt mehrstufige und asynchrone Tool-Aufrufe und erzeugt mit einem conversational_mode-Flag kurze, für Sprache geeignete Antworten; Reasoning-Fähigkeit und Laufzeit-Denkbudget sind konfigurierbar. Der Bericht bezeichnet es als dritte Generation kleiner Modelle für NVIDIA-ACE-Spielcharaktere und zeigt einen Reachy-Mini-Roboter auf einem Jetson Orin Nano 8GB, bei dem Cosmos 3 Edge die Vision und Bolt die Sprachantworten und Tool-Aufrufe übernimmt. Auf der Deployment-Seite quantisiert Nvidia den BF16-Checkpoint mit einer Wichtigkeitsmatrix-kalibrierten Methode zu Q4_K_M, kalibriert mit etwa 1 Million Token an RL-Rollouts, und liefert einen DFlash-Drafter für spekulatives Decoding mit. Laut Bericht erreicht Bolt auf einer RTX 5070 272,6 Token/s, Gemma 4 E4B mit seinem MTP-Drafter 225,9 Token/s. Die Hardware-Messungen (Q4_K_M, llama.cpp, Batch Size 1, 3K Eingabe und 50 Ausgabe-Token) zeigen: RTX 5070 belegt 3,5 GB VRAM, erstes Token nach 548 Millisekunden, 133,4 Token/s; Jetson AGX Orin 32GB belegt 4,2 GB, 3687 Millisekunden, 24,0 Token/s; Jetson Orin Nano 8GB belegt 4,2 GB, 5785 Millisekunden, 15,5 Token/s. Der Bericht betont, „4 GB“ sei ein Zielbereich für den VRAM und keine Dateigröße; das Q4_K_M GGUF auf Hugging Face umfasst 6,18 GB. Die Gewichte werden unter der Lizenz OpenMDW-1.1 veröffentlicht, Daten und Rezept sind offengelegt. Das Modell ist auf Hugging Face, Ollama, LM Studio, Unsloth und Jetson AI Lab verfügbar und wird zudem als NVIDIA NIM und In-Game Inferencing SDK angeboten; auf Nvidias offizieller gehosteter Plattform gibt es außerdem eine kostenlose API. Zu den Benchmarks: Alle genannten Werte sind BF16 und wurden von Nvidia im eigenen NeMo-Gym-Framework gemessen. In 15 von 21 Benchmarks liegt es vorn, IHEval 84,8 (Gemma 4 E4B 67,0, Qwen3.5-4B 60,6); Tau2-Bench 55,1 liegt hinter Qwen3.5-4B mit 75,1, RULER 64K mit 87,0 ebenfalls unter Qwen3.5-4B mit 95,1, auch LongBench v2 (50,5 zu 59,9) und BFCL-v3 (68,5 zu 70,9) führt Qwen3.5-4B an, während Gemma 4 E4B bei EQ-Bench v3 mit 41,1 zu 39,4 leicht vorn liegt. Der Bericht gibt zudem Nvidias Aussage wieder, der Durchschnittswert liege etwa 40 % über Nemotron 3 Nano 4B und im Vergleich mit aktiviertem Reasoning würden bis zu 80 % weniger Ausgabe-Token erzeugt.
Auswirkungen für Entwickler
Für Entwickler wirkt sich das vor allem auf das VRAM-Budget und die Aufgabenverteilung aus. Die genannten VRAM-Zahlen gelten nur für die reine Modellinferenz, ohne Spracherkennung, Sprachsynthese oder Vision-Modell; orientiert man sich an der Demo auf dem Jetson Orin Nano 8GB, belegt das Modell selbst bereits 4,2 GB, und der Rest entscheidet darüber, wie groß das Wahrnehmungsmodell sein darf, ob die Bildauflösung erhöht werden kann und ob ein Gerät mit mehr als 16 GB nötig ist. Auch die Unterschiede bei der Zeit bis zum ersten Token sind entscheidend: 548 Millisekunden auf einer RTX 5070 und 5785 Millisekunden auf einem Orin Nano sind völlig unterschiedliche Interaktionserlebnisse, letzteres ähnelt eher einem rundenbasierten als einem natürlichen Gespräch. Die Fähigkeitsverteilung macht es eher zu einer Spezialkomponente als zu einem Allzweck-Kleinmodell. Von 21 Benchmarks in 5 Fähigkeitsbereichen beansprucht Nvidia nur in 15 einen Vorsprung; die Niederlagen konzentrieren sich auf langen Kontext und Agent-Tool-Ketten: Tau2-Bench, RULER 64K, LongBench v2 und BFCL-v3 gehen an Qwen3.5-4B. Umgekehrt sind Anweisungsbefolgungswerte wie IHEval 84,8 eine Stärke, und conversational_mode deutet auf kurze, schnelle, direkt vorlesbare Antworten hin. Insgesamt ist es ein Kandidat für „Dialog plus leichte Tool-Aufrufe“, nicht die Standardwahl für komplexe mehrstufige Planung oder sehr lange Kontextsuche. Die unterschiedlichen Messgrundlagen müssen in die Bewertung einfließen. Alle genannten Werte wurden vom Hersteller im eigenen Testframework gemessen und können von unabhängigen Reproduktionen abweichen; der Bericht erwähnt zudem, dass Scale Labs bei MultiChallenge 56,03 % angibt, während Nvidia selbst 53,1 meldet. Dass im selben Bericht zwei Zahlenreihen nebeneinanderstehen, zeigt, dass bei der Auswahl kein einzelner Wert als abschließend gelten sollte, besonders wenn die eigene Datenverteilung von der der Benchmarks abweicht.
Integration und Bewertung
Die folgenden bedingten Empfehlungen und Analysen beruhen auf dem Bericht und sind keine verifizierten Schlussfolgerungen. Entscheidung eins: Quantisierungsvariante und Deployment-Form nach dem freien VRAM des Zielgeräts wählen. Handelt es sich um ein Jetson der 8-GB-Klasse oder eine 12-GB-Grafikkarte und sollen Sprach- und Vision-Modell gleichzeitig laufen, lohnt es sich, zuerst den Weg Q4_K_M plus llama.cpp zu prüfen – die genannten 4,2 GB Belegung bei 6,18 GB Dateigröße zeigen, dass die Gewichtsdatei selbst nicht in das „4-GB“-Budget passt und erst die quantisierte Laufzeitform praktikabel ist. Die Prüfkriterien sind konkret: bei der eigenen Eingabelänge (der Bericht nutzt 3K Eingabe und 50 Ausgabe-Token) Latenz bis zum ersten Token und Token/s messen und bestätigen, dass nach Hinzufügen des Wahrnehmungsmodells noch Reserve bleibt; liegt die Zeit bis zum ersten Token über der für das Interaktionsdesign akzeptablen Grenze, sollte man zuerst eine kleinere oder aggressivere Quantisierungsstufe wählen statt weiter am Prompt zu feilen. Entscheidung zwei: Ob Bolt zum Einsatz kommt, hängt davon ab, ob die Arbeitslast überwiegend aus Tool-Aufrufen besteht. Für einen Sprachassistenten mit kurzen Dialogen und wenigen Tool-Aufrufen lohnen sich conversational_mode und der 64K-Kontext eines Tests; ist der Kernpfad eine mehrstufige, zustandsbehaftete lange Tool-Spur, deutet der Unterschied von Tau2-Bench 55,1 zu 75,1 darauf hin, zuerst mit Qwen3.5-4B eine Baseline aufzubauen. Prüfkriterium: die eigenen mehrstufigen Tool-Aufrufspuren in ein festes Evaluationsset überführen und unter denselben Funktionsdefinitionen Aufgabenabschlussrate und durchschnittliche Aufrufrunden vergleichen, statt nur zu prüfen, ob Einzelantworten flüssig klingen. Entscheidung drei: Das Laufzeit-Denkbudget als zu kalibrierenden Parameter behandeln, nicht als Schalter. Laut Bericht unterstützt das Modell konfigurierbares Reasoning und ein Laufzeit-Denkbudget, und im Vergleich mit aktiviertem Reasoning würden bis zu 80 % weniger Ausgabe-Token erzeugt (Herstellerangabe). Das bedeutet: dieselben Gewichte ergeben mit und ohne Reasoning zwei unterschiedliche Latenz- und Qualitätskurven. Vorgehen: für die Sprachkette ein Latenzbudget festlegen, innerhalb dieses Budgets eine der beiden Varianten wählen und anhand von Ausgabe-Token-Zahl und Zeit bis zum ersten Paket prüfen, ob die Token-Einsparung auf der eigenen Aufgabenverteilung gilt. Entscheidung vier: Die Lizenz muss separat geprüft werden. Laut Bericht werden die Gewichte unter OpenMDW-1.1 veröffentlicht, während die Basis Gemma 4 E4B unter Apache 2.0 steht; die Bedingungen sind nicht identisch. Vor der Produktintegration sollte man den Lizenztext direkt lesen und Verbreitung, Namensnennung und kommerzielle Bedingungen prüfen, statt aus Labels wie „Open Weights“ Rechte abzuleiten.
Grenzen und offene Fragen
Das hier beschriebene Nemotron 3.5 Bolt E4B ist derzeit nicht auf KimiSeek verfügbar; in der Modellliste der Seite gibt es keinen entsprechenden Eintrag. Die im Bericht erwähnte kostenlose API bezieht sich auf die Verfügbarkeit dieses Modells auf Nvidias offizieller gehosteter Plattform und hat nichts mit dieser Seite zu tun; tatsächliche Verfügbarkeit und Bedingungen richten sich nach der Herstellerdokumentation. Bekannte Grenzen: Alle Benchmark-Werte im Bericht sind BF16 und wurden von Nvidia im eigenen NeMo-Gym-Framework gemessen, nicht unabhängig reproduziert; die Angaben, der Durchschnittswert liege etwa 40 % über Nemotron 3 Nano 4B und mit aktiviertem Reasoning würden bis zu 80 % weniger Ausgabe-Token erzeugt, stammen vom Hersteller. Auch der Geschwindigkeitsvergleich hat unterschiedliche Grundlagen: 272,6 zu 225,9 Token/s sind Ergebnisse von Bolt mit DFlash-Drafter gegenüber Gemma 4 E4B mit MTP-Drafter auf einer RTX 5070 und nicht direkt mit den 133,4 Token/s aus der Hardware-Tabelle austauschbar. Bei MultiChallenge meldet Nvidia selbst 53,1, ein im Bericht wiedergegebener X-Post nennt 56,03 % von Scale Labs; beide Zahlen müssen getrennt mit Quelle versehen werden. Zur Lizenz: Bolt erscheint unter OpenMDW-1.1, die Basis Gemma 4 E4B steht unter Apache 2.0, offene Gewichte bedeuten nicht gleiche kommerzielle Bedingungen. Die Hardware-Daten decken nur vier Geräteklassen von RTX und Jetson ab, für andere Plattformen gibt es keine Daten. Zu den Eingabeformen: Laut Vergleichstabelle im Bericht ist die im Modellkarte angegebene Eingabe Text, die NIM-Form akzeptiert zudem Bilder und Audio; tatsächlich verfügbare Modalitäten und Einschränkungen sind der offiziellen Dokumentation zu entnehmen, der Bericht liefert keine Evaluationsdaten zu diesen Modalitäten.