Reflection AI veröffentlicht Modell mit offenen Gewichten Beam: 501B Gesamtparameter, 23B aktiviert, Apache-2.0-Gewichte ausstehend
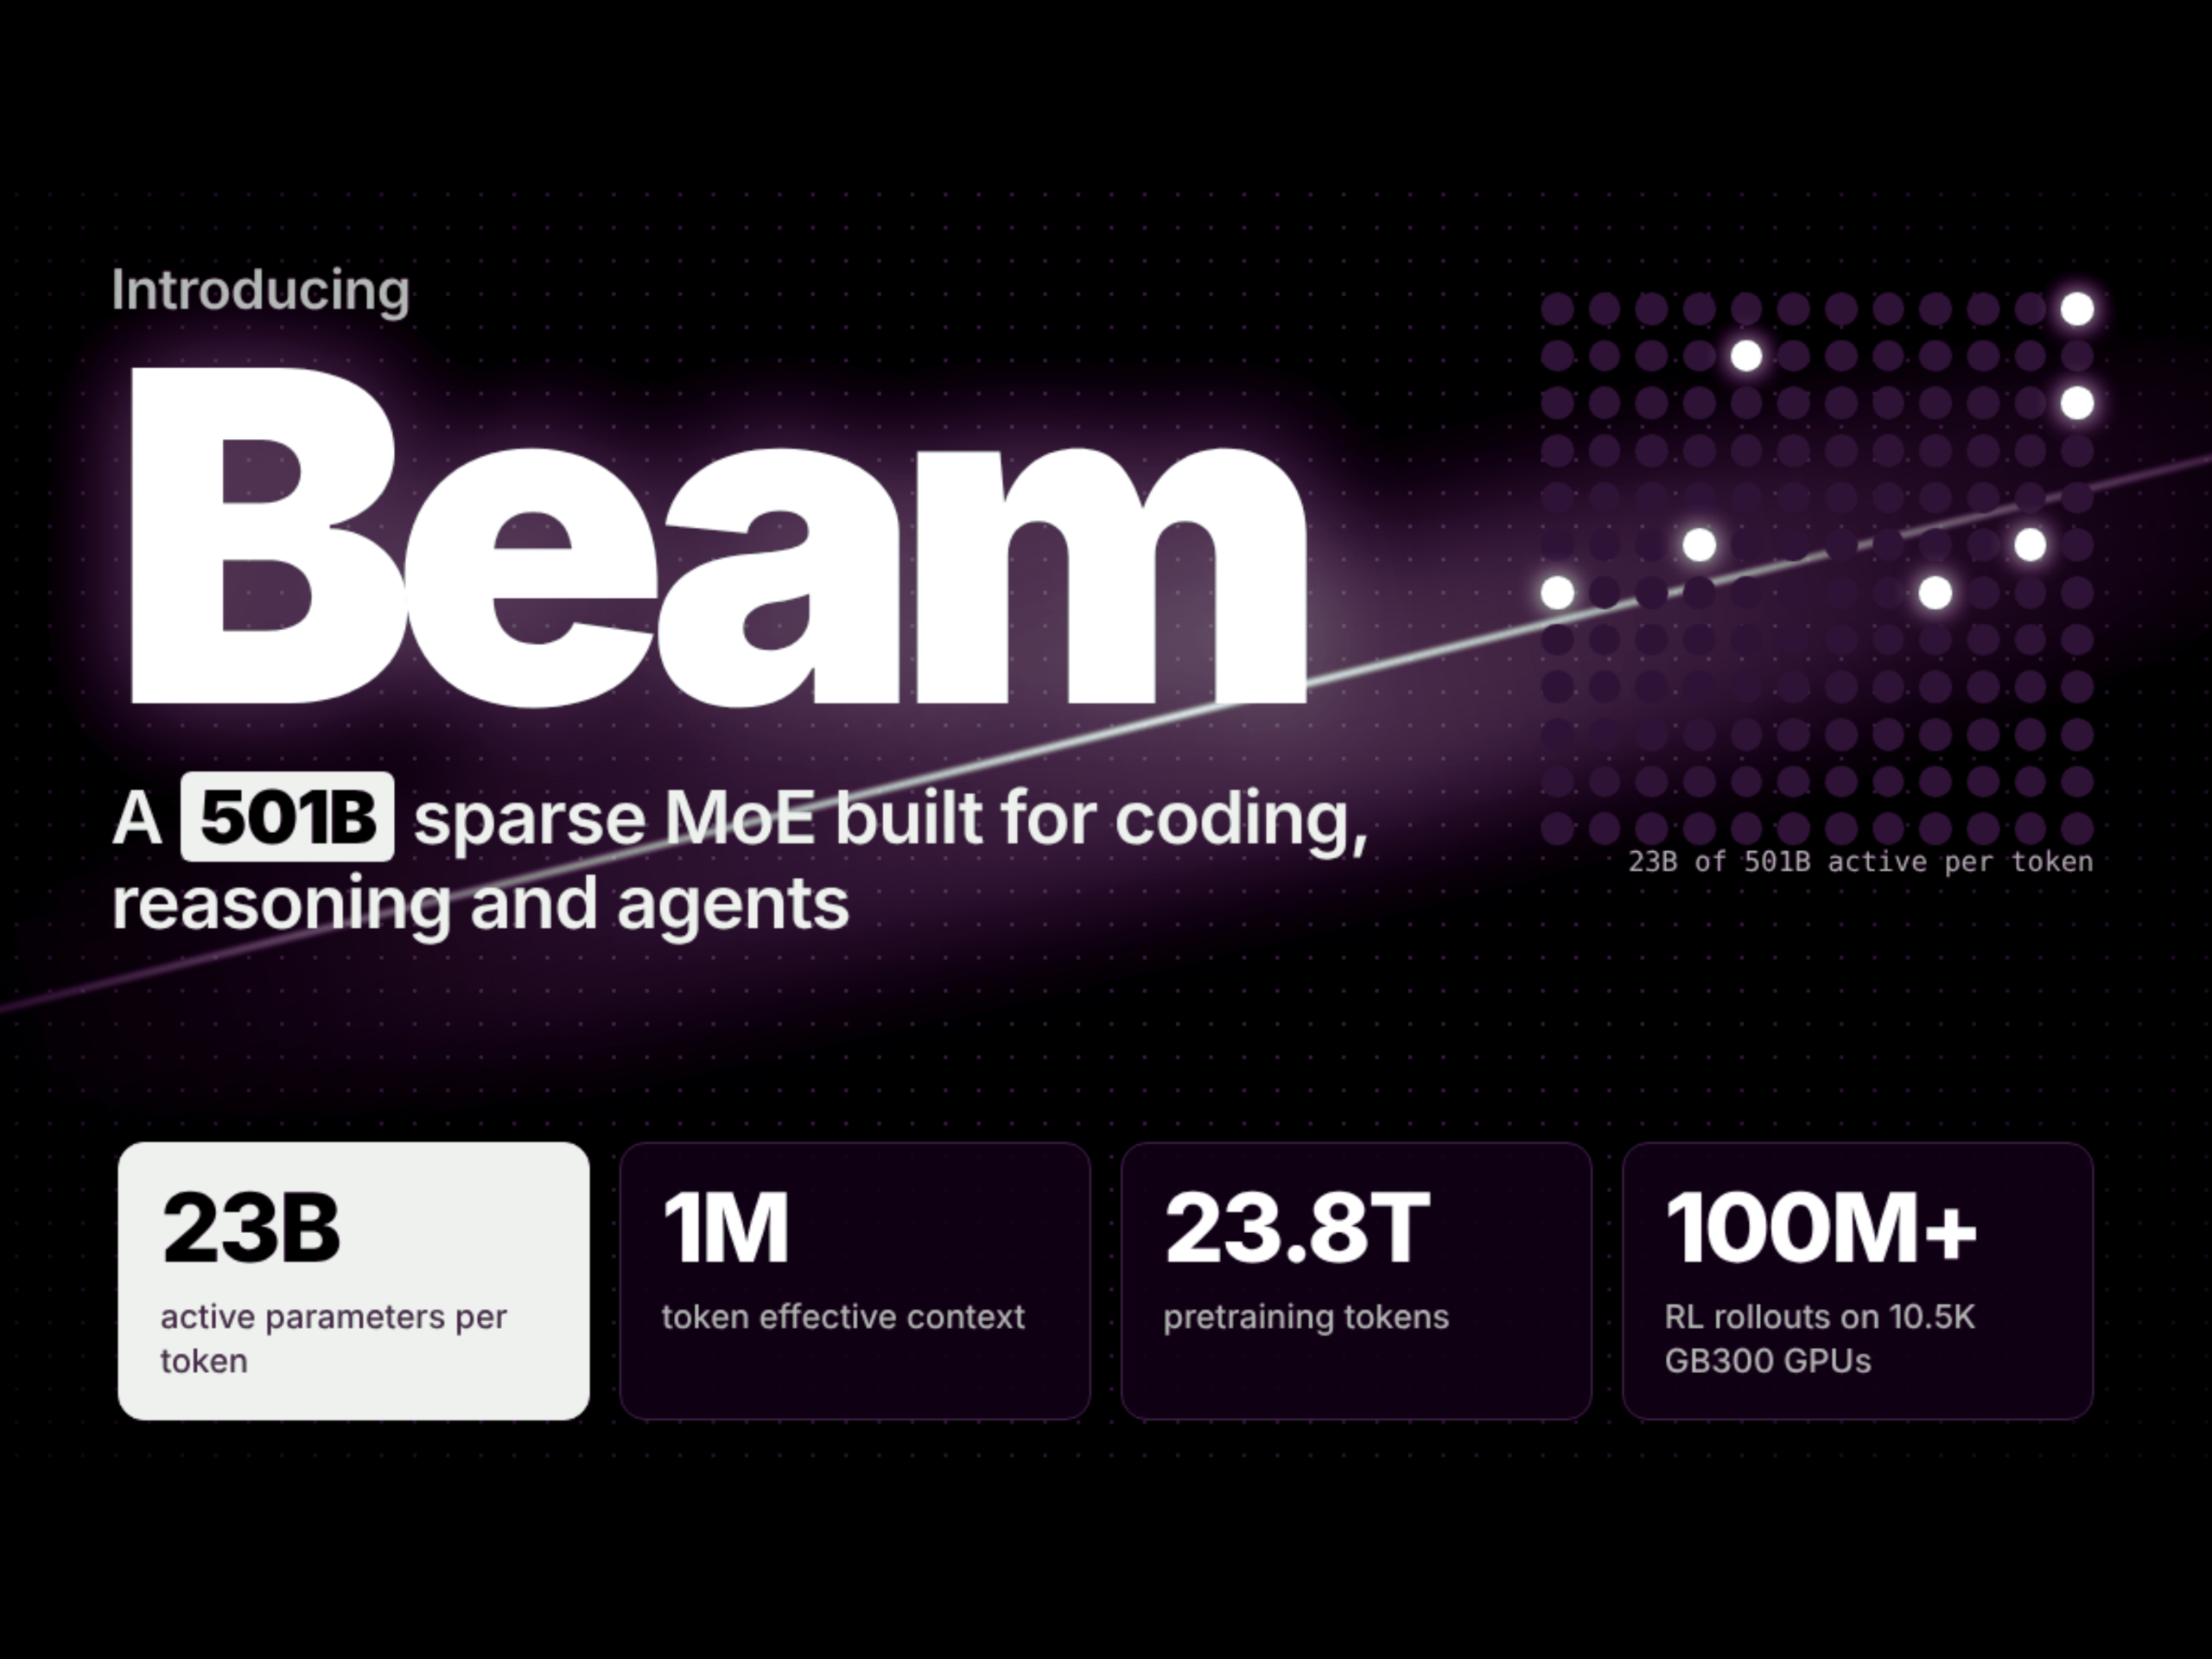
Laut einem Bericht von MarkTechPost vom 5. Oktober 2026 hat Reflection AI sein erstes Modell mit offenen Gewichten, Beam, veröffentlicht: 501B Gesamtparameter, 23B pro Token aktiviert, ausgerichtet auf Programmier- und Agentenaufgaben, unterstützt einen Reasoning-Intensitätsparameter sowie einen effektiven Kontext von 1 Million Token; die Apache-2.0-Gewichte sollen im späteren Verlauf des Oktober 2026 erscheinen, derzeit befindet sich das Modell noch im Red-Teaming und ist nur über eine Warteliste zugänglich.
Was sich geändert hat
Laut einem Bericht von MarkTechPost vom 5. Oktober 2026 hat Reflection AI sein erstes Modell mit offenen Gewichten, Beam, veröffentlicht. Beam ist ein dünnbesetztes Mixture-of-Experts-Modell mit insgesamt 501B Parametern und 23B pro Token aktivierten Parametern, ausgerichtet auf Programmier-, Reasoning- und Agenten-Workloads, unterstützt ausschließlich Texteingabe und hat einen effektiven Kontext von 1 Million Token. Das Reflection-Team gibt an, dass Beam direkt mit größeren offenen Modellen wie GLM 5.2 konkurriert und bei Reasoning-Benchmarks 3- bis 4-mal weniger Inferenzrechenleistung benötigt, räumt aber ein, dass Kimi K3 bei den Rohfähigkeiten weiterhin führend ist. Das Modell bietet einen Reasoning-Intensitätsparameter, der sich an Aufgabenschwierigkeit und Rechenbudget anpassen lässt. Das Pre-Training nutzte 23,8 Billionen Token und wurde auf 6.144 NVIDIA GB300 NVL72 GPUs in weniger als 4 Wochen abgeschlossen; die Reinforcement-Learning-Phase trainierte 4 Wochen auf 10,5K GB300 GPUs, erzeugte über 100 Millionen Rollouts und hatte einen maximalen Rollout-Kontext von 256K Token. Die von Reflection selbst veröffentlichten Ergebnisse sind SWE-bench Verified 80,9 und Terminal Bench v2.1 80,1. Berichten zufolge befindet sich Beam noch im abschließenden Red-Teaming, Self-Hosting ist vorerst nicht verfügbar, der Frühzugang läuft über eine Warteliste der Reflection-Plattform, und die Apache-2.0-Gewichte sollen im späteren Verlauf des Oktober 2026 erscheinen.
Auswirkungen für Entwickler
Gemessen an den im Bericht offengelegten Spezifikationen besteht die Positionierung von Beam nicht darin, die stärksten offenen Modelle einfach einzuholen, sondern die pro Token aktivierten Parameter auf 23B zu drücken und gleichzeitig die Gesamtparameter auf 501B zu begrenzen, um Effizienz gegen eine niedrigere Deployment-Hürde einzutauschen. Für Entwickler ändert sich damit direkt die Struktur der Inferenzkosten: Wenn die Aussage über 3- bis 4-mal weniger Rechenleistung zutrifft, könnten dieselben Programmier- oder Agentenaufgaben mit weniger GPUs bei ähnlichem Durchsatz laufen; dies ist jedoch eine Aussage des Reflection-Teams und keine unabhängig reproduzierte Schlussfolgerung. Eine zweite Auswirkung betrifft die Lizenz: Dem Bericht zufolge plant Beam Apache 2.0, während das in der Tabelle gegenübergestellte Kimi K3 eine eigene Lizenz mit zusätzlicher Namensnennungspflicht für Produkte sehr großer Größe verwendet, GLM-5.2 und DeepSeek V4.1 Flash unter MIT stehen und Nemotron 3 Ultra unter OpenMDW-1.1. Hervorzuheben ist, dass die baldige Öffnung der Gewichte und das Inkrafttreten von Lizenzbedingungen zwei verschiedene Dinge sind; Apache 2.0 war zum Zeitpunkt des Berichts noch ein Plan. Solange die Gewichte nicht tatsächlich veröffentlicht und mit einer Lizenz versehen sind, sollte kein Nutzungsrecht als bereits wirksam betrachtet werden. Die dritte Auswirkung betrifft die Fähigkeitsgrenzen: Beam unterstützt nur Text und unterscheidet sich damit von DeepSeek V4.1 Flash und Kimi K3 in der Tabelle, die Text plus Bilder unterstützen; multimodale Workloads müssen weiterhin auf andere Modelle ausweichen. Bei den Benchmarks liegen DeepSeek V4.1 Flash und Kimi K3 auf Terminal Bench v2.1 weiterhin vorn, was zeigt, dass ein Effizienzvorteil nicht mit einer umfassenden Fähigkeitsüberlegenheit gleichzusetzen ist.
Integration und Bewertung
Das Folgende sind Empfehlungen und bedingte Analysen, keine berichteten Fakten. Entscheidung eins: ob Beam in den Kandidatenpool für Programmieragenten aufgenommen werden soll. Dem Bericht zufolge liegen SWE-bench Verified bei 80,9 und Terminal Bench v2.1 bei 80,1, beide von Reflection selbst gemeldet; Voraussetzung ist, dass Gewichte und Lizenz tatsächlich verfügbar gemacht werden, andernfalls ist derzeit nur eine Bewertung über die Warteliste möglich. Ein praktikables Bewertungskriterium ist: Bei Patch-Generierungsaufgaben im eigenen Repository die Bestehensrate und den Token-Verbrauch pro Aufgabe mit dem aktuell verwendeten Modell vergleichen; nur wenn die Bestehensrate ähnlich ist und der Token-Verbrauch deutlich sinkt, besteht Wechselwert. Entscheidung zwei: wie mit dem Kosten-Qualitäts-Kompromiss durch den Reasoning-Intensitätsparameter umgegangen werden soll. Dem Bericht zufolge neigt die niedrige Stufe zu kürzeren Antworten, während die hohe Stufe längeres Reasoning erlaubt; dies ist ein für Beam spezifischer expliziter Kontrollpunkt und eignet sich für Pipelines mit stark unterschiedlicher Aufgabenschwierigkeit. Das Auswahlprinzip lautet: Zunächst alle anderen Variablen fixieren, dieselbe Reihe schwieriger Aufgaben getrennt mit niedriger, mittlerer und hoher Stufe durchlaufen lassen, Genauigkeit und gesamte Ausgabe-Token erfassen, den Wendepunkt der Kostenkurve finden und erst dann entscheiden, welche Stufe als Standard gesetzt wird, statt global eine einzige Stufe zu verwenden. Entscheidung drei: vorgelagerte Lizenz- und Compliance-Prüfung. Vor der Veröffentlichung der Gewichte sollte als Voraussetzung für den Produktivbetrieb festgelegt werden, ob tatsächlich unter Apache 2.0 veröffentlicht wird und ob die Lizenzdatei mit den Gewichten bereitgestellt wird; entspricht die Veröffentlichung nicht den Erwartungen des Berichts, muss die Wechselentscheidung neu getroffen werden. Bewertungskriterium ist, ob die Lizenzdatei synchron mit den Gewichten bereitgestellt wird und die Bedingungen den Erwartungen entsprechen.
Grenzen und offene Fragen
Zum Zeitpunkt des Berichts befand sich Beam noch im abschließenden Red-Teaming, Self-Hosting war nicht verfügbar, der Frühzugang lief ausschließlich über die Warteliste der Reflection-Plattform; daher sind derzeit keine lokalen Tests mit den Gewichten möglich. Alle Benchmark-Werte stammen aus einer von Reflection selbst veröffentlichten Tabelle, in der Konkurrenzwerte von Artificial Analysis und DataCurve zitiert werden; eine unabhängige Drittreproduktion liegt nicht vor, SWE-bench Verified 80,9 und Terminal Bench v2.1 80,1 sind als vom Anbieter selbst gemeldete Daten zu betrachten. Apache 2.0 wird als Plan beschrieben, die Gewichte sollen im späteren Verlauf des Oktober 2026 erscheinen; zum Zeitpunkt der aktuellen Katalogprüfung ist diese veröffentlichte Version von Beam nicht in KimiSeek gelistet, und die im Bericht genannte API- und Plattformverfügbarkeit bezieht sich ausschließlich auf Reflection AI und steht in keinem Zusammenhang mit dem Katalog dieser Seite. Ergebnisse der Sicherheitsbewertung sollen laut Bericht im technischen Bericht veröffentlicht werden, konkrete Daten gibt es derzeit noch nicht. Die Aussage über 3- bis 4-mal weniger Inferenzrechenleistung stammt vom Reflection-Team; Testbedingungen, Wahl der Baseline und Messmethode werden im Bericht nicht erläutert. Ob sich die Effizienzsteigerung in einer Self-Hosting-Umgebung reproduzieren lässt, bleibt unbekannt.
Abbildungen aus dem Originalbericht