Reflection Beam: Offene 501B-Gewichte unter Apache 2.0 und zwei AWS-Bereitstellungspfade
Laut einem am 16. Oktober 2026 veröffentlichten AWS-Blog hat Reflection AI sein offenes Gewichtsmodell Beam vorgestellt, das auf agentisches Codieren und langfristige Aufgaben ausgerichtet ist: 501 Mrd. Gesamtparameter, 23 Mrd. aktivierte Parameter, laut Bericht effektiver Kontext von 1 Mio. Token, Gewichte unter Apache 2.0 über Hugging Face, BF16/FP8/NVFP4-Checkpoints sowie zwei Bereitstellungspfade über SageMaker JumpStart und HyperPod.
Was sich geändert hat
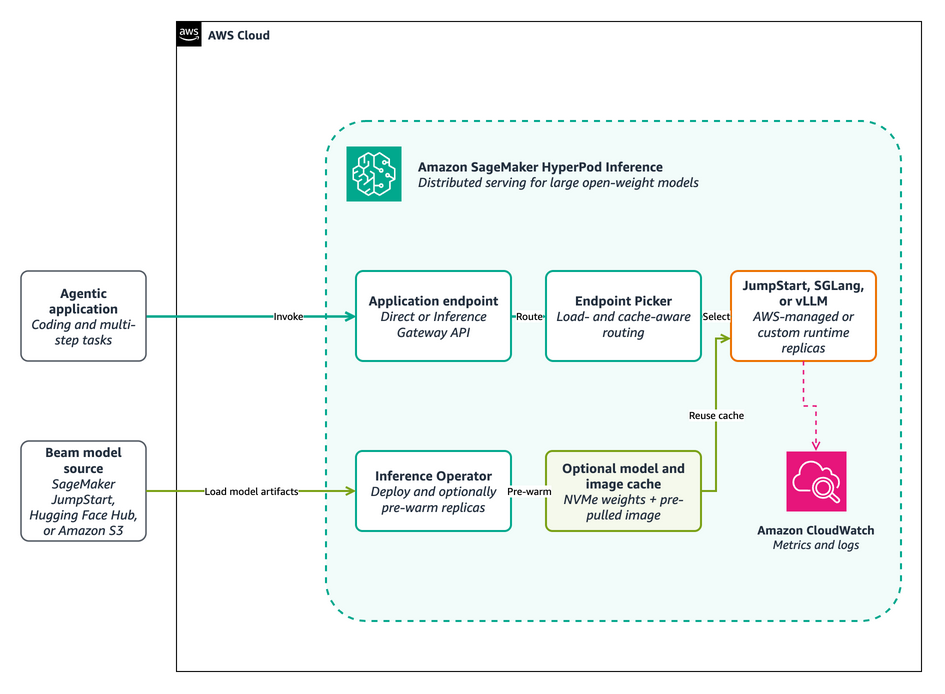
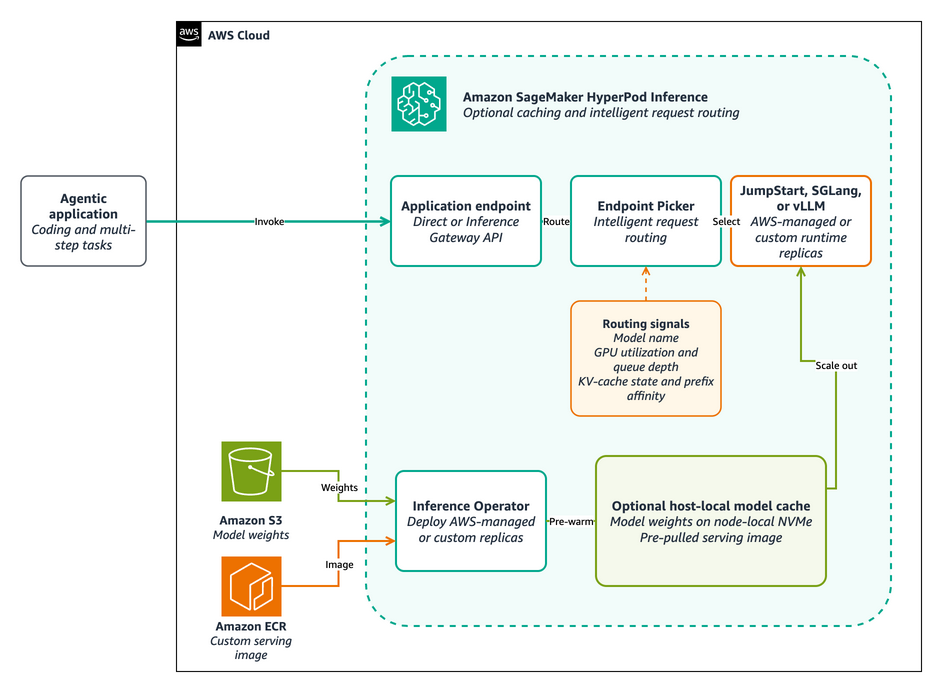
Laut einem offiziellen AWS-Blog vom 16. Oktober 2026 hat Reflection AI das offene Gewichtsmodell Beam veröffentlicht, positioniert für agentisches Codieren und langfristige Aufgaben wie Code-Wartung, Werkzeugaufrufe, Ergebnisinterpretation und mehrstufige Workflows. Das Modell ist eine spärliche Mixture-of-Experts-Architektur (MoE) mit 501 Mrd. Gesamtparametern und 23 Mrd. aktivierten Parametern; Reflection gibt eine effektive Kontextlänge von 1 Mio. Token an. Reflection veröffentlicht die Beam-Gewichte über Hugging Face unter der Apache-2.0-Lizenz. Beam 1.0 bietet drei Checkpoint-Varianten in BF16, FP8 und NVFP4 für unterschiedliche Speicheranforderungen und Hardware. Zum Veröffentlichungszeitpunkt war das Modell in Amazon SageMaker JumpStart in zwei Regionen verfügbar: USA Ost (Nord-Virginia) und Ohio. Der Blog nennt zwei Bereitstellungspfade: den SageMaker-JumpStart-Echtzeit-Endpunkt (vollständig verwaltet) und SageMaker HyperPod Inference (mit verwaltetem JumpStart-Container oder benutzerdefiniertem SGLang, vLLM). Der Beitrag enthält außerdem eine Anleitung zur Instanzauswahl nach Präzision: FP8 auf H100 ml.p5.48xlarge oder H200 ml.p5e/ml.p5en.48xlarge, NVFP4 auf B200 ml.p6-b200.48xlarge; zudem wird betont, dass BF16-Gewichte den größten Speicherbedarf haben und eine Mehrknotenplanung erfordern. Gleichrangig ist festzuhalten: Dies ist die berichtende Darstellung des Blogs; KimiSeek hat Modellfähigkeiten, Instanzunterstützung oder regionale Verfügbarkeit nicht unabhängig verifiziert.
Auswirkungen für Entwickler
Für Entwickler bedeutet dies konkret: Es handelt sich um eine Veröffentlichung offener Gewichte, die als Apache-2.0-lizenziert angegeben wird, was auf Lizenzebene klarer ist als eine bloße Downloadbarkeit der Gewichte; die Lizenzrechte sind dennoch anhand des Hugging-Face-Repositories und des Lizenztextes zu prüfen und nicht aus der Verfügbarkeit der Gewichte für kommerzielle Nutzung, Weitergabe oder abgeleitetes Training abzuleiten. Technisch bedeutet die spärliche Struktur mit 501B/A23B, dass Speicher- und Bereitstellungskosten von den Gesamtparametern bestimmt werden, während die Berechnung pro Token eher der Größenordnung von 23B aktivierten Parametern entspricht; Gewichtsspeicher, Sharding und Parallelitätslayout sind daher die primären Randbedingungen: BF16 erfordert aggregierten Speicher über mehrere Knoten, FP8 und NVFP4 verengen die praktikable Hardware auf bestimmte Instanzen von H100/H200 und B200. Bei der Bereitstellungsform gibt es echte Abwägungen – der JumpStart-Echtzeit-Endpunkt kapselt Modell, Container und Endpunkt als verwalteten Workflow und eignet sich für schnelle Validierung; HyperPod legt Cluster und Laufzeit offen und erlaubt feste Image-Digests, Beam-Commit-SHA und Parallelitätsparameter, was für Teams geeignet ist, die Leistungsergebnisse reproduzieren oder Quantisierung und Parser anpassen wollen. Der im Blog genannte effektive Kontext von 1 Mio. Token beeinflusst KV-Cache-Budget und Batching-Strategie; der Speicherbedarf bei langem Kontext muss gemessen und nicht geschätzt werden. Für die Evaluierung gilt: Das Modell ist auf mehrstufige Werkzeugaufrufe ausgerichtet; Single-Turn-Q&A-Benchmarks reichen nicht aus, um sein Verhalten in echten Agenten-Schleifen zu belegen. Stattdessen sollten Lasten aus repräsentativen Coding- und Werkzeugnutzungsanfragen konstruiert werden.
Integration und Bewertung
Im Folgenden handelt es sich um Bewertungsempfehlungen auf Basis des Blogs, nicht um verifizierte Schlussfolgerungen. Erstens: Zuerst entscheiden, ob verwaltet oder selbst betrieben. Wenn das Ziel eine schnelle Integration ist und das Team keine Kubernetes-Betriebserfahrung hat, den JumpStart-Echtzeit-Endpunkt für einen begrenzten Lebenszyklus nutzen (Bereitstellung, einzelne Anfrage, Aufräumen) und als Erfolgskriterium festlegen, dass der Endpunkt nach Bereitschaft eine Antwort gemäß dem veröffentlichten Anfrage-Schema zurückgibt; erst wenn feste Laufzeitparameter, Quantisierung oder benutzerdefinierte Parser benötigt werden, auf SGLang oder vLLM auf HyperPod wechseln, wobei Image-Digest, Modellrevision und Parallelitätskonfiguration als reproduzierbar gelten. Zweitens: Eine Kapazitätsentscheidung nach Präzision treffen. Aggregierten Speicher aus Gewichten pro Replikat, KV-Cache und Laufzeit-Overhead schätzen und per Lasttest korrigieren; wenn der Zielkontext nahe am berichteten effektiven Maximum liegt, zuerst prüfen, ob p95-Zeit bis zum ersten Token und Zeit pro Ausgabe-Token bei langem Kontext das Latenzbudget erfüllen; bei NVFP4 oder FP8 muss die Ausgabequalität erneut auf Verschlechterung geprüft werden. Drittens: Für Agenten-Szenarien eine messbare Abnahmelinie definieren: mit echten Code-Reparatur- und mehrstufigen Werkzeugaufrufanfragen unter erwarteter Nebenläufigkeit wiederholt belasten, Erfolgsrate, p50/p95-Zeit bis zum ersten Token, Ende-zu-Ende-Latenz und aggregierten Ausgabedurchsatz erfassen und Modellversion, Image-Digest, Präzision, Kontextlänge und Cache-Zustand dokumentieren, sonst sind Vergleiche über Konfigurationen hinweg nicht aussagekräftig. Viertens: Zuerst im kleinen Maßstab validieren, dann skalieren: Service-Quotas und Regionskapazität des gewählten Instanztyps prüfen; beachten, dass Image-Transfer, Gewichtsdownload und Sharding-Laden erhebliche Kaltstartzeiten verursachen; Caching- und Autoscaling-Strategien auf Messungen statt auf Annahmen stützen. Fünftens: Nach Abschluss der Tests Endpunkte, Cluster, zwischengespeicherte Gewichte und temporäre IAM-Ressourcen gemäß den offiziellen Beispielen bereinigen, um fortlaufende Abrechnung zu vermeiden.
Grenzen und offene Fragen
Das Beam 1.0 (501B/A23B) dieser Veröffentlichung ist derzeit nicht auf KimiSeek gelistet; die hier beschriebenen Bereitstellungspfade, Aufrufarten und jegliche Verfügbarkeit beziehen sich auf die Veröffentlichungskanäle von Reflection AI und AWS, nicht auf einen Dienst dieser Seite. Kimi K3, GLM, Qwen, DeepSeek und andere auf KimiSeek sind unterschiedliche Modelle und belegen keine Verfügbarkeit dieser Version. Dieser Bericht stützt sich auf eine einzelne Quelle, den AWS-Blog; KimiSeek hat Parameteranzahl, effektive Kontextlänge, den tatsächlichen Anwendungsbereich der Apache-2.0-Lizenz, die Hardware-Kompatibilität der Checkpoint-Varianten, den Verfügbarkeitsstatus der beiden Regionen in USA Ost sowie die Benchmark-Leistung des Modells nicht unabhängig verifiziert; der Blog nennt keine öffentlichen Coding- oder Agenten-Benchmark-Werte, und Fähigkeitsaussagen sind nicht als verifizierte Tatsachen zu betrachten. Offene Gewichte sind nicht gleich vollständig quelloffen: Lizenzbedingungen, Trainingsdaten und Reproduktionsmaterialien sind weiterhin anhand des Hugging-Face-Repositories und der offiziellen Angaben von Reflection zu prüfen. Die erwähnten HyperPod-Fähigkeiten zu Caching, Routing und Gateway gehören zum Funktionsumfang von SageMaker im Jahr 2026, ihr Verhalten ändert sich mit der Version und ist in der jeweiligen Dokumentation nachzulesen; Instanztypen und Regionen können sich im Laufe der Zeit ändern. Zu Kosten sind die jeweiligen Preis- oder Abrechnungsseiten von Reflection AI, Hugging Face und AWS maßgeblich; Preise und Quotas ändern sich. Zudem sind die im Blog genannten Sampling-Parameter (etwa temperature und top-p) nur Beispiel-Startwerte und keine empfohlene Konfiguration.
Abbildungen aus dem Originalbericht