Reflection Beam und Mistral Large 4 zeitgleich vorgestellt: mehr Optionen mit offenen Gewichten, doch Gewichte und Lizenz stehen noch aus
Laut einem Bericht der chinesischen InfoQ-Seite vom Oktober 2026 stellte das US-Unternehmen Reflection am 5. und 6. Oktober mit Beam sein erstes Modell mit offenen Gewichten vor, einen Tag später brachte das französische Mistral mit Mistral Large 4 sein bislang größtes Modell heraus. Der Bericht nennt Inferenzeffizienz als Verkaufsargument von Beam, das bei einigen Benchmarks nahe an GLM-5.2 heranreiche, aber hinter der neuesten chinesischen Generation zurückbleibe; Large 4 sei bereits als API-Vorschau verfügbar, vollständige Gewichte seien für Ende Oktober geplant. Beide Versionen sind derzeit nicht bei KimiSeek gelistet.
Was sich geändert hat
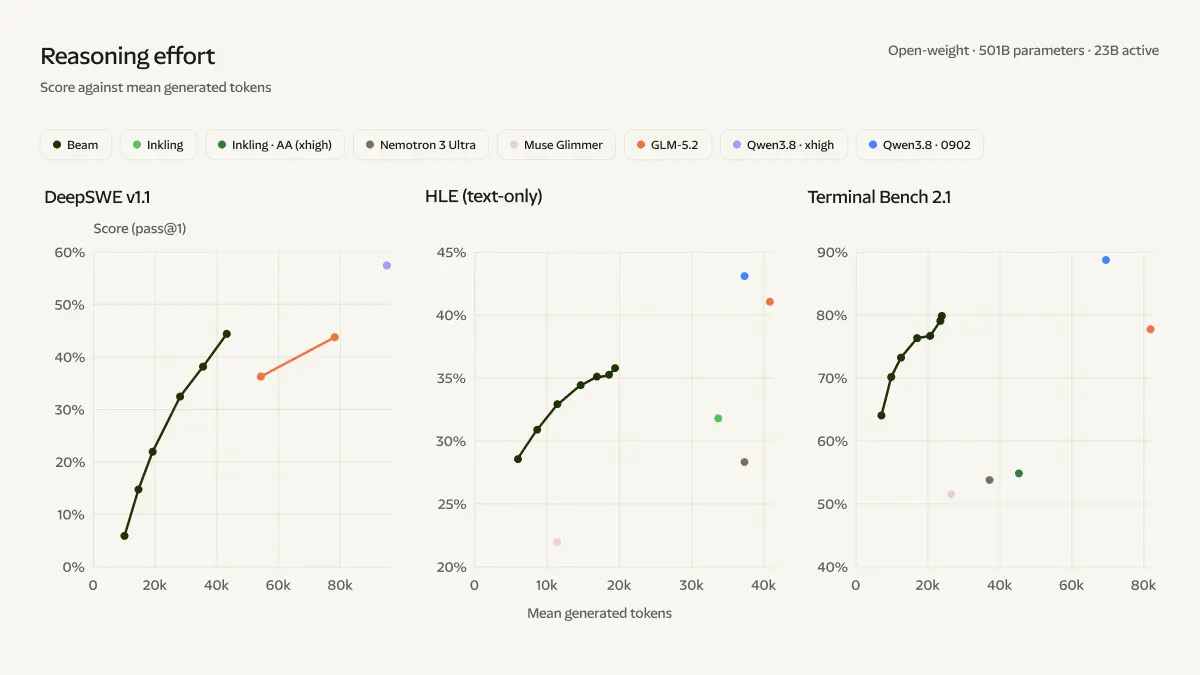
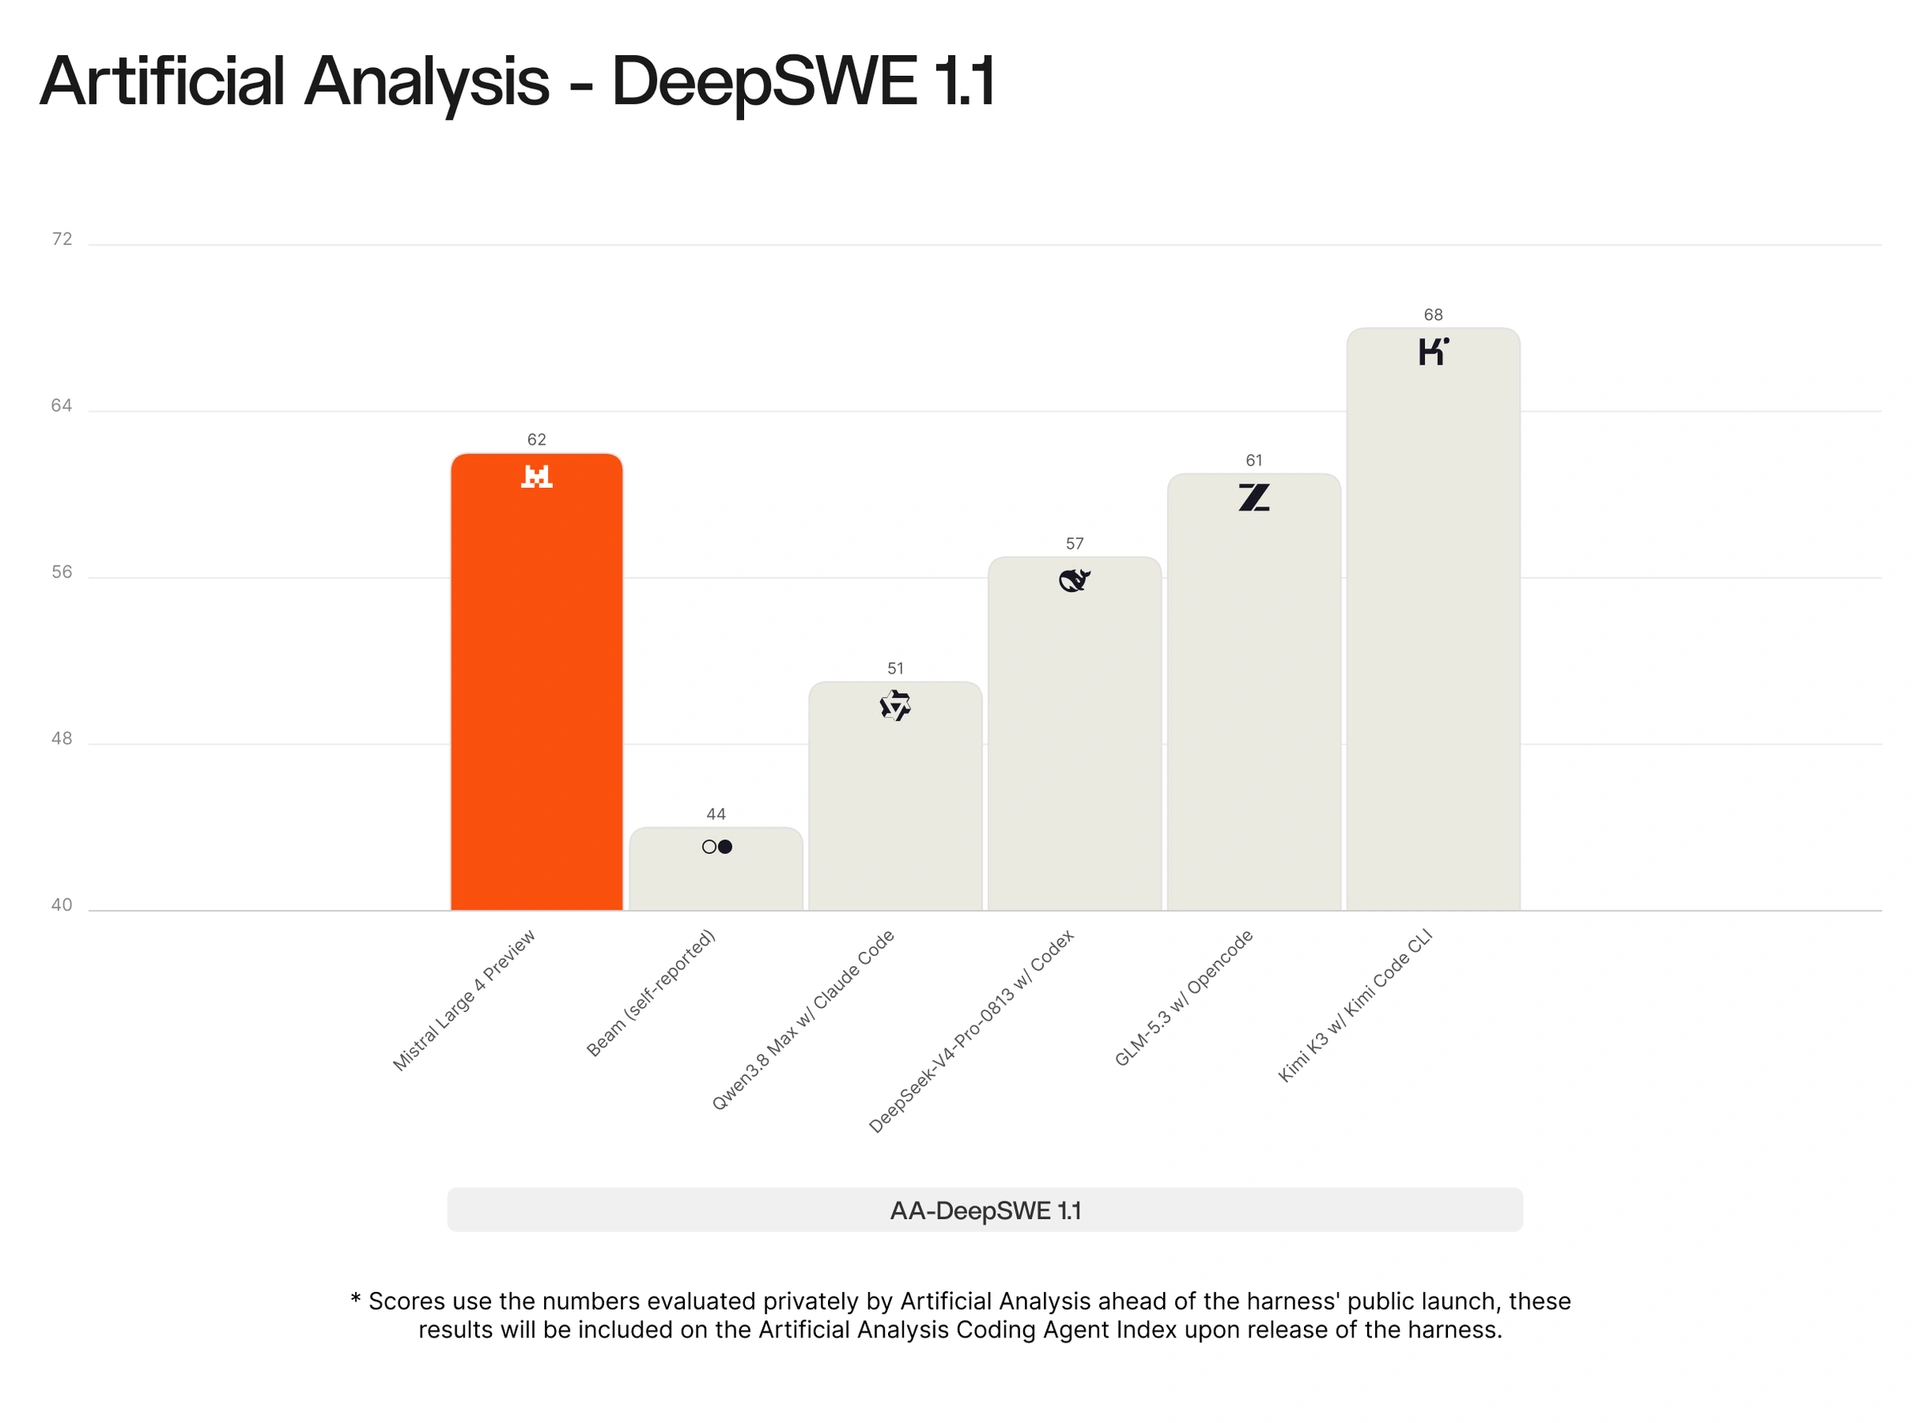
Laut dem Bericht der chinesischen InfoQ-Seite (der als lokales Datum den 5. bis 6. Oktober angibt) veröffentlichte das US-Startup Reflection mit Beam sein erstes Modell mit offenen Gewichten; einen Tag später brachte das französische Mistral Mistral Large 4 heraus. Dem Bericht zufolge ist Beam ein MoE-Modell mit insgesamt 501 Milliarden Parametern und 23 Milliarden pro Token aktivierten Parametern, ausgerichtet auf Programmier-, Reasoning- und Agent-Workloads, vortrainiert mit 23,8 Billionen Token und trainiert mit 10.500 Nvidia GB300 über vier Wochen kontinuierliches High-Compute-Reinforcement-Learning mit über 100 Millionen generierten Rollouts; zum Zeitpunkt der Veröffentlichung befand es sich noch in der abschließenden Red-Team-Phase, und Reflection plante laut Bericht, im Oktober Gewichte, technischen Bericht und Entwicklerwerkzeuge zu veröffentlichen. Mistral Large 4 hat dem Bericht zufolge 52 Milliarden aktivierte Parameter bei insgesamt 1,05 Billionen Parametern, enthält einen 1,6 Milliarden Parameter umfassenden visuellen Encoder, ist nativ multimodal, unterstützt über 160 Sprachen und hat ein Kontextfenster von 1 Million Token; trainiert worden sei es von Grund auf in europäischen Rechenzentren mit etwa 3.800 Nvidia Grace Blackwell GPUs, zum Zeitpunkt des Berichts sei eine API-Vorschau verfügbar gewesen, vollständige Gewichte seien für Ende Oktober geplant. Bei den im Bericht wiedergegebenen Benchmark-Daten erzielt Beam 44,4 bei DeepSWE v1.1 und 80,1 bei Terminal Bench v2.1, jeweils unter den im Bericht genannten Ergebnissen von GLM-5.3, Kimi K3 und DeepSeek V4.1 Flash; bei Humanity's Last Exam erreicht Beam 36,2 und liegt damit unter den im selben Text genannten 42,3 von GLM-5.3 und 46,9 von Kimi K3 (für DeepSeek V4.1 Flash gibt der Text keinen Wert bei diesem Benchmark an). Auf Mistral-Seite heißt es im Bericht, Large 4 übertreffe im offiziellen Coding Agent Index DeepSeek V4 Pro und Qwen 3.8 Max, liege aber unter Kimi K3, und übertreffe bei AutomationBench Kimi K3, MiMo-V2.6-Pro und DeepSeek V4 Pro, liege aber unter GLM-5.3. Diese Werte stammen jeweils aus Herstellerangaben oder vom Hersteller zitierten Dritttests, sind Berichtswiedergaben und nicht unabhängig reproduziert.
Auswirkungen für Entwickler
Diese Veröffentlichungen verändern das Kandidatenfeld und die Vergleichsmaßstäbe im Lager der offenen Gewichte, nicht aber unmittelbar die Verfügbarkeit chinesischer Modelle. Der technisch bedeutsamste Punkt ist, dass Reflection das Verkaufsargument von Beam von der absoluten Leistungsfähigkeit auf die Frage verlagert, wie viel Intelligenz pro eingesetzter Inferenzrechenleistung herauskommt; dem Bericht zufolge lassen sich bei einigen anspruchsvollen Reasoning-Aufgaben mit etwa einem Viertel bis einem Drittel der Rechenleistung von GLM-5.2 nahezu vergleichbare Ergebnisse erzielen. Falls diese Aussage auf eigenen Workloads zutrifft, betrifft das die Kostenstruktur pro Aufgabe bei langen Agent-Ketten und Batch-Inferenz. Nach den im Bericht wiedergegebenen Benchmarks erreicht Beam jedoch vor allem das Niveau der vorherigen chinesischen Modellgeneration und liegt bei DeepSWE v1.1 und Terminal Bench v2.1 unter den im selben Text genannten Werten von GLM-5.3, Kimi K3 und DeepSeek V4.1 Flash sowie bei HLE unter den dort genannten Werten von GLM-5.3 und Kimi K3. Damit sind 'mit weniger Rechenleistung nahezu gleiche Fähigkeit' und 'mit gleicher Rechenleistung höhere Qualität' zwei unterschiedliche Ersetzungspfade, die einander nicht vertreten können. Mistral Large 4 setzt andere Schwerpunkte: Kontext im Millionenbereich, native Multimodalität und Mehrsprachigkeit sowie die im Bericht betonte private Cloud- oder lokale Bereitstellung mit eigenen Sicherheitsrichtlinien verweisen auf unternehmensweite Workflows über Anwendungen hinweg und Szenarien mit selbst kontrollierten Datengrenzen, nicht auf einen reinen Programmier-Benchmark-Vergleich. Begrifflich ist zu unterscheiden: Beide werden als offene Gewichte beschrieben, doch die Zeitpunkte der Gewichtsverfügbarkeit unterscheiden sich im Bericht, und zum Veröffentlichungszeitpunkt waren die Gewichte bei beiden noch nicht tatsächlich offen. Offene Gewichte bedeuten herunterladbare Modelldateien und sind eine andere Frage als die Offenheit von Trainingsdaten, Trainingscode und Lizenzbedingungen; der Bericht liefert keine Lizenzdetails, aus denen sich Rechte für kommerzielle Nutzung, Weitergabe oder Feinabstimmung ableiten ließen. Zudem ergibt die Prüfung des aktuellen Katalogs, dass weder Beam noch Mistral Large 4 einen entsprechenden Eintrag bei KimiSeek haben; die im Bericht genannte API-Vorschau und Verfügbarkeit beziehen sich auf die Kanäle der Hersteller selbst.
Integration und Bewertung
Das Folgende ist bedingte Analyse bzw. Empfehlung und keine Tatsache aus dem Bericht. Erstens: Wenn die Hauptlast aus programmierenden Agent-Ketten besteht und kostenempfindlich ist: Dem Bericht zufolge erreicht Beam mit etwa einem Viertel bis einem Drittel der Inferenzrechenleistung von GLM-5.2 nahezu vergleichbare Ergebnisse, während aktuell verfügbare vergleichbare Optionen GLM-5.2 und DeepSeek V4.1 Flash umfassen; man kann zunächst mit eigenen mehrstufigen Tool-Calling-Trajektorien einen kleinen Vergleich durchführen und dabei die gesamten Token pro abgeschlossener Aufgabe sowie die End-to-End-Latenz messen, sofern man akzeptieren kann, dass Beam in den berichteten Benchmarks unter der neuesten chinesischen Generation liegt. Steigt die Fehlerrate und lösen Wiederholungen aus, werden die Recheneinsparungen aufgezehrt; dann ist ein Ersatz ungeeignet, und man kann als Bewertungskriterium festlegen, dass die End-to-End-Erfolgsrate auf demselben Aufgabensatz um nicht mehr als einen vorgegebenen Schwellenwert sinkt. Zweitens: Wenn die Last Kontext im Millionenbereich, multimodale Eingaben oder Mehrsprachigkeit erfordert: Mistral Large 4 unterstützt dem Bericht zufolge ein Kontextfenster von 1 Million Token und über 160 Sprachen, doch Gewichte und endgültige Bedingungen stehen noch nicht fest; daher sollte man in der API-Vorschauphase zunächst die Genauigkeit der Langkontext-Retrieval und die Leistung des visuellen Encoders auf eigenen Dokumenten prüfen, gemessen an der Genauigkeit bei Langkontext-Fragen und den Kosten pro Anfrage, und dabei das Verhalten der Vorschauversion nicht mit dem künftiger offener Gewichte gleichsetzen sowie bestehende Hauptmodelle als Rückfall behalten. Beide Regeln sollten erneut überprüft werden, sobald die Gewichte offiziell veröffentlicht und die Lizenz geklärt ist.
Grenzen und offene Fragen
Die Berichtsinhalte stammen überwiegend aus Herstellerangaben und vom Hersteller zitierten Dritttests; die Benchmark-Werte sind nicht unabhängig reproduziert und sollten nicht als gesicherte Schlussfolgerungen gelten. Besonders hervorzuheben ist: Der Originaltext nennt bei Humanity's Last Exam nur Beam 36,2, GLM-5.3 42,3 und Kimi K3 46,9, nicht aber einen HLE-Wert für DeepSeek V4.1 Flash; der HLE-Vergleich ist daher auf die tatsächlich im Text genannten GLM-5.3 und Kimi K3 zu beschränken, und die Zusammenfassung der drei Benchmarks zu 'liegt bei allen unter den drei Anbietern' wäre ein vom Text nicht gestützter benchmarkübergreifender Vergleich. Zudem haben weder Beam noch Mistral Large 4 einen entsprechenden Eintrag im aktuellen Modellkatalog von KimiSeek, d. h. diese beiden Versionen sind derzeit nicht bei KimiSeek gelistet; die im Bericht genannte API-Vorschau und der Plan zur Gewichtsveröffentlichung beziehen sich auf die Verfügbarkeit über die Kanäle der Hersteller und stehen in keinem Zusammenhang damit, ob KimiSeek sie anbietet. Die Verfügbarkeit von Gewichten ist nicht gleichbedeutend mit einer Open-Source-Lizenz; der Bericht nennt keine Lizenzbedingungen, und Rechte zur kommerziellen Nutzung und Weitergabe richten sich nach der tatsächlich vom Hersteller veröffentlichten Lizenz. Dem Bericht zufolge sollen Beams Gewichte im Oktober und die vollständigen Gewichte von Large 4 Ende Oktober erscheinen; zum Veröffentlichungszeitpunkt waren die Gewichte bei beiden noch nicht tatsächlich offen, und ob dies fristgerecht eintritt und wie sich die Bedingungen ändern, ist weiterhin unbekannt. Die Aussage 'etwa ein Viertel bis ein Drittel der Rechenleistung' ist eine Selbstauskunft von Reflection ohne unabhängige Messgrundlage; die tatsächliche Wirkung eines Austauschs muss auf eigenen Workloads überprüft werden. Diese Kurzanalyse trifft keine Aussage darüber, ob die beiden Unternehmen künftige Roadmap- oder Geschäftsmodellversprechen einlösen werden.
Abbildungen aus dem Originalbericht