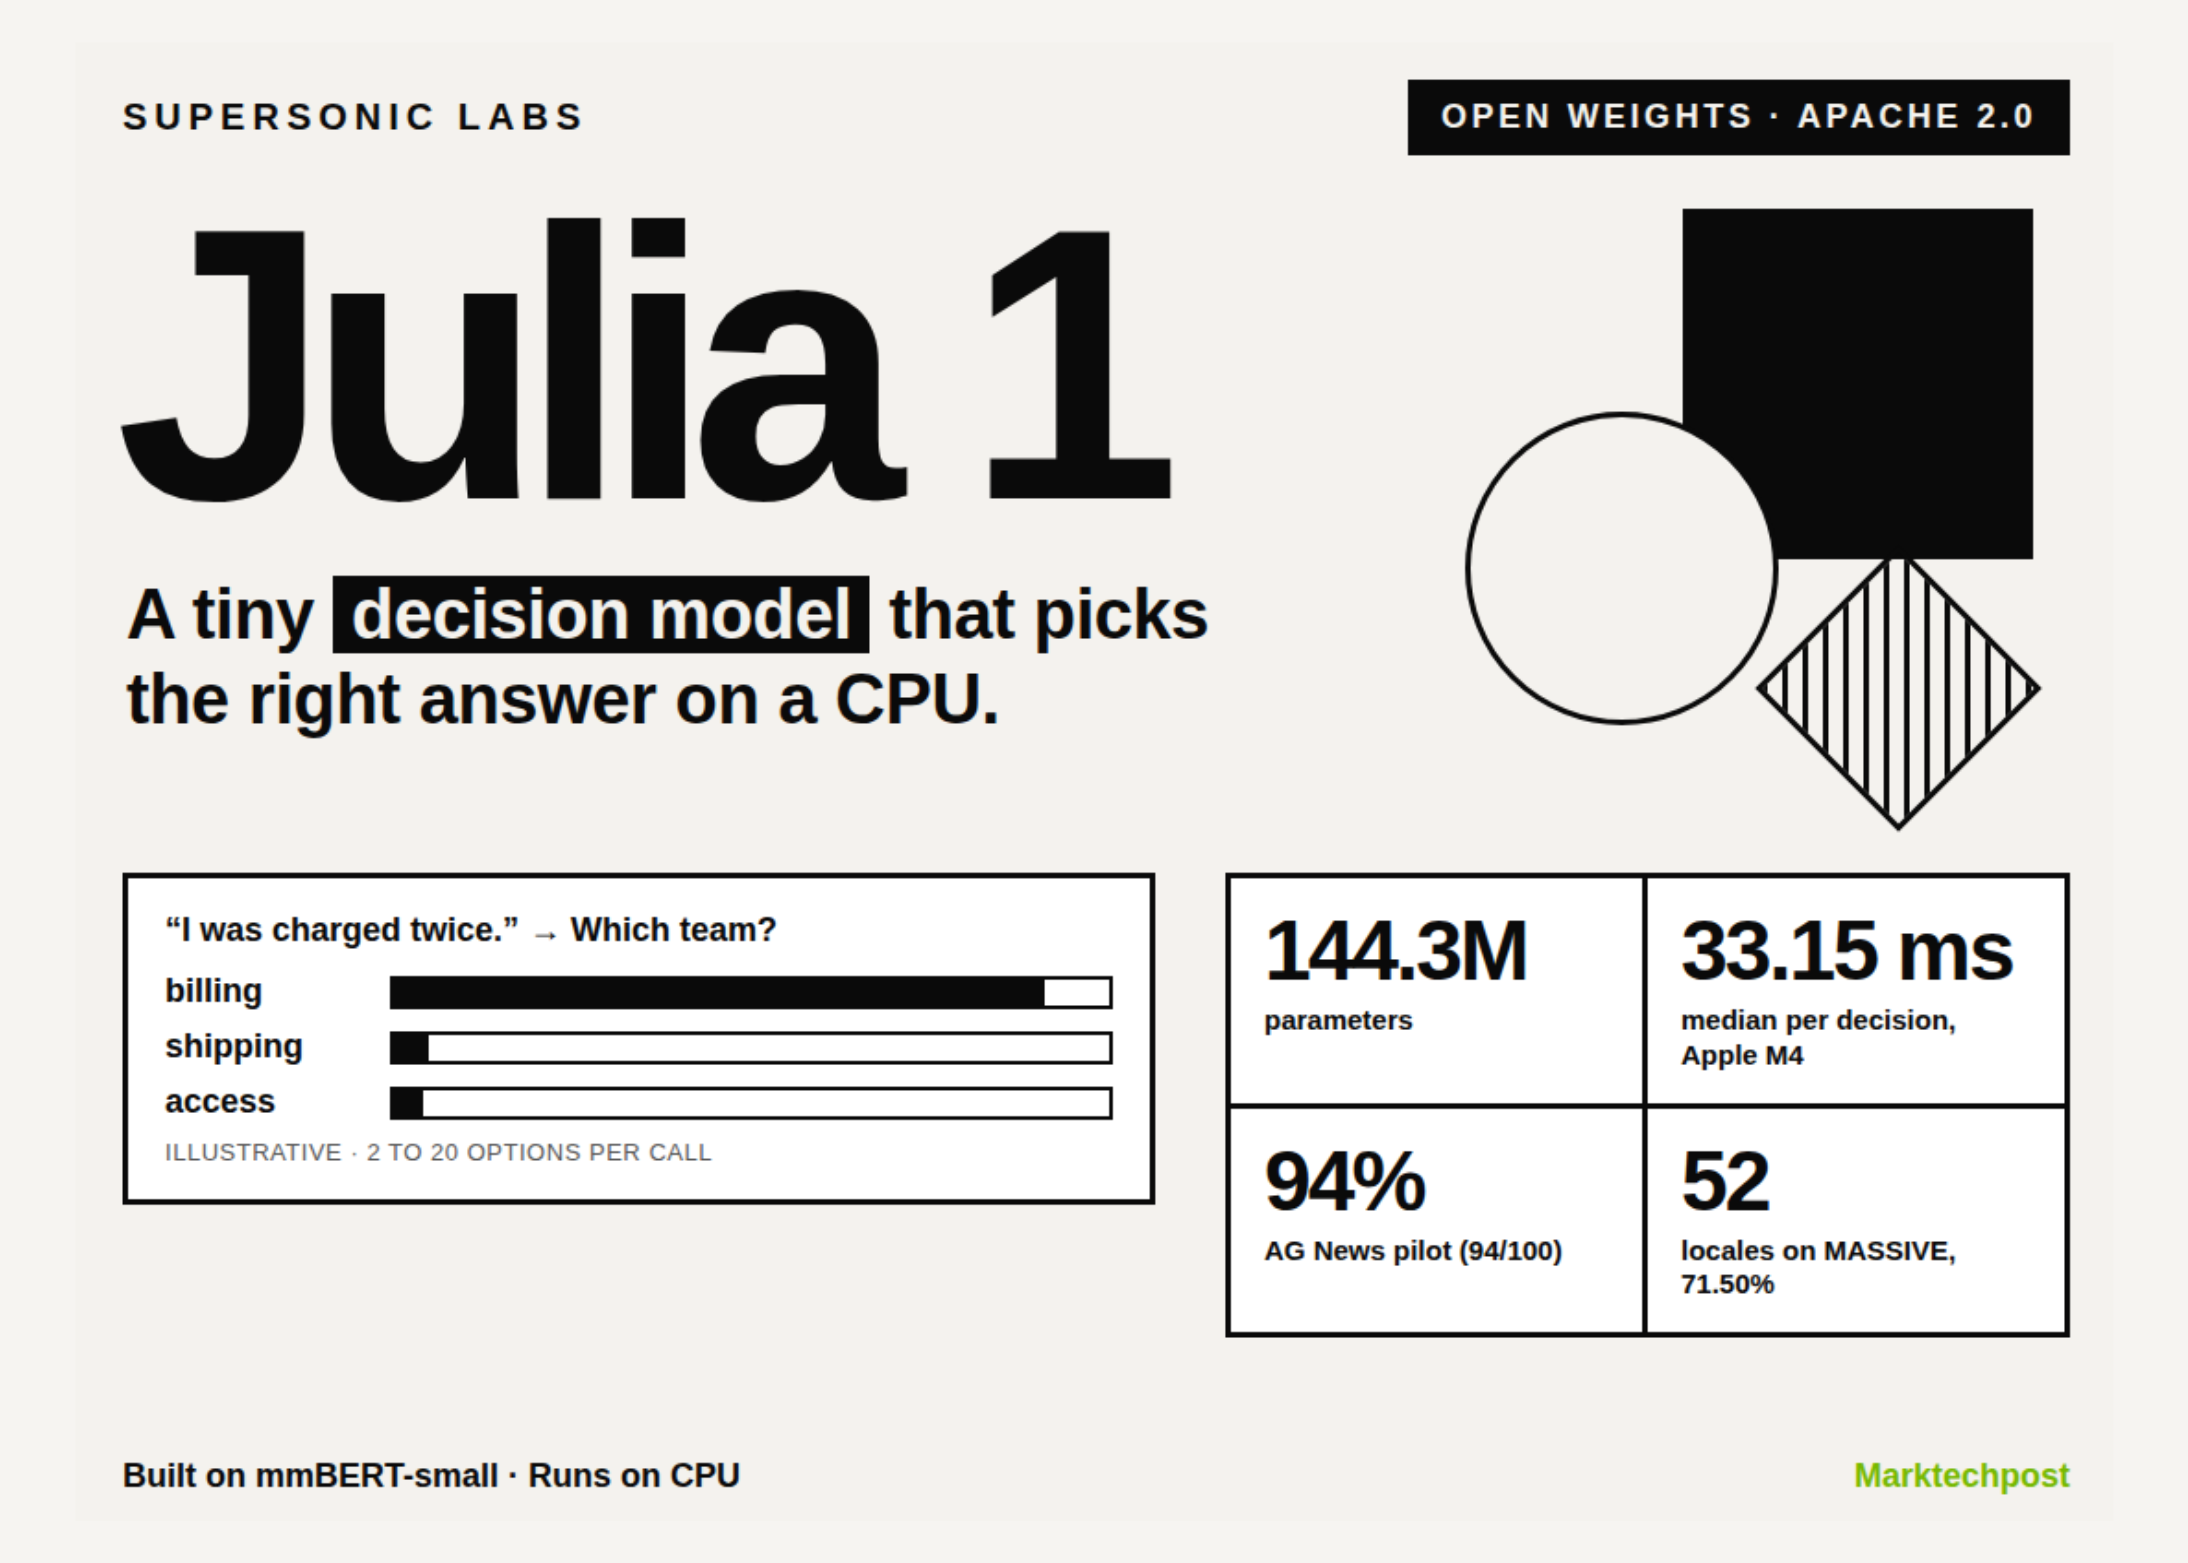
Supersonic Labs veröffentlicht Julia 1: 144,3-Mio.-Parameter-Entscheidungsmodell unter Apache 2.0, lokal auf CPU ausführbar
Laut einem Bericht von MarkTechPost vom 26. September 2026 hat das brasilianische Supersonic Labs Julia 1 veröffentlicht, ein auf mmBERT-small basierendes Entscheidungsmodell mit 144,3 Millionen Parametern, dessen Gewichte unter Apache 2.0 bereitgestellt werden, das die Aufruftypen choice, score und noul unterstützt und lokal auf der CPU ausgeführt werden kann. In den Versuchen übertraf es die Jev-Referenzwerte bei Typed Decisions, AG News und DAIR Emotion, lag aber bei Banking77 mit 72 Labels deutlich zurück; eine gehostete API wurde angekündigt, ist aber noch nicht geöffnet.

Was sich geändert hat
Laut einem Bericht von MarkTechPost vom 26. September 2026 hat das kleine brasilianische Labor Supersonic Labs Julia 1 veröffentlicht (Hinweis: Diese Version ist derzeit nicht im KimiSeek-Katalog aufgeführt; die im Bericht genannte API-Verfügbarkeit bezieht sich auf die Anbieterseite). Es handelt sich um ein Entscheidungsmodell, nicht um ein Chat-Modell: Aufrufer übergeben Kontext, Frage und 2 bis 20 beschriebene Antwortkandidaten; das Modell gibt in der vorgegebenen Reihenfolge die gewählte Option samt vollständigen Softmax-Wahrscheinlichkeiten zurück, die Aufrufer-ID wird unverändert weitergegeben, freier Text wird nicht erzeugt. Die Gewichte werden unter Apache 2.0 auf Hugging Face veröffentlicht (verfügbare Gewichte bedeuten nicht automatisch eine Open-Source-Lizenz; hier nennt die Quelle ausdrücklich Apache 2.0), laufen unter Python 3.11+ auf CPU oder einer BF16-fähigen GPU, außerdem gibt es einen ONNX-Build, der über WebGPU im Browser laufen kann; eine gehostete API wurde angekündigt, ist aber noch nicht geöffnet. Das Modell basiert auf dem mmBERT-small-Encoder des JHU CLSP plus einem Entscheidungskopf; das Labor stellt ausdrücklich klar, dass es sich nicht um ein Fine-Tuning von Qwen handelt. Zur Laufzeit liegt die zusammengeführte Token-Obergrenze bei 8.192, die öffentlichen Benchmarks nutzen 1.024. Die drei Aufruftypen sind choice (Klassifikation, Routing), score (geordnete Bewertung, die den erwarteten Index zurückgibt) und noul (Wahrscheinlichkeit, ob etwas wahr ist). Die im Bericht genannte Evaluierung vom 24. September 2026 lief auf H200 mit BF16 im strikten Encoding-Verfahren und verglich mit Referenzwerten des TypeSafe-Jev-Benchmark-Protokolls statt mit einem erneuten Jev-Durchlauf: Typed Decisions 73,15 % (Referenz 72,70 %), AG News 94/100 (Referenz 91 %), DAIR Emotion 86/100 (Referenz 48 %), Banking77 nur 64/100 (Referenz 87 %), MASSIVE über 52 Sprachregionen mit makro-arithmetischem Mittel 71,50 %, pt-PT 86,25 %, en-US 86,75 %. Jeder Klassifikationsversuch umfasste nur 100 Beispiele. Ein CPU-Lauf vom 25. September reproduzierte Typed Decisions 72,55 % und Banking77 60/100 und hatte drei Verweigerungen. Zur Latenz berichtet die Quelle für Apple M4 einen Median von 33,15 Millisekunden pro Entscheidung, für das Samsung-Tablet SM-X510 über ONNX Runtime einen Median von 203 Millisekunden bei einem Spitzen-RSS von 393,1 MB, auf Intel Core i5-1235U für AG News einen Median von 107,83 Millisekunden, während Banking77 wegen der vorherigen Eingrenzung von 72 Labels 3.713,54 Millisekunden benötigt.
Auswirkungen für Entwickler
Für Entwickler bedeutet das konkret: Es entsteht ein optionaler Weg, "Klassifikation/Routing/Scoring" aus großen Modellen herauszulösen und auf kleine Modelle am Endgerät zu verlagern. 144,3 Millionen Parameter, bei FP32 rund 550,5 MiB Gewichte, bedeuten, dass es in Smartphones, Tablets, Notebooks oder sogar Browser passt, ohne für jeden Klassifikationsaufruf zu zahlen oder online zu sein; der im Bericht geplante API-Preis liegt bei 0,025 USD pro Million Input-Token, doch diese API ist noch nicht geöffnet, und der Preis stammt aus der Berichterstattung vom September 2026, sodass Leser den aktuellen Preis über die neueste Anbieterseite und nicht über diesen Text bestätigen sollten. Gleichzeitig muss man die Leistungsgrenzen klar sehen: Es vergleicht nur zwischen den vorgegebenen Kandidaten, kann fehlende Fakten nicht ergänzen, keine Algebra oder mehrstufigen Berechnungen ausführen; der Router kann beim Eingrenzen korrekte Labels verwerfen, und es ist kein Baustein, der bestehende Transformers-Pipelines direkt ersetzt; laut Bericht hostet kein Hugging-Face-Inference-Anbieter es. Auf der Benchmark-Ebene ist das wichtigste Signal nicht "drei Werte übertreffen Jev", sondern der starke Rückgang, wenn der Labelraum von 4 und 6 auf 72 wächst: AG News 94/100 gegenüber Banking77 64/100, und die CPU-Reproduktion nur 60/100, was zeigt, dass es eher für grobgranulare Entscheidungen mit wenigen Labels als für feingranulare Mehrfachklassifikation geeignet ist. Zudem stammt die Aussage "fünfmal schneller als Jev" im Bericht aus einem X-Post des Anbieters, während die Jev-Versuche Jev als gehosteten Dienst aus Frankreich aufriefen, die Latenzen also nicht unter gleichen Bedingungen gemessen wurden und nicht direkt übernommen werden sollten.
Integration und Bewertung
Das Folgende ist eine bedingte Analyse und Empfehlung auf Basis des Berichts, keine verifizierte Tatsache. Erste Entscheidung: Soll die Ausgabe des Modells direkt für Online-Auto-Routing verwendet werden? Im Bericht sind "je mehr Labels, desto schlechter" (Banking77 64/100, CPU 60/100) und "der Router kann Labels verlieren" zwei verschiedene Effekte, die getrennt behandelt werden müssen; wenn Ihr Szenario mehr als etwa zwanzig Labels umfasst und Fehlentscheidungen unwiderrufliche Aktionen wie Abbuchungen, Berechtigungen oder Rückerstattungen auslösen, sollten Sie die Modellausgabe nicht direkt ausführen, sondern eine zweite Prüfung oder manuelle Kontrolle einschalten; bei sehr wenigen Labels (etwa grobe Klassifikation mit bis zu 4 Klassen) und rückrollbaren Aktionen kann zunächst ein Canary-Start erfolgen. Messbares Bewertungskriterium: Vergleichen Sie an mindestens 200 selbst gezogenen echten Anfragen die Übereinstimmungsrate zwischen der vom Modell gewählten Option und manueller Annotation und erfassen Sie separat den Anteil, bei dem die richtige Antwort in der Router-Eingrenzungsphase ausgeschlossen wird. Zweite Entscheidung: Soll die Endgerät-Bereitstellung bestehende gehostete Klassifikationsaufrufe ersetzen? Die im Bericht genannten Gerätemessungen sind M4-Median 33,15 Millisekunden, SM-X510-Median 203 Millisekunden, i5-1235U bei AG News Median 107,83 Millisekunden, während Banking77 3.713,54 Millisekunden erreicht; das bedeutet, Kandidatenzahl oder Labelumfang sind die Voraussetzung für Machbarkeit. Wenn Ihre Anfragen überwiegend kurze Texte mit wenigen Labels sind und lokale Inferenz im Hundert-Millisekunden-Bereich ohne Netz akzeptabel ist, ist das Endgerät günstiger; bei großem Labelumfang oder Anforderungen an niedrige Latenz und hohe Nebenläufigkeit kann der CPU-Pfad am Endgerät nicht tragfähig sein. Messbares Bewertungskriterium: Belasten Sie auf Ihren Zielgeräten bei fester Eingabelänge die P50- und P95-Latenz sowie den Spitzenverbrauch (Referenzwert im Bericht: RSS 393,1 MB) je Entscheidungstyp und vergleichen Sie auf demselben Gerät mit der bestehenden Lösung. Dritte Entscheidung: Soll die Geschäftslogik jetzt auf die gehostete API umgestellt werden? Der Bericht sagt ausdrücklich, die API sei angekündigt, aber noch nicht geöffnet; derzeit ist also nur Selbsthosting möglich. Es empfiehlt sich, zunächst mit lokalen Gewichten eine kleine Validierung durchzuführen und erst nach Klärung von Verfügbarkeit, Ratenbegrenzung und Abrechnung auf der API-Seite über einen Wechsel zu entscheiden; Kapazitätsplanung sollte nicht auf dem geplanten Preis aus dem Bericht beruhen. Als Bewertungsschritte: zuerst Eingaben bis einschließlich 1.024 Token festlegen und Kandidaten nach der Berichtsdefinition konstruieren, einen Offline-Übereinstimmungstest durchführen, dann Gerätelasttests; erst wenn beide bestehen, in den Canary-Betrieb gehen.
Grenzen und offene Fragen
Die zentrale Einschränkung dieses Berichts sind Stichproben und Vergleichsmaßstab. Jeder Klassifikationsversuch umfasst nur 100 Beispiele; Typed Decisions hat zwar 2.000 Einträge, doch die übrigen Werte haben breite Konfidenzintervalle und tragen keine starken Schlussfolgerungen. Die Vergleichsbasis nutzt Referenzwerte aus dem Jev-Protokoll statt eines erneuten Jev-Durchlaufs in derselben Umgebung, und die Jev-Latenz wurde über einen grenzüberschreitenden Aufruf des gehosteten Dienstes gemessen, ist also mit dem lokalen Betrieb dieses Modells nicht vergleichbar; die Aussage "fünfmal schneller" des Anbieters bedarf daher unabhängiger Überprüfung. Die proprietäre Trainingspipeline des Modells ist nicht offengelegt, Datenzusammensetzung und mögliche Verzerrungen sind nicht prüfbar. Die CPU-Reproduktion vom 25. September zeigte drei Verweigerungen, was auf Verhaltensverschlechterung in schwacher Umgebung hindeutet. Die im Bericht behauptete gehostete API war zum Zeitpunkt dieses Textes noch nicht geöffnet; der geplante Preis von 0,025 USD pro Million Input-Token stammt aus der Berichterstattung vom September 2026, Preise ändern sich, maßgeblich ist die Preisseite des Anbieters. Besonders hervorzuheben: Die Version Julia 1 ist derzeit nicht im KimiSeek-Katalog aufgeführt; die im Bericht genannte API-Verfügbarkeit bezieht sich auf die Planung des Anbieters und hat nichts mit der KimiSeek-Plattform zu tun. Außerdem fehlen im Bericht Details wie Formulierung der Kandidatenantworten, Reihenfolgeempfindlichkeit und mehrsprachige Stabilität (MASSIVE nennt nur das Makromittel und zwei Sprachregionen), die die tatsächliche Leistung beeinflussen können und von Lesern selbst getestet werden müssen.
Abbildungen aus dem Originalbericht