Underdog veröffentlicht Saluki 27B: 7,89 GB großes 2-Bit-Qwen3.8-27B mit besserem Tool-Calling als das Original
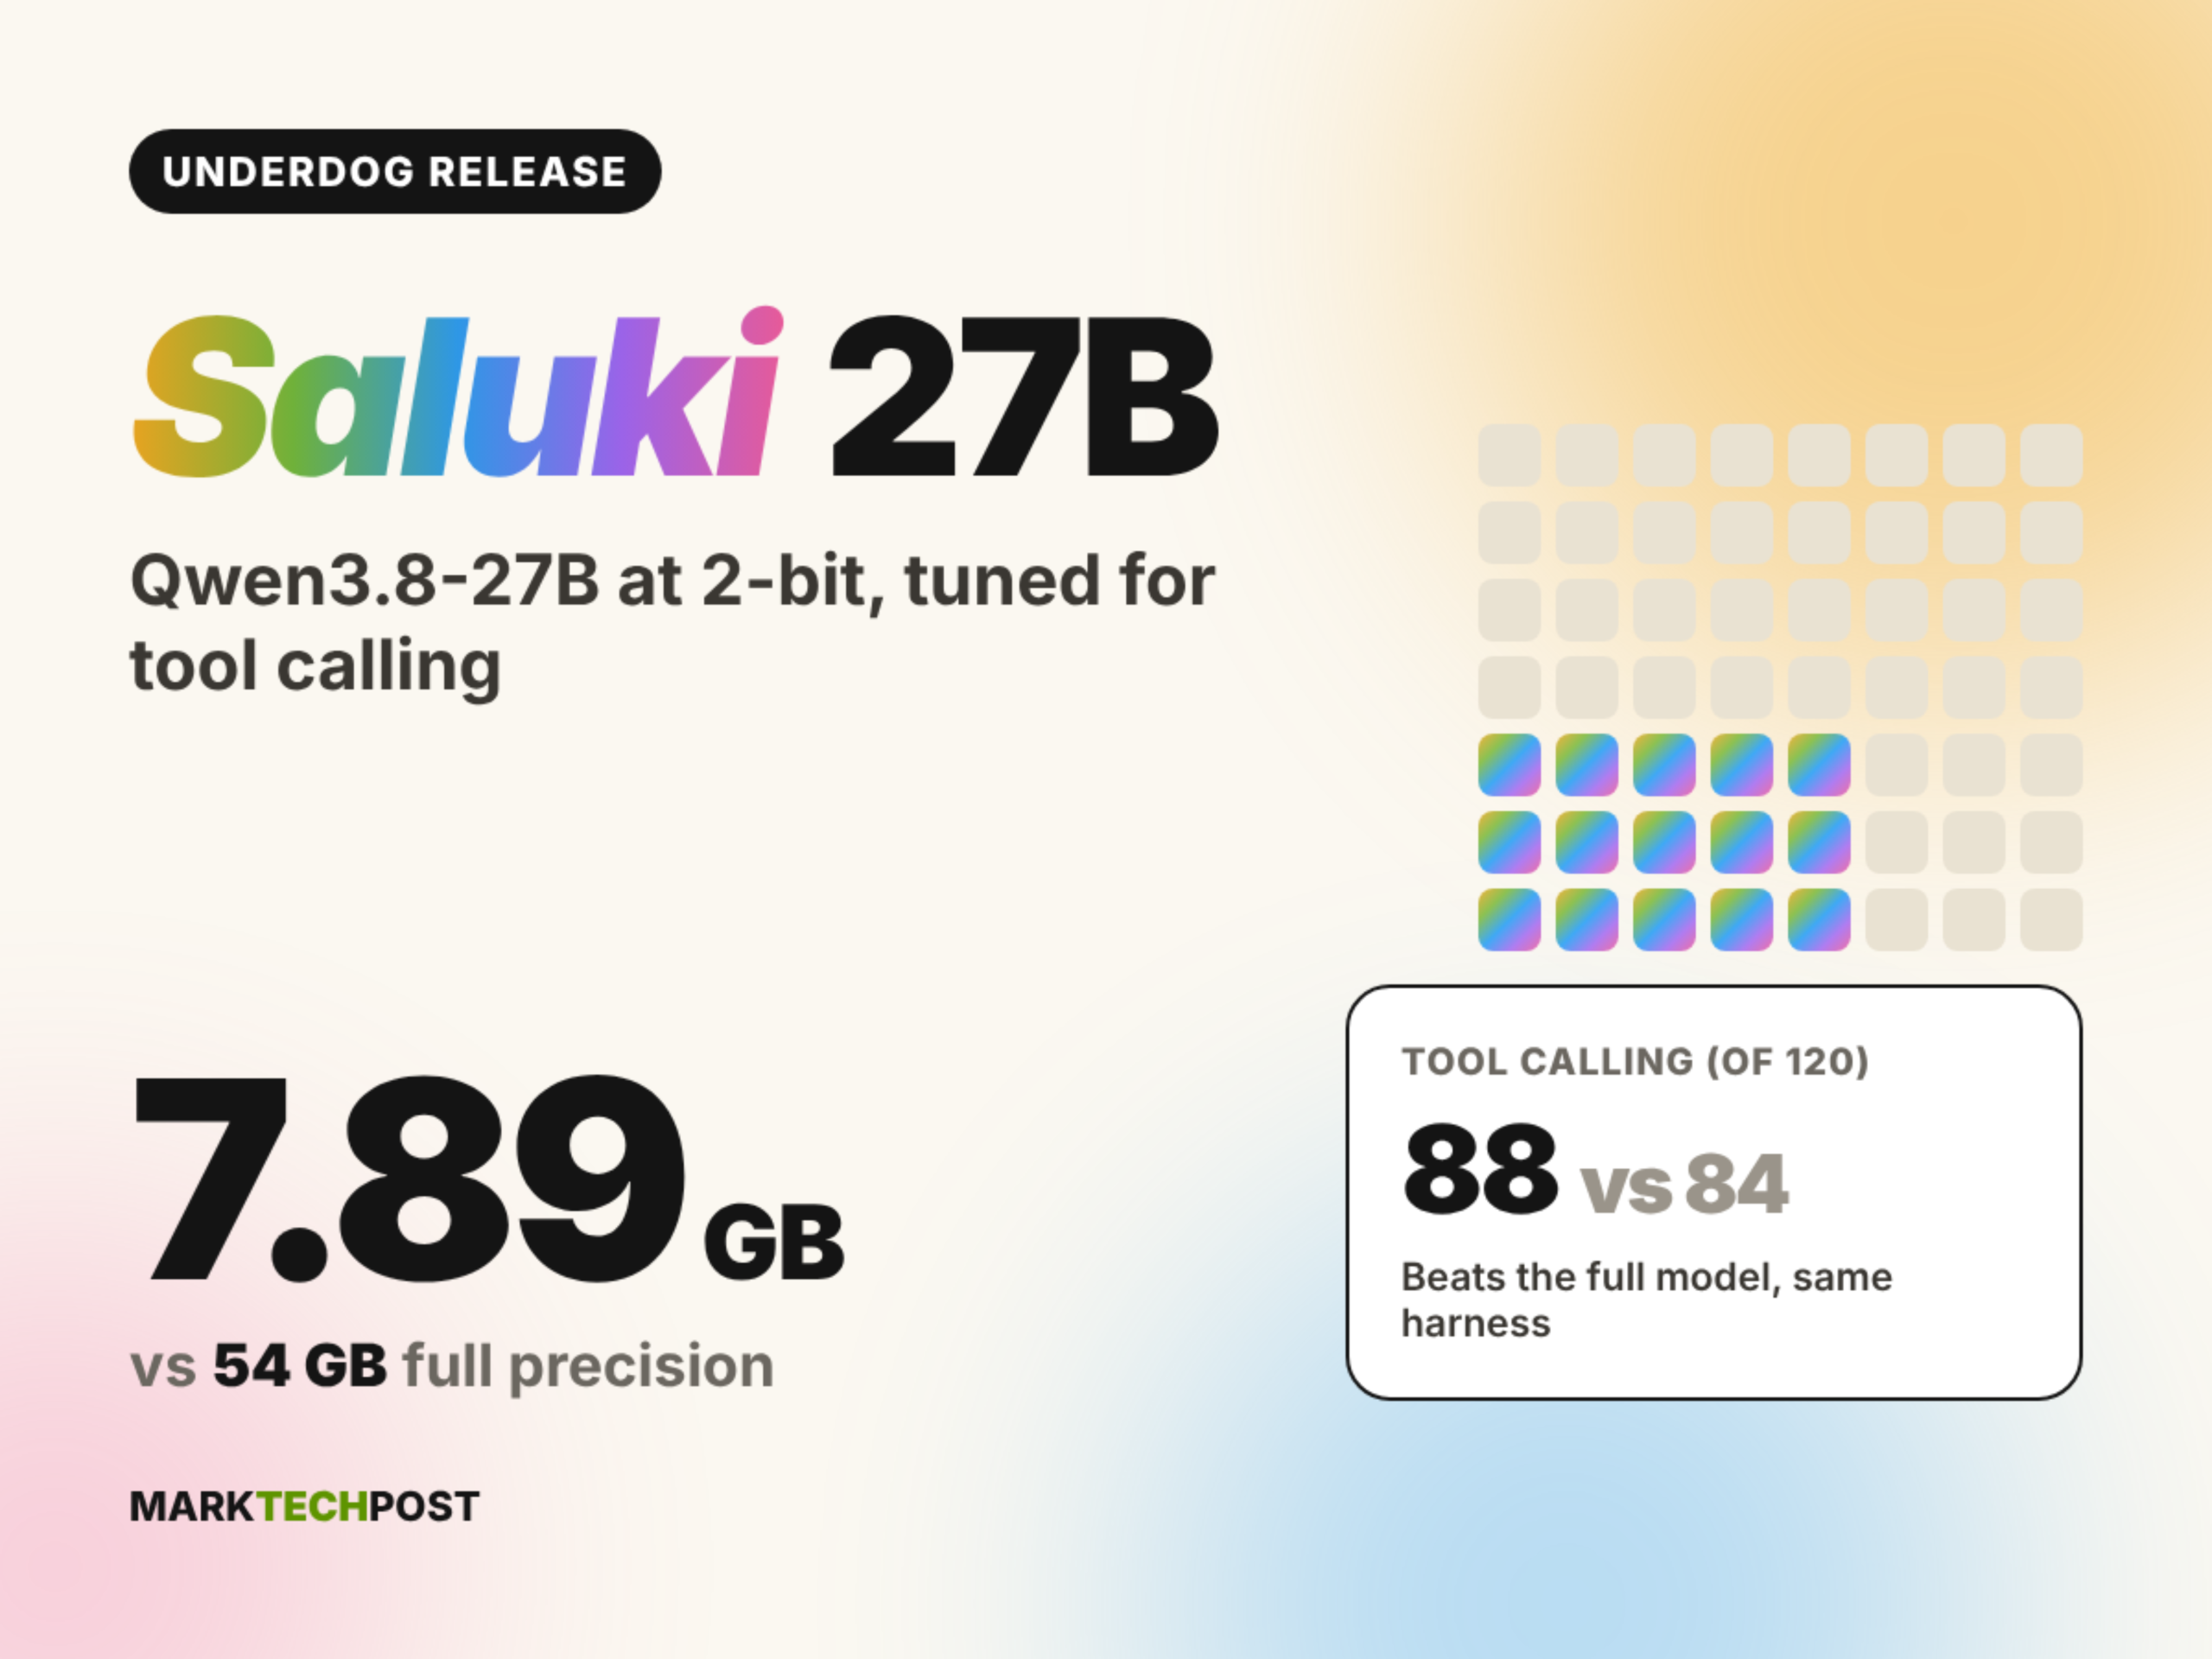
Laut einem Bericht von MarkTechPost vom 9. Oktober 2026 hat Underdog, ein Projekt von Conway Research, Saluki 27B unter Apache 2.0 veröffentlicht. Es komprimiert das 54 GB große Qwen3.8-27B auf ein 7,89 GB großes 2-Bit-Hybrid-GGUF, das in unverändertem llama.cpp läuft; beim Tool-Calling übertrifft es das Original, liegt aber bei Wettbewerbsmathematik und mehrstufigem Reasoning 12 bis 18 Punkte darunter.
Was sich geändert hat
Laut einem Bericht von MarkTechPost vom 9. Oktober 2026 hat Underdog, das Endgeräte-Assistenzprojekt von Conway Research, Saluki 27B unter der Apache-2.0-Lizenz veröffentlicht. Das Modell ist eine 2-Bit-GGUF-Version mit gemischter Präzision von Qwen3.8-27B, die Datei umfasst 7,89 GB, während das vollständige BF16-Modell 54 GB groß ist. Der Bericht beschreibt den Aufbau als drei aufeinander aufbauende Ebenen: die Basis ist das 27B-Dense-Modell Qwen3.8-27B des Qwen-Teams (64 Schichten, Mischung aus Gated DeltaNet linearer Attention und gated Attention, native 262.144 Tokens); darüber liegt das GSQ-RCO-GGUF von ISTA-DASLab, dessen kleinste Datei IQ2_XS 8,4 GB groß ist und durchschnittlich 2,50 Bit pro Gewicht umfasst; Underdog nimmt dann eigene Komprimierung und Tool-Calling-Optimierung vor und erzeugt Dateien namens IQ2-mix mit imatrix-Kennzeichnung, doch der Bericht weist darauf hin, dass Underdog das vollständige Rezept für diesen Schritt noch nicht veröffentlicht hat. Zur Laufzeit heißt es in dem Bericht, dass das Modell direkt in unverändertem llama.cpp und darauf basierenden Anwendungen läuft und vollständiges GPU-Offload unterstützt, daneben gibt es optionale visuelle Zusatzmodule mit 629 MB oder 928 MB. Zu den Benchmarks nennt der Bericht zwei von Underdog selbst angegebene Ergebnispakete: in einem Vergleich im selben Framework wie das vollständige Modell erzielt Saluki im Underdog Bench (120 Aufgaben aus BFCL v4, Denkmodus deaktiviert, Temperatur 0) 88 Punkte, das vollständige Modell 84 Punkte; parallele Tool-Aufrufe 42 zu 35; bei SWE-bench Verified werden von 50 Issues 30 gegenüber 33 behoben. Im Vergleich mit öffentlichen Ergebnissen voller Größe: IFEval 93,5 zu 91,5, IFBench 72,7 zu 71,0, MBPP+ 78,0 zu 83,9, MuSR 67,5 zu 79,6, AIME 2025 79,2 zu 96,7, AIME 2026 80,0 zu 94,6. Der Bericht führt zudem ISTA GSQ-RCO IQ2_XS und PrismML Bonsai 2 27B als Vergleichspunkte auf und betont, dass die Anbieter jeweils eigene Testframeworks verwenden und anbieterübergreifende Ergebnisse nicht direkt vergleichbar sind; Bonsai 2 ist kleiner, benötigt aber den llama.cpp-Fork von PrismML.
Auswirkungen für Entwickler
Für Entwickler, die lokale Agenten benötigen, ist die wesentliche Veränderung dieser Meldung: Ein Tool-Calling-Modell der 27B-Klasse, dessen Gewichte auf weniger als 8 GB quantisiert sind und das ohne Drittanbieter-Fork von llama.cpp geladen werden kann. Das verändert direkt die Einschätzung von VRAM- und Deployment-Hürden – vollständiges Offload auf einer einzelnen Consumer-GPU oder sogar auf einer Maschine mit viel Arbeitsspeicher wird realistisch, und hybride Architekturen aus lokaler Agentenschleife plus entferntem Modell als Rückfall werden kostenseitig besser kalkulierbar. Allerdings muss zwischen offenen Gewichten und Lizenzrechten unterschieden werden: Der Bericht gibt an, dass die Datei unter Apache 2.0 veröffentlicht wurde; dies ist eine Aussage auf Lizenzebene, und ob eine kommerzielle Nutzung möglich ist, sollte weiterhin anhand der Modellkarte und des Lizenztextes geprüft werden. Die bloße Verfügbarkeit der Gewichte bedeutet nicht, dass der Umfang der Lizenzrechte geklärt ist. Noch stärker zu beachten ist die ungleichmäßige Fähigkeitsverteilung: Der Bericht gibt an, dass Tool-Calling- und Instruction-Following-Metriken nahe am Original liegen oder dieses leicht übertreffen, während Mathematik- und mehrstufige Reasoning-Metriken wie AIME und MuSR um 12 bis 18 Punkte sinken. Das bedeutet, dass die quantisierte Version für Tool-Orchestrierung, Funktionsauswahl und formatgebundene Lasten geeignet ist, aber nicht als Hauptmodell fürs Reasoning dienen sollte. Zudem stammen alle Ergebnisse aus Selbsttests von Underdog oder den von ihm zitierten Anbietern, und verschiedene Anbieter nutzen unterschiedliche Testframeworks; es handelt sich um weitergegebene Angaben, nicht um unabhängige Reproduktionen, und anbieterübergreifende Ranglisten sollten als nicht vergleichbar gelten. Der Bericht veröffentlicht weder Bits pro Gewicht noch Kontextlänge noch das Komprimierungsrezept; diese Unbekannten beeinflussen die tatsächliche Leistung bei langem Kontext und bei paralleler Verarbeitung.
Integration und Bewertung
Empfehlung eins (Tool-Calling-Routing): Ob Saluki 27B als lokale Schicht für Funktionsauswahl und Parametergenerierung in Agenten eingesetzt wird, hängt davon ab, ob Ihre Last vor allem aus parallelen Tool-Aufrufen und strukturierter Ausgabe besteht. Wenn Ihr Szenario einzelne oder wenige parallele Aufrufe mit strengen Formatvorgaben umfasst, können Sie den lokalen Betrieb priorisieren, da der Bericht für die Metriken zu parallelen Tool-Aufrufen und Instruction-Following Werte nahe am Original oder darüber angibt; wenn Ihre Last von langen mehrstufigen Planungsketten abhängt, sollten Sie das Original oder ein stärkeres Modell als Rückfall behalten, da der Bericht für MuSR und AIME deutliche Rückgänge angibt. Messbarer Bewertungsmaßstab: Führen Sie auf Ihrem eigenen Tool-Schema denselben Satz eingefrorener Aufgaben aus und vergleichen Sie die Genauigkeit der Tool-Namensauswahl und die JSON-Gültigkeitsrate der Parameter zwischen Saluki und dem Original (oder dem bestehenden Online-Modell) sowie die Aufgabenabschlussrate in Szenarien mit parallelen Aufrufen. Empfehlung zwei (Auswahl des Komprimierungsansatzes): Die Wahl zwischen Kandidaten im selben 2-Bit-Bereich hängt davon ab, ob Sie bereit sind, eine nicht originale Laufzeitumgebung zu pflegen. Der Bericht gibt an, dass Saluki in unverändertem llama.cpp läuft, während PrismML Bonsai 2 dessen llama.cpp-Fork benötigt; das wirkt sich direkt auf Build-, Upgrade- und CI-Komplexität aus. Zugleich heißt es im Bericht, dass Saluki Bits pro Gewicht und Kontext nicht offenlegt, während die Vergleichslösung 2,50 Bit pro Gewicht und Dateigröße veröffentlicht. Wenn Ihr Team keine Abspaltung beim Inferenzframework wünscht, können Sie „lädt in unverändertem llama.cpp“ als harte Voraussetzung setzen und dann Größe und Genauigkeit vergleichen; wenn Größe die wichtigste Einschränkung ist, müssen Sie die Wartungskosten des Forks akzeptieren. Messbarer Bewertungsmaßstab: Erfassen Sie auf derselben Zielmaschine die Latenz bis zum ersten Token, den Spitzen-VRAM und die Stabilität bei langem Kontext (nahe Ihrer tatsächlichen maximalen Eingabelänge) und prüfen Sie die für das Laden der Datei erforderliche llama.cpp-Version. Empfehlung drei (Abnahme nach der Quantisierung): Unabhängig davon, welche Seite Sie wählen, sollte die Frage, ob nach der Quantisierung noch End-to-End-Aufgaben erledigt werden können, und nicht der Benchmark-Wert als Freigabeschwelle dienen. Messbarer Bewertungsmaßstab: Vergleichen Sie anhand einer Stichprobe Ihres echten Produktionsverkehrs die Anzahl bestandener Reparaturaufgaben, die Anzahl der Tool-Aufrufrunden und die Fehlerwiederholungsrate und legen Sie eine klare Rückfallschwelle fest, etwa einen automatischen Rückfall, wenn die End-to-End-Erfolgsrate unter einen akzeptablen Anteil des Originals fällt. Das Vorstehende sind bedingte Analysen und Empfehlungen, keine in dem Bericht enthaltenen Tatsachenbehauptungen.
Grenzen und offene Fragen
Zunächst ist klarzustellen: Das im Bericht genannte Saluki 27B (eine 2-Bit-GGUF-Ableitung von Qwen3.8-27B) erscheint derzeit nicht im Modellkatalog von KimiSeek; die im Bericht beschriebene Vertriebsform besteht darin, GGUF-Gewichte über Kanäle wie Hugging Face zu beziehen und lokal in unverändertem llama.cpp auszuführen, sie betrifft nicht die API-Verfügbarkeit auf der KimiSeek-Plattform, und jede Aussage zur API-Verfügbarkeit bezieht sich auf die eigenen Kanäle des Herausgebers. Zweitens sind alle im Text genannten Benchmark-Zahlen aus den Selbsttests von Underdog und den von ihm zitierten öffentlichen Ergebnissen übernommen; es handelt sich um Angaben des Herausgebers, und dieser Artikel hat keine unabhängige Reproduktion vorgenommen; auch der Bericht selbst weist darauf hin, dass die Anbieter eigene Testframeworks verwenden und anbieterübergreifende Ergebnisse nicht direkt vergleichbar sind. Drittens veröffentlicht der Bericht weder die Bits pro Gewicht der Datei noch die Kontextlänge noch das vollständige Rezept der dritten Komprimierungsebene, sodass die Leistung bei langem Kontext, bei Batch-Parallelität und auf unterschiedlicher Hardware weiterhin unbekannt ist. Viertens ist die Veröffentlichung der Gewichte unter Apache 2.0 eine Lizenzangabe aus dem Bericht; ob konkrete kommerzielle Bedingungen erfüllt sind, richtet sich nach der Modellkarte und dem Lizenztext, und die Verfügbarkeit der Gewichte bedeutet nicht, dass der Umfang der Rechte geklärt ist. Schließlich stammen auch die Angaben zu den Fähigkeiten der Qwen3.8-27B-Basis (64 Schichten, gemischte Attention, 262.144 nativer Kontext) aus diesem Bericht und wurden in diesem Artikel nicht überprüft.