Aleph Alpha publica Kolibri de pesos abiertos: MoE de 78.100 millones de parámetros y 3.460 millones activados por token
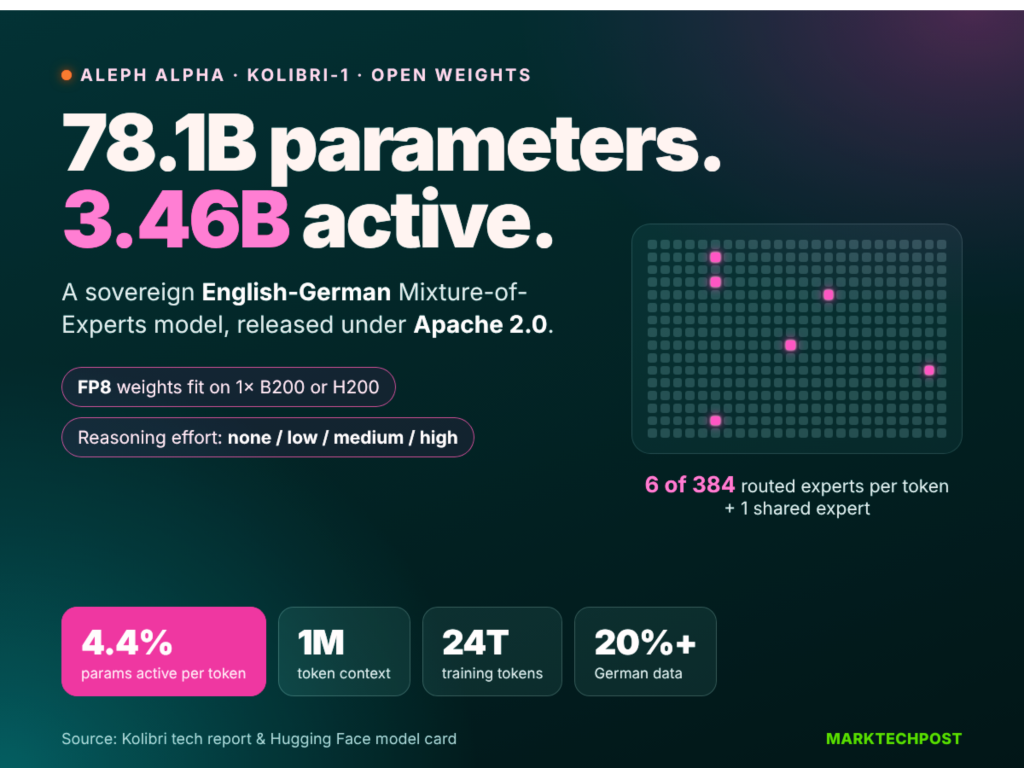
Según un reporte de MarkTechPost del 4 de octubre de 2026, Aleph Alpha publicó Kolibri-1, un modelo MoE bilingüe inglés-alemán de pesos abiertos, con 78.100 millones de parámetros totales y solo 3.460 millones activados por token, contexto de hasta 1.048.576 tokens y cuatro niveles de intensidad de razonamiento, distribuido bajo licencia Apache 2.0 en Hugging Face, con un checkpoint FP8 de unos 78 GB que puede servirse con vLLM en una sola B200 o H200.
Qué ha cambiado
Según un reporte de MarkTechPost del 4 de octubre de 2026, el equipo alemán Aleph Alpha publicó el modelo de pesos abiertos Kolibri (Kolibri-1), posicionado como un modelo de lenguaje de mezcla de expertos (MoE) bilingüe inglés-alemán, orientado a despliegues soberanos en sectores regulados como administración pública, industria y aeroespacial. El reporte indica 78.100 millones de parámetros totales y solo 3.460 millones activados por token (aproximadamente 4,4 %): cada capa MoE usa un router sigmoide para elegir top 6 entre 384 expertos enrutados, más 1 experto compartido, con balanceo de carga mediante Exact Quantile Balancing e inyección de error de carga. El modelo apila 50 bloques Transformer, con ancho 2560, atención de consultas agrupadas de 48 cabezas de consulta y 4 cabezas KV; cada quinto bloque es atención completa sin codificación posicional, y los otros 40 bloques usan atención de ventana deslizante que cubre los primeros 512 tokens junto con RoPE, por lo que solo 10 capas de caché KV crecen con el contexto. El límite de contexto reportado es de 1.048.576 tokens, y la intensidad de razonamiento puede fijarse por solicitud en ninguno, bajo, medio o alto. En entrenamiento, el reporte señala que el preentrenamiento cubrió 20T tokens en 768 NVIDIA B200, el entrenamiento medio 3,44T tokens (longitud de secuencia 65.536), la fase de contexto largo 201B tokens (longitud de secuencia 262.144), y se añadieron más de 2T tokens en alemán; el postentrenamiento combinó ajuste fino supervisado y aprendizaje por refuerzo sobre más de 1,2 millones de tareas internas. La licencia es Apache 2.0 y los pesos se publicaron en Hugging Face; el checkpoint FP8 de unos 78 GB puede usarse en una sola B200, B300 o H200, o en dos H100 SXM5, sirviéndose con vLLM junto con un parser de inferencia dedicado y un parser de llamadas a herramientas. Las comparaciones de benchmark del reporte muestran 75,5 en inglés general y 70,8 en alemán general, y 61,4 en BFCL v4, por debajo del Qwen3.5 comparado. Todos estos detalles de parámetros, benchmarks y despliegue son transcripciones del reporte original y del informe técnico, y aún no han sido reproducidos de forma independiente.
Impacto para desarrolladores
Desde la perspectiva del desarrollador, el valor de esta noticia se concentra en tres puntos. Primero, la combinación de licencia y autohospedaje: el reporte afirma que los pesos se publican bajo licencia Apache 2.0, lo que ofrece un margen de autorización más claro que la práctica común de “pesos abiertos pero con restricciones comerciales”, pero los términos de la licencia deben verificarse en la model card y el archivo de licencia del repositorio de Hugging Face, sin inferir derechos solo a partir de la transcripción del reporte; además, hay que tener en cuenta que la disponibilidad de los pesos no implica que los datos de entrenamiento, el tokenizador o el paquete de inferencia estén sujetos a la misma licencia. Segundo, la estructura de costos que surge de la dispersión: 78.100 millones de parámetros totales y 3.460 millones activados significan que el uso de memoria se calcula por los parámetros totales y el costo computacional por los parámetros activados; el reporte indica que el checkpoint FP8 de unos 78 GB puede ejecutarse en una sola B200/H200, lo que es un punto de partida viable de autohospedaje para equipos que ya tienen nodos de una tarjeta con mucha memoria, pero el rendimiento real y la concurrencia aún dependen del ancho de banda de memoria, la precisión de la caché KV y el tamaño de lote, y deben medirse por cuenta propia. Tercero, la atención híbrida y el contexto de un millón: las capas de ventana deslizante mantienen una caché KV fija y solo 10 capas crecen con el contexto, y el equipo afirma que con el mismo cómputo puede soportar secuencias cuatro veces más largas que un esquema de atención completa; si es cierto, la economía de contexto para documentos largos y RAG industrial sería claramente mejor que la de modelos densos de tamaño similar, pero se trata de una afirmación del fabricante y debe validarse el contexto efectivo en la propia distribución de documentos, no solo el número límite. Además, el enfoque bilingüe inglés-alemán y el tokenizador optimizado para alemán (el reporte indica 4,90 bytes por token en alemán, aproximadamente un 11,2 % menos de tokens que el tokenizador comparado) muestran que su ventaja está en el alemán; los negocios centrados en chino no deberían inferir capacidad en chino a partir de esto, ya que el reporte no ofrece evaluaciones en chino. Cabe aclarar que, al momento de esta verificación del catálogo, la versión Kolibri-1 no aparece en el catálogo de modelos en vivo de KimiSeek, por lo que la disponibilidad de pesos y servicio de inferencia mencionada en el reporte se refiere al lanzamiento de Aleph Alpha y Hugging Face, no a que este sitio ya lo ofrezca.
Integración y evaluación
Lo siguiente son recomendaciones y análisis condicionales, no hechos comprobados. Recomendación uno: decidir primero según licencia y cumplimiento, y después según rendimiento. La elección práctica es verificar el archivo LICENSE del repositorio de Hugging Face, las restricciones de uso en la model card y la licencia del propio paquete de inferencia aleph-alpha-inference, y luego decidir si se incorpora como dependencia de producción. Cuando la carga de trabajo implica procesamiento local de datos regulados y el equipo dispone de un nodo con memoria de nivel B200/H200, el autohospedaje aporta más valor que llamar a una API externa; si no se cumple ese requisito previo (por ejemplo, solo hay tarjetas de consumo o varias tarjetas de memoria media-baja), conviene abandonar según criterios cuantificables: que el checkpoint FP8 cargue correctamente en el hardware objetivo y dé salida estable es el umbral de aprobación; si falla la carga o exige ampliar memoria fuera de presupuesto, no se pasa a la siguiente ronda. Recomendación dos: antes de cambiar o incorporar, hacer una evaluación comparativa con los modelos actuales usando corpus propios en alemán o mixtos inglés-alemán. Las variables clave seleccionables son el nivel de intensidad de razonamiento (ninguno/bajo/medio/alto) y la precisión de la caché KV, porque cambian directamente el costo y la latencia por solicitud; cuando la tarea es extracción de documentos largos y se tolera más latencia en la respuesta, subir la intensidad puede aportar calidad, mientras que en preguntas y respuestas cortas de alta concurrencia conviene una intensidad baja con lotes más largos. El criterio de evaluación debe ser medible: sobre un conjunto fijo de 200 a 500 preguntas y respuestas de documentos largos en alemán, comparar la precisión y la latencia extremo a extremo por cada mil tokens de cada nivel, y adoptar el nivel superior solo si la mejora de precisión supera el aumento de latencia y costo. Recomendación tres: la capacidad de contexto largo debe validarse como “ventana efectiva” y no como límite máximo. La elección práctica es lanzar primero con el contexto predeterminado de 262.144 y luego abrir a ventanas mayores ajustando max-model-len y sobrescribiendo max_position_embeddings; el requisito previo es que la tarea realmente necesite dependencias continuas de más de un millón de tokens; si los resultados de recuperación de la tarea ya son inferiores a cien mil tokens, ampliar el límite solo elevará el costo de la caché KV. El criterio cuantificable es medir la recuperación de información clave en una gradiente de longitudes (por ejemplo, 32k, 128k, 512k); si hay una caída clara en cierta longitud, usar longitudes por debajo de ese punto como límite práctico. Recomendación cuatro: las llamadas a herramientas y los escenarios de agente deben someterse a pruebas de carga por separado. El reporte indica que su puntuación en BFCL v4 es inferior a la del modelo Qwen comparado, mientras que el promedio agéntico se acerca al de sus competidores, lo que sugiere que las diferencias pueden ser grandes según la subtarea de agente; la elección práctica es mantener el modelo actual como ruta principal de llamadas a herramientas y usar Kolibri para recuperación y generación en alemán, o al revés. El requisito previo es que el equipo ya tenga un conjunto de pruebas de regresión para llamadas a herramientas; el criterio cuantificable es la tasa de éxito de llamadas y la precisión de parámetros sobre el propio esquema de herramientas; si es notablemente inferior al modelo en uso, no se debe migrar la ruta principal.
Límites y cuestiones pendientes
Primero, debe señalarse con claridad que, al momento de esta verificación del catálogo, Kolibri-1 no aparece en el catálogo de modelos en vivo de KimiSeek; los pesos, el paquete de inferencia y los métodos de despliegue descritos aquí se refieren al lanzamiento de Aleph Alpha y su publicación en Hugging Face, y no significan que este sitio ya ofrezca el modelo; cualquier mención de disponibilidad de API en el reporte también se refiere solo al lado del fabricante y no debe entenderse como un servicio de este sitio. Segundo, todas las cifras de arquitectura, entrenamiento, benchmarks y despliegue provienen del reporte de MarkTechPost del 4 de octubre de 2026 y del informe técnico y la model card que transcribe, sin reproducción independiente; las comparaciones de benchmark usan configuraciones de evaluación propias del fabricante, y la comparabilidad transversal entre modelos es limitada, por lo que no deben ser la única base para la selección. Tercero, el reporte no ofrece detalles de validación independiente en chino, código o escenarios de contexto largo, y se desconoce la capacidad en idiomas fuera del enfoque bilingüe inglés-alemán; la afirmación de “cuatro veces la longitud de secuencia con el mismo cómputo” es una declaración del equipo y requiere verificación propia. Cuarto, Apache 2.0 es una declaración de licencia para los pesos publicados; su alcance concreto (pesos, tokenizador, paquete de inferencia, datos de entrenamiento) debe verificarse punto por punto en la licencia original y la model card, y no puede deducirse de “pesos abiertos” que todos los componentes tengan el mismo alcance de autorización. Quinto, que pueda ejecutarse en una sola tarjeta y que sea apto para producción son cosas distintas; la concurrencia máxima, el margen de memoria y el impacto de los niveles de intensidad de razonamiento en el costo deben medirse en el hardware objetivo. Sexto, los precios, límites y parámetros de muestreo recomendados en el reporte corresponden al momento de la publicación y pueden cambiar con versiones posteriores; se debe consultar el contenido más reciente en las páginas del fabricante y de Hugging Face.