Baidu presenta Apollo World: el modelo del mundo como examinador de la conducción autónoma y qué deben medir los desarrolladores
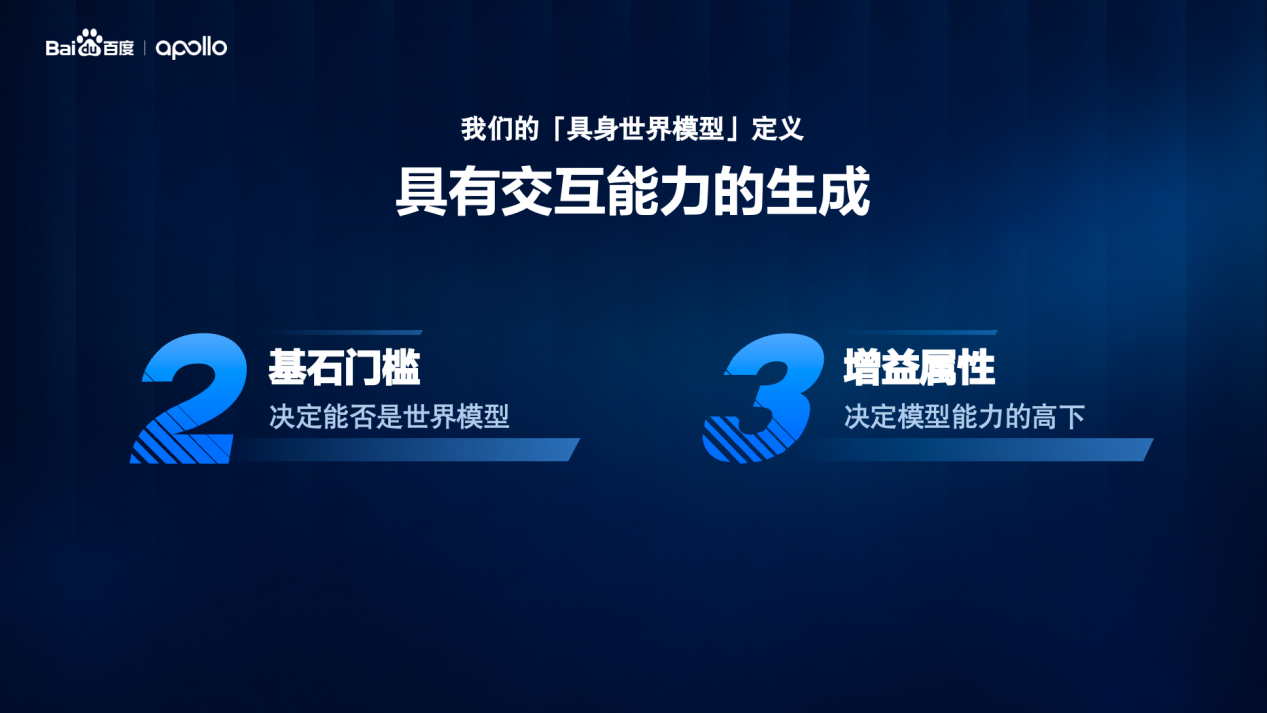
El 3 de noviembre, según el informe, en la sesión Apollo del AI Day de Shenzhen, Baidu presentó por primera vez Apollo World, un modelo del mundo para IA física, y propuso el criterio “2+3” —causalidad e interacción; precisión física, persistencia y tiempo real—. Según el informe, ya se usa en las pruebas globales de Apollo Go. Este artículo separa hechos reportados de inferencias y ofrece valoraciones condicionales sobre la base de simulación, los criterios de aceptación y el presupuesto de tiempo real.
Qué ha cambiado
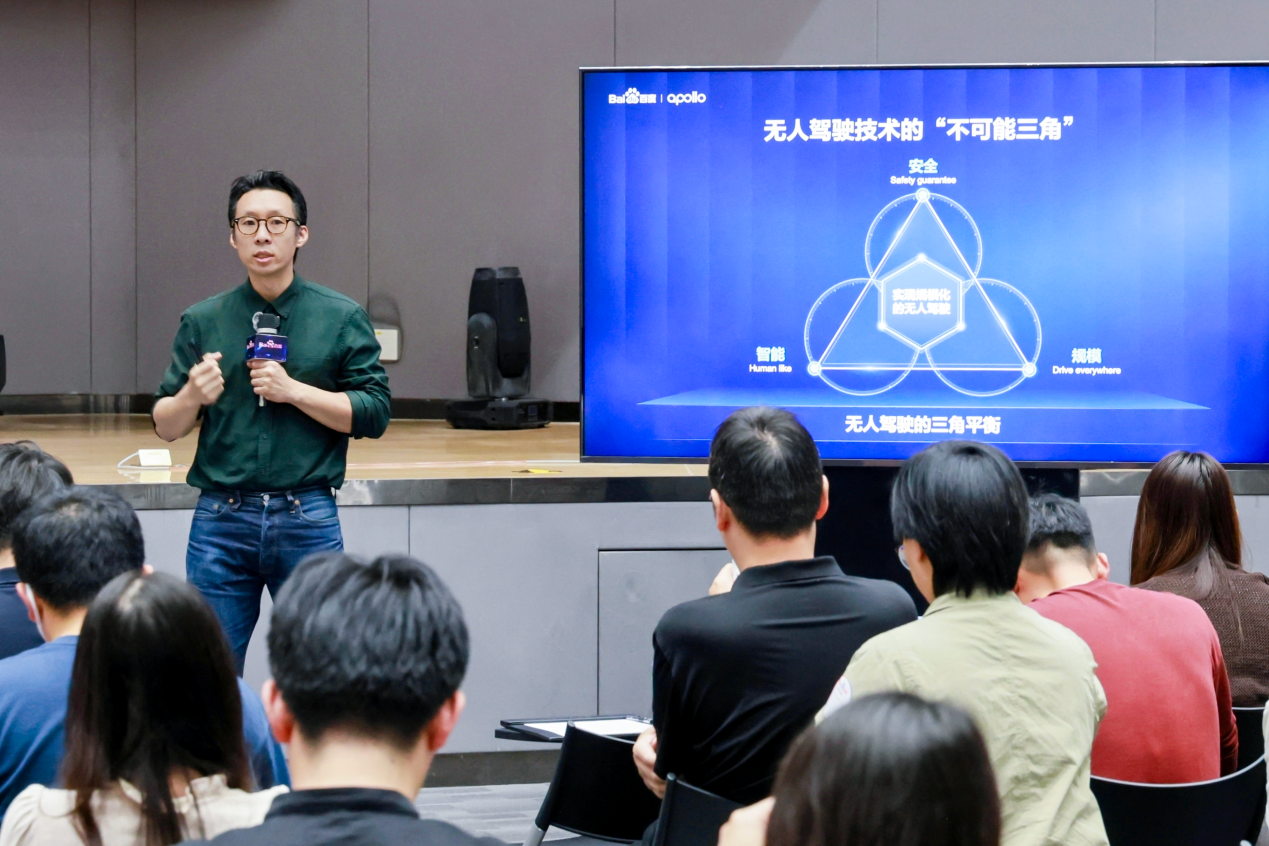
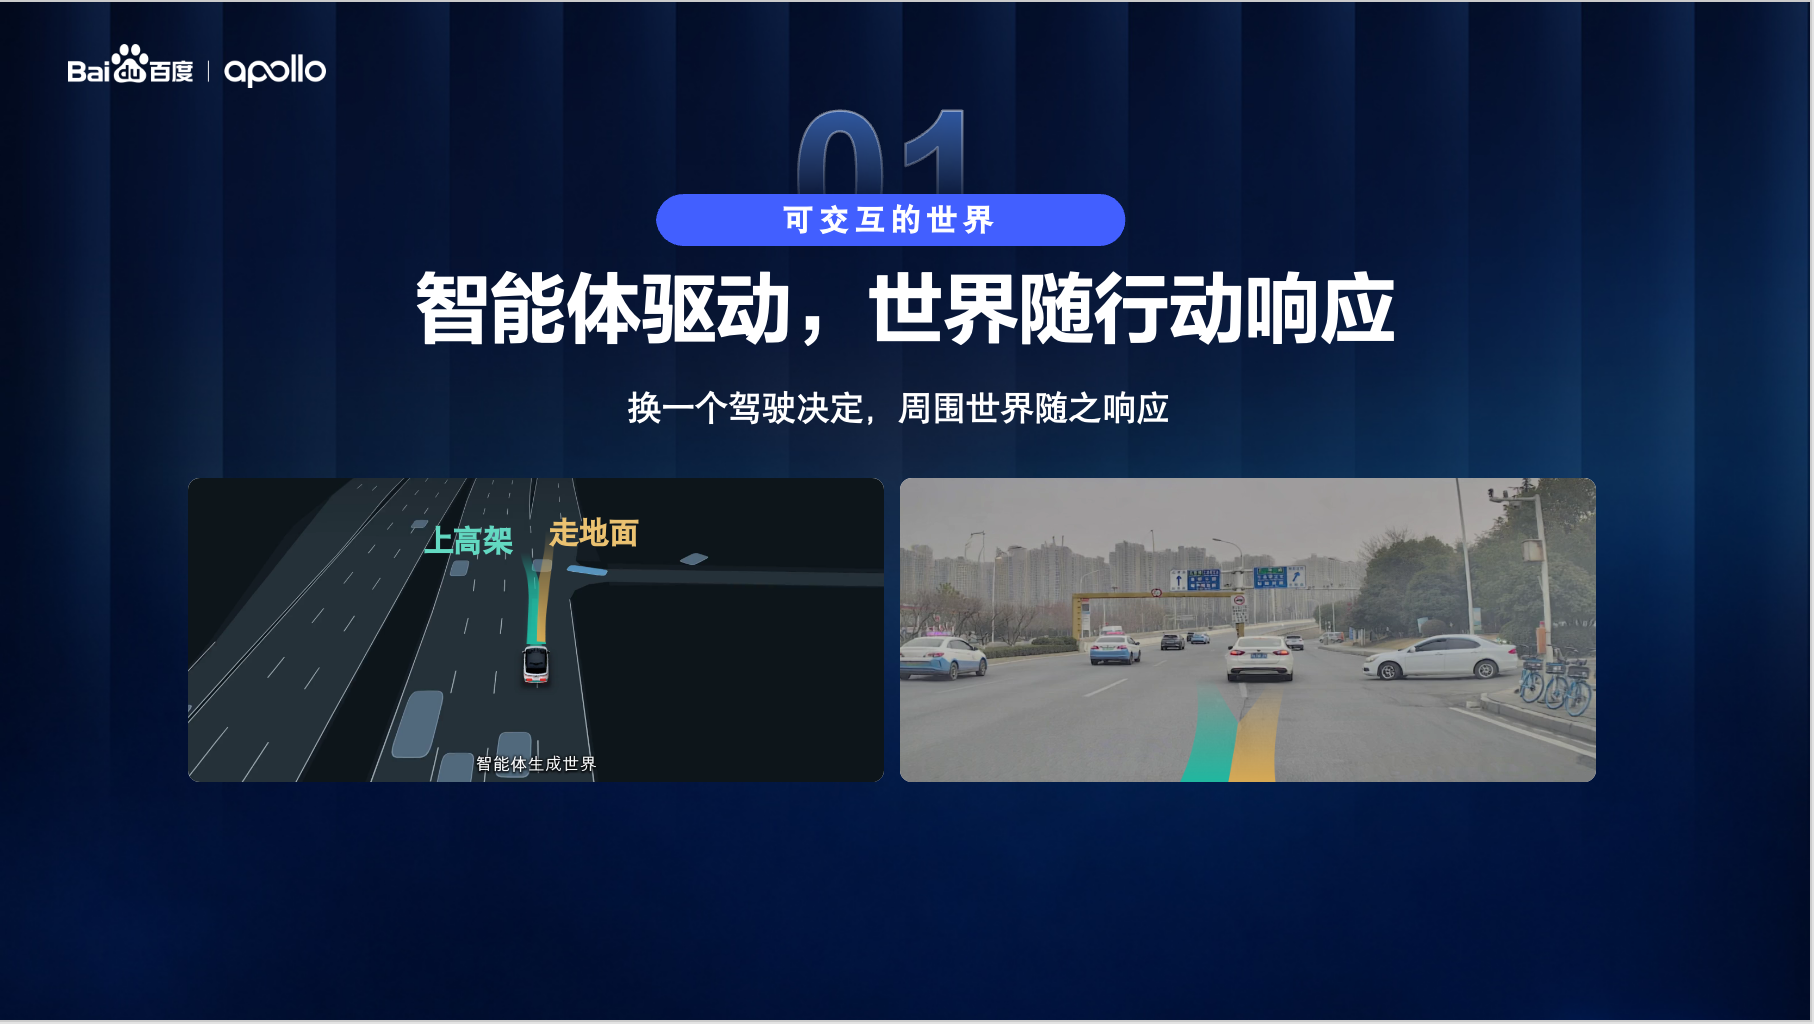
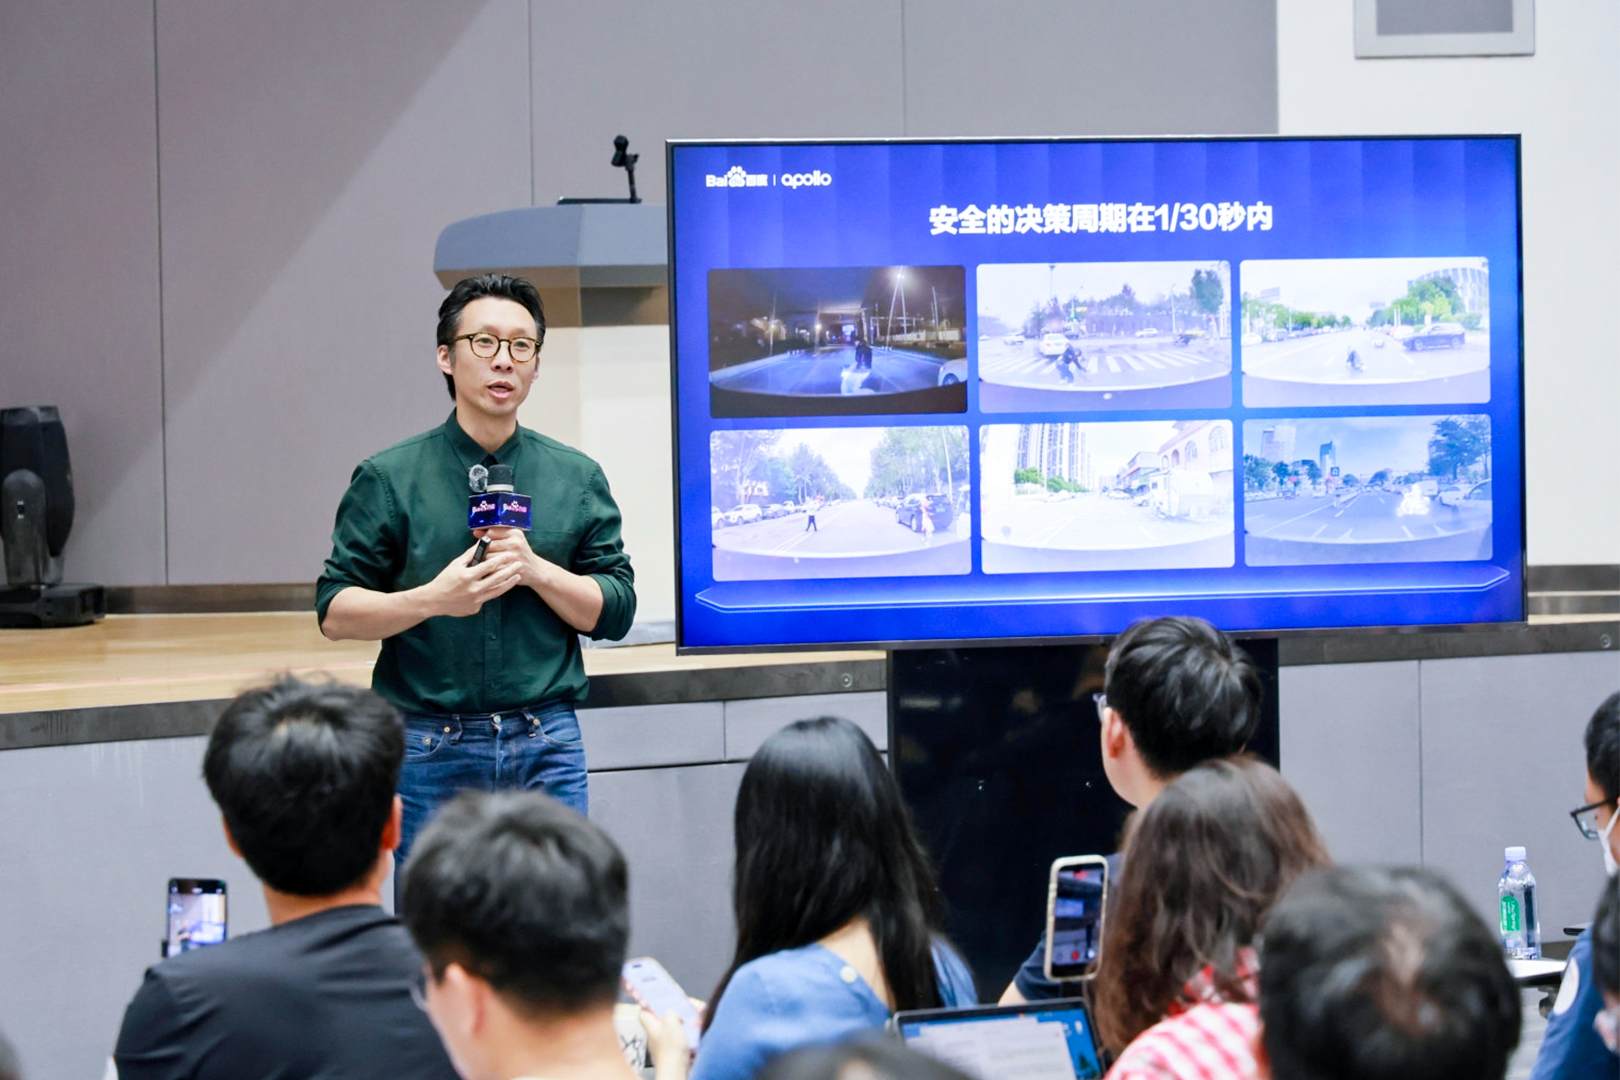
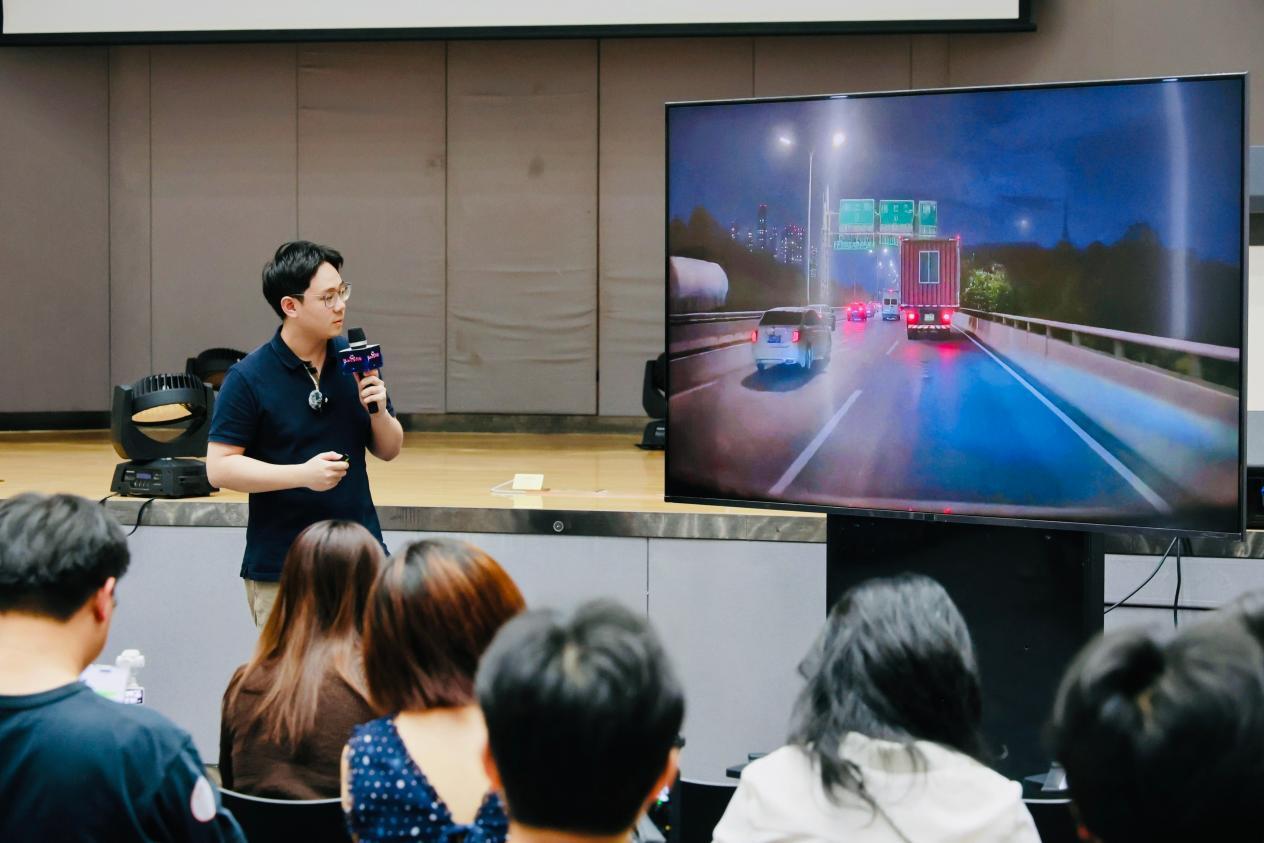
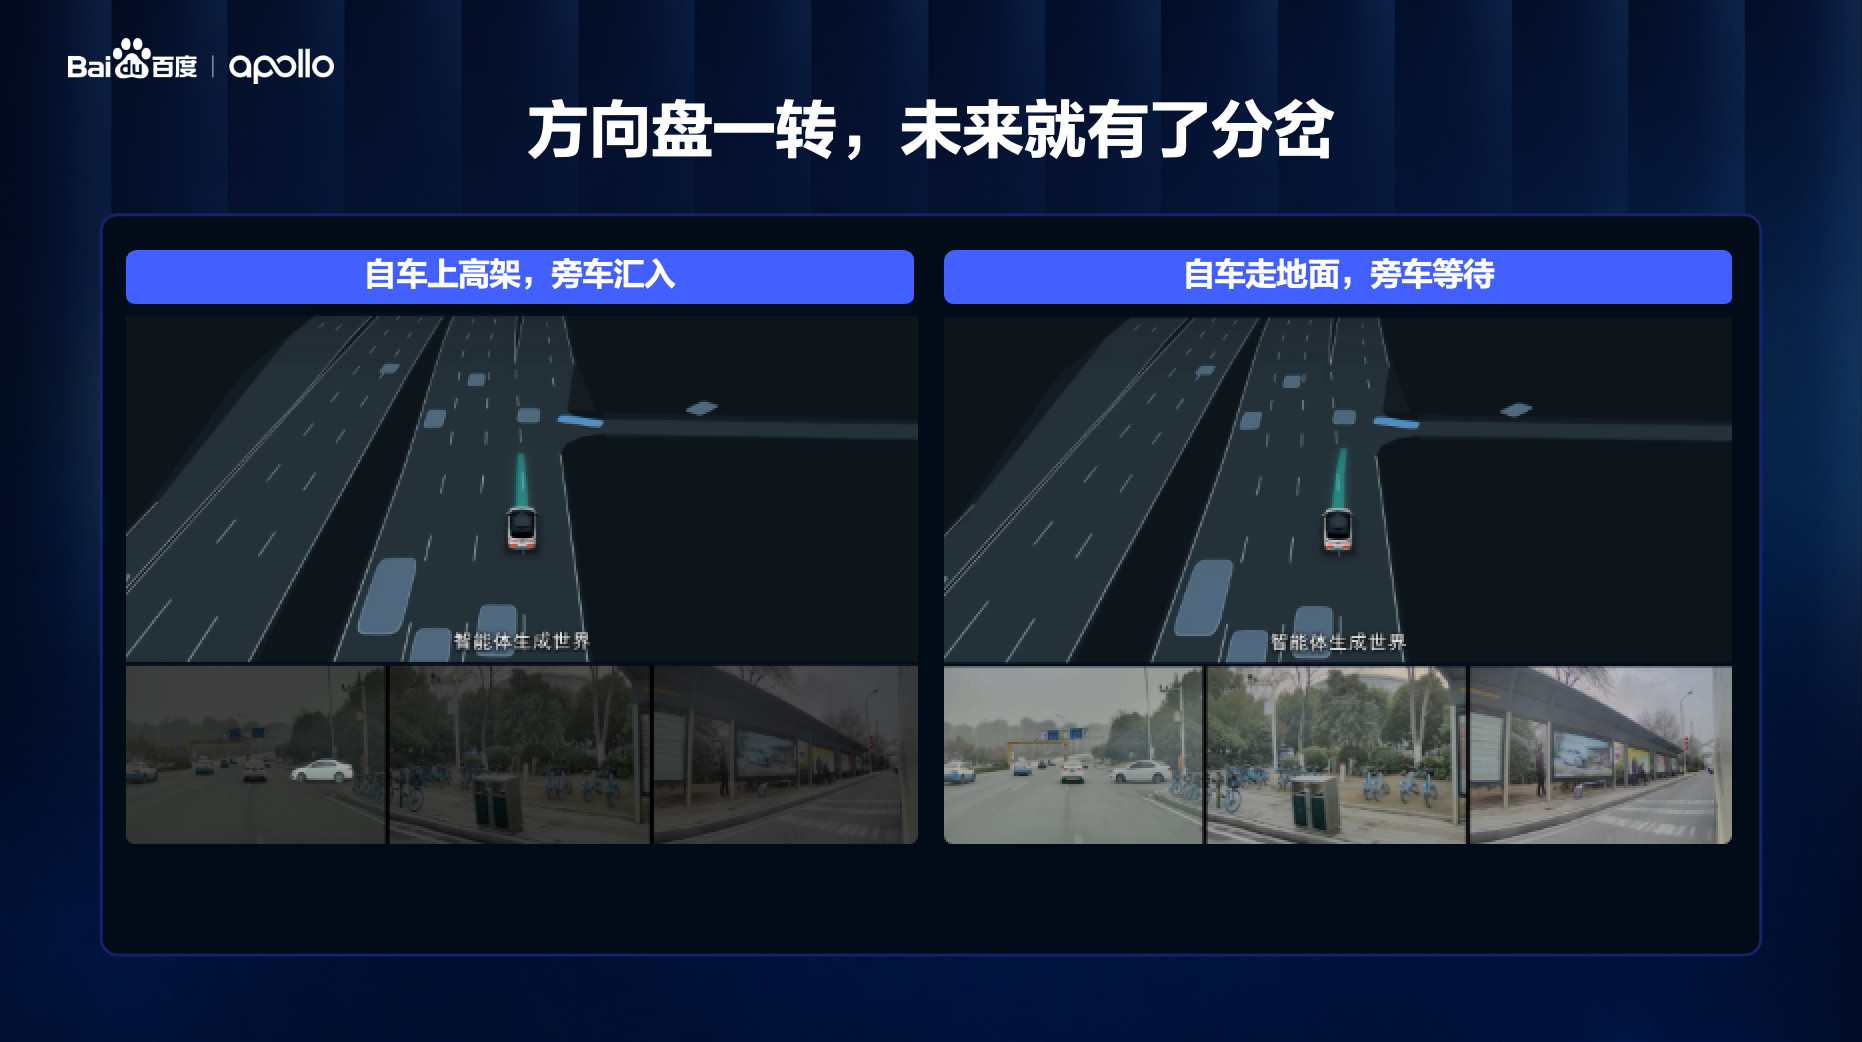
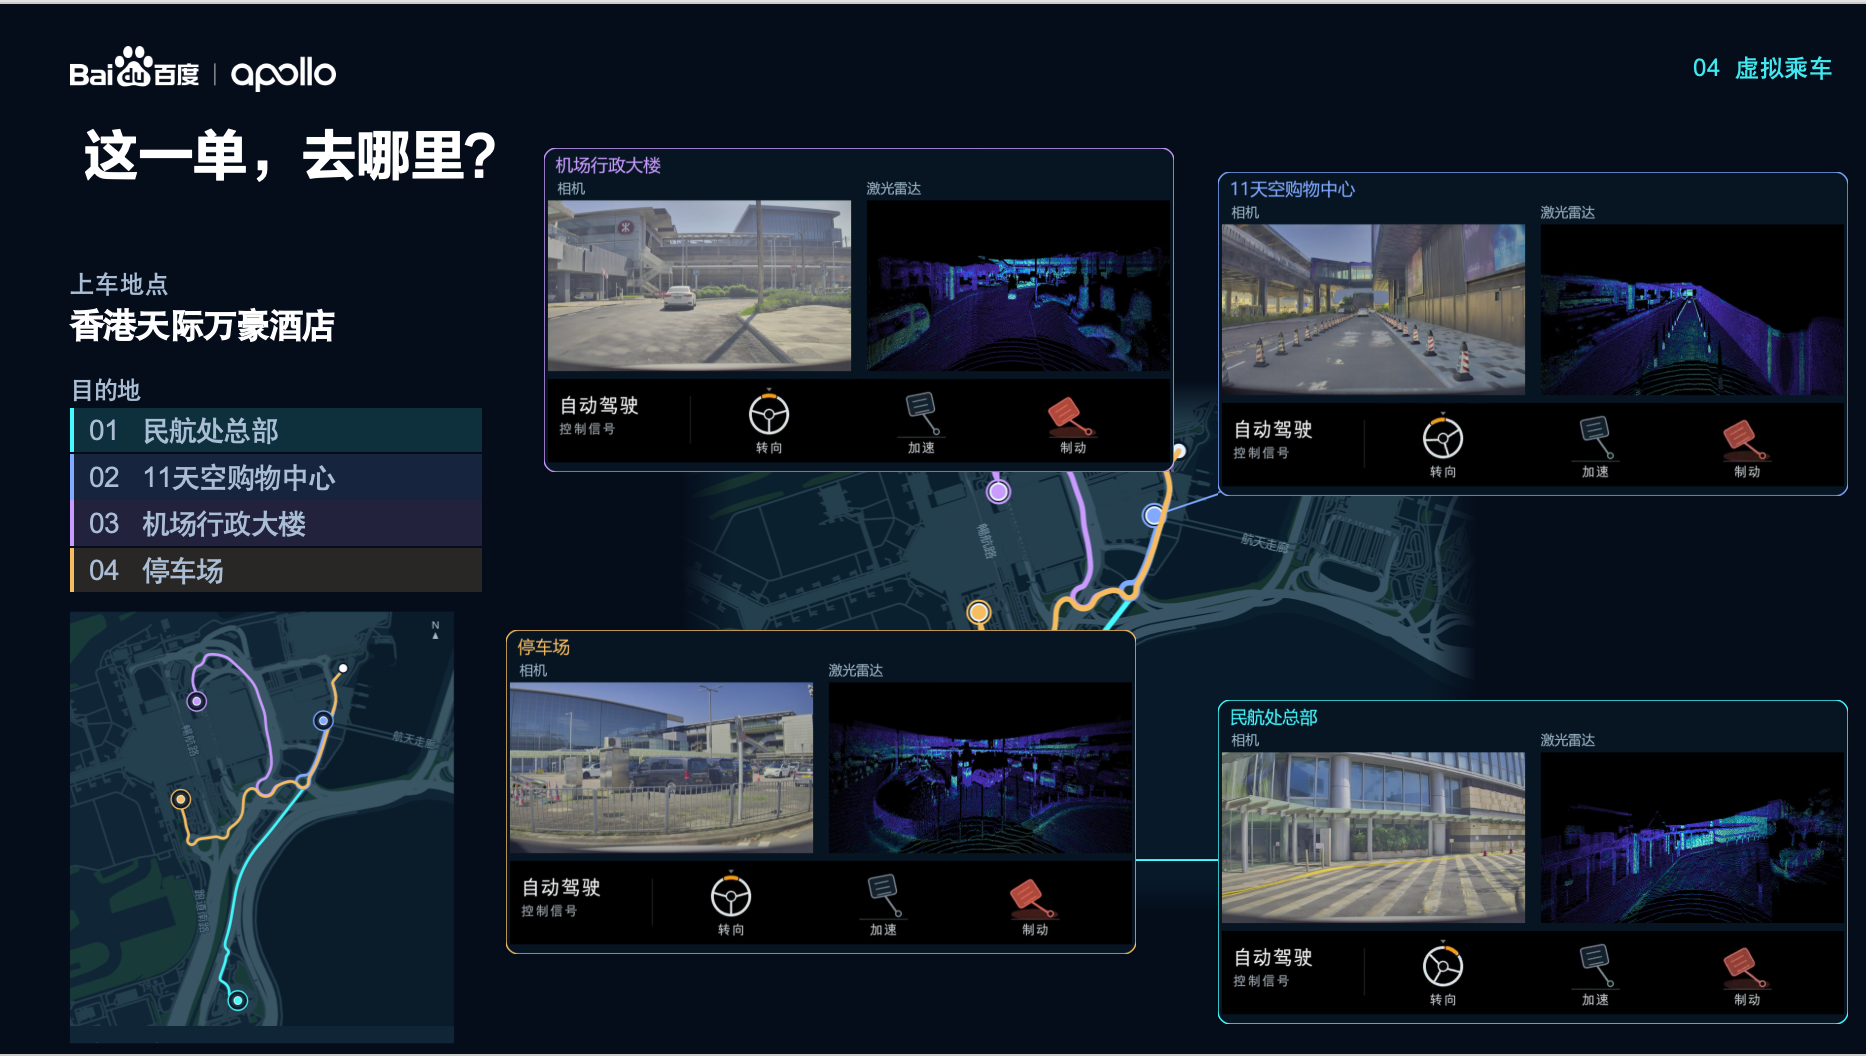
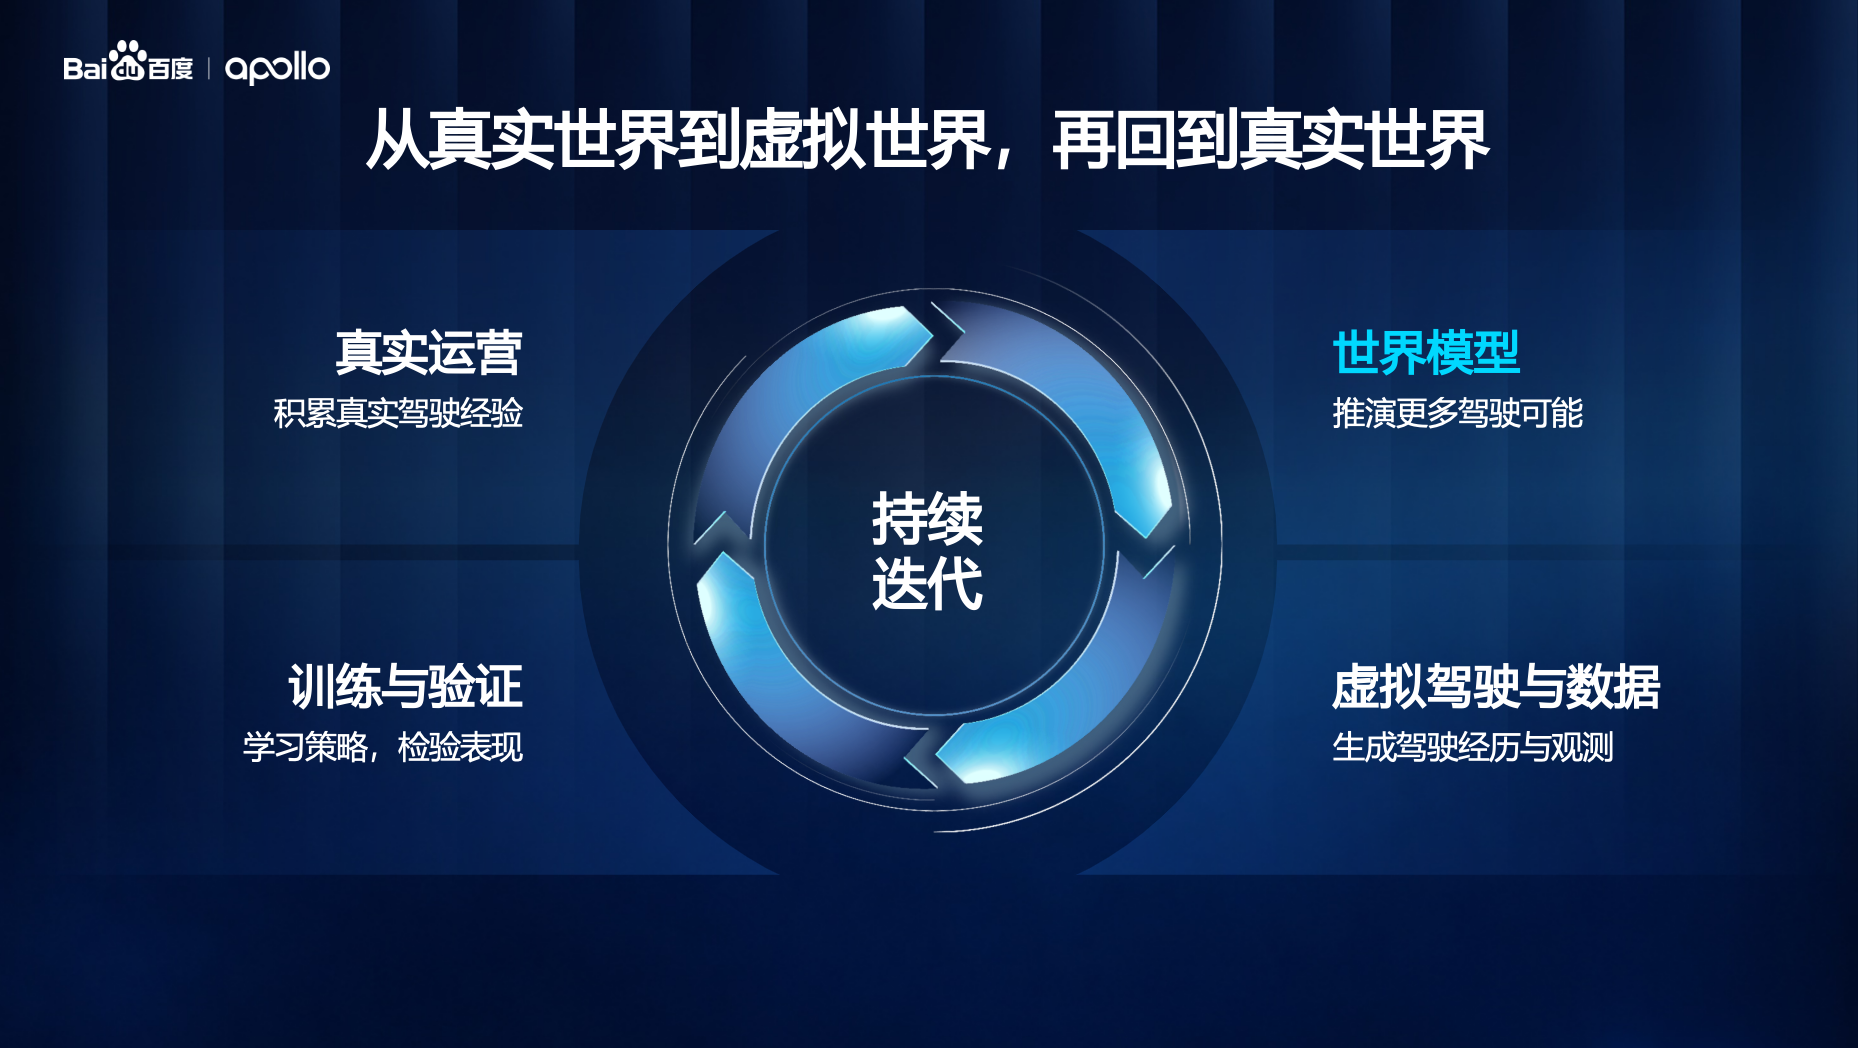
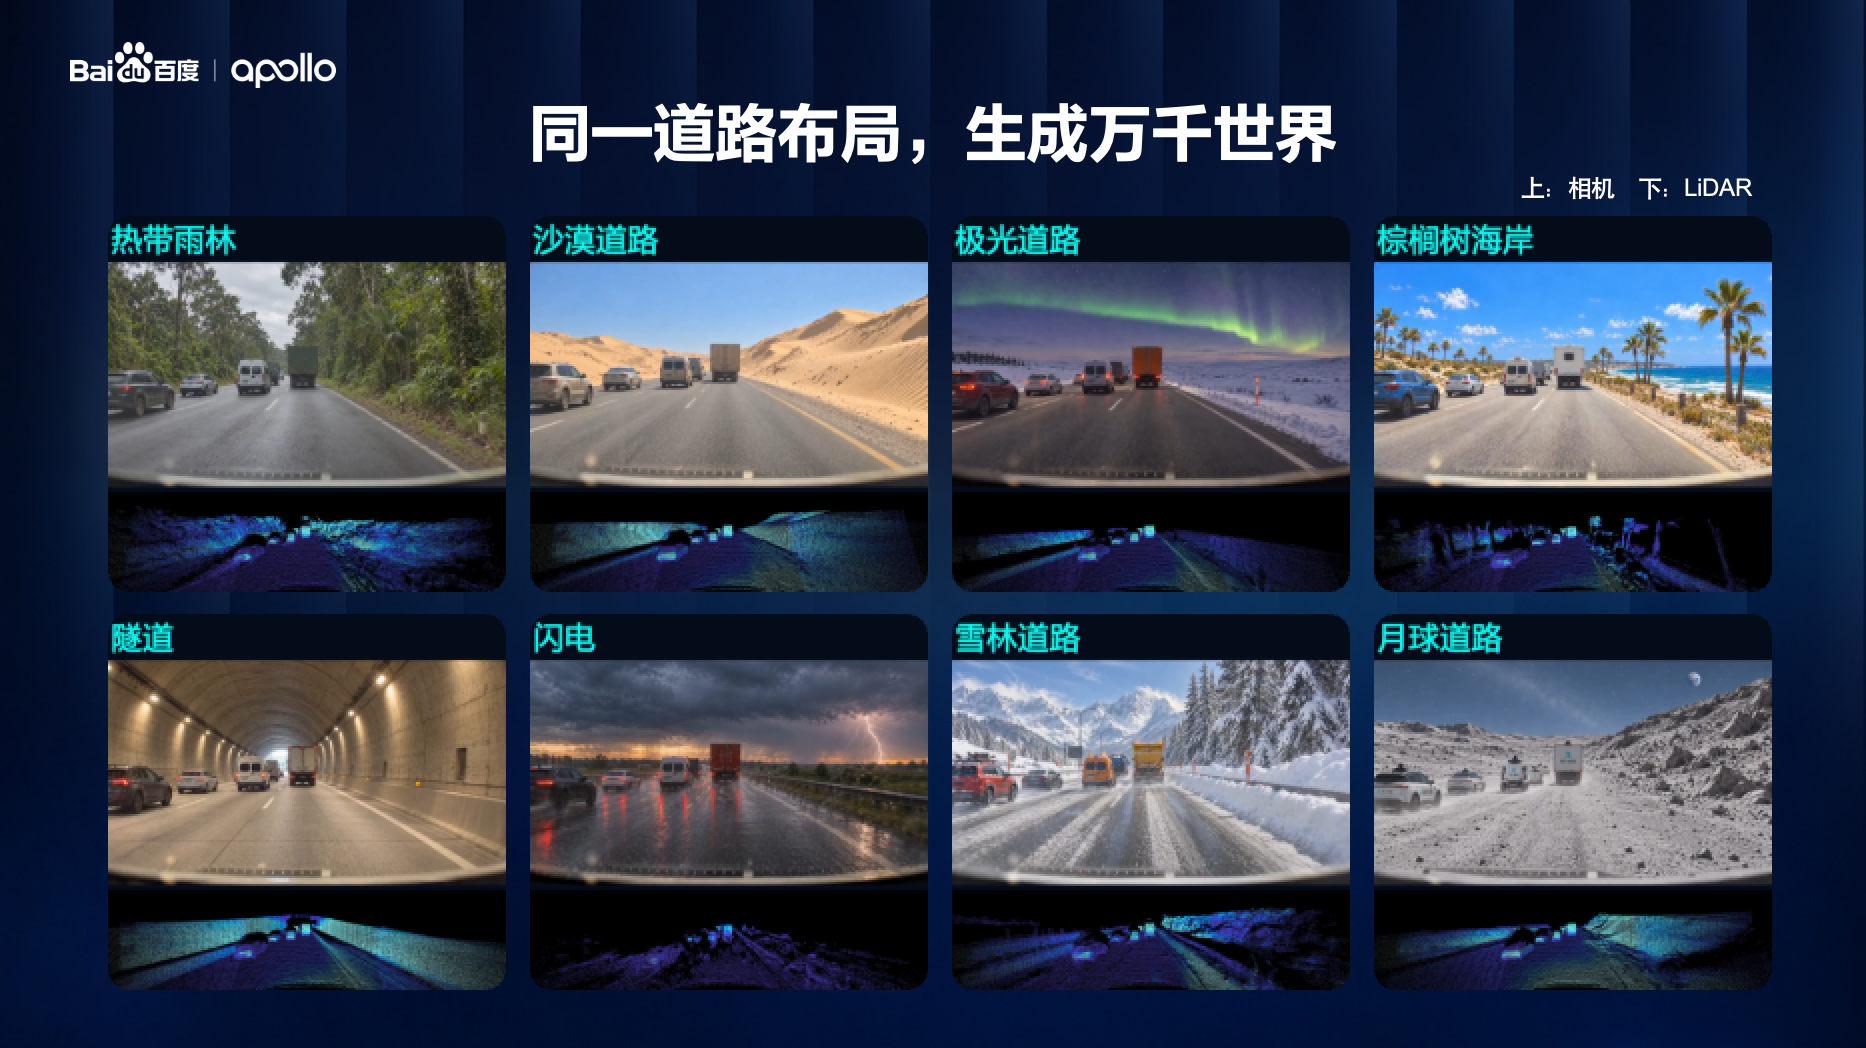
Según el sitio chino de InfoQ, el 3 de noviembre Baidu presentó por primera vez Apollo World, un modelo del mundo orientado a la IA física, en la sesión Apollo del AI Day celebrado en Shenzhen, y planteó el criterio “2+3” para evaluar modelos del mundo. El “2” corresponde a dos umbrales básicos: causalidad, que exige que el modelo respete la unidireccionalidad del tiempo y deduzca el instante siguiente a partir del estado actual en lugar de ensamblar fotogramas para inferir el pasado; e interacción, que exige que las acciones inyectadas desde fuera puedan cambiar el estado futuro del mundo. El “3” son tres indicadores avanzados: precisión física, persistencia durante ejecuciones prolongadas —si los objetos y detalles se desvían— y tiempo real, entendido como que el tiempo de inferencia no crezca cuando aumenta la complejidad de la escena. Wang Liang, arquitecto jefe de IDG de Baidu, afirmó que un modelo del mundo no debe ser solo un “pintor” que genera vídeo, sino un “examinador” que valide la seguridad de la conducción autónoma; el informe menciona que el ciclo de decisión de seguridad en carretera abierta debe limitarse a 1/30 de segundo. Yang Ze, responsable de Apollo World, explicó que los vehículos y peatones de la ciudad virtual se modelan como agentes con capacidad de decisión e interacción, que pueden generar en tiempo real observaciones multimodales —cámara, lidar y otras— para que el vehículo las perciba directamente, y que permiten completar el ciclo cerrado de un trayecto completo entre cualquier origen y destino, desde aceptar el pedido y recoger pasajeros hasta dejarlos en destino, en lugar de simular escenas aisladas. Según el informe, el modelo ya se utiliza en las pruebas y validación globales de Apollo Go, y su stack tecnológico puede extenderse a robots y otros escenarios de IA física.
Impacto para desarrolladores
Para la mayoría de los desarrolladores, la parte accionable de esta noticia no es “hay un modelo más al que llamar”, sino que descompone el modelo del mundo de un problema de aspecto visual en un problema de ingeniería medible. El informe dice claramente que Apollo World sirve al entrenamiento y la validación de conducción autónoma de extremo a extremo de la propia Baidu, y no ofrece una interfaz pública ni pesos, por lo que a corto plazo no cambiará la lista de selección de API de nadie. Pero su criterio puede permear la simulación y la evaluación: si “la complejidad aumenta y el tiempo de inferencia no” se toma como indicador duro, habrá una línea de entrada clara para que un modelo del mundo pase a la simulación en bucle cerrado; si se acepta que “los participantes del tráfico son agentes que reaccionan”, la evaluación basada en reproducción de registros mostrará puntos ciegos de cobertura. Para equipos de IA encarnada, simulación de conducción autónoma o flujos de datos sintéticos, esta descomposición puede adoptarse directamente como lista de revisión interna. A la inversa, los indicadores los propone la parte evaluada, lo que favorece por naturaleza sus puntos fuertes; precisión física y persistencia son justamente lo más difícil de cuantificar, y copiarlos puede producir una lista de aceptación que parece completa pero no mide diferencias reales.
Integración y evaluación
Conviene asignar una decisión a cada uno de los tres tipos de cambio descritos y dejar escritos de antemano los criterios. Primero, participantes interactivos: el informe sostiene que los demás participantes del tráfico tienen capacidad de decisión e interacción. La decisión es si la base de simulación debe pasar de la reproducción de registros a agentes interactivos. La condición previa es que el modo de fallo objetivo dependa de la interacción estratégica —giros sin protección, incorporaciones, cesión de paso— y que exista una línea base de reproducción para comparar; el criterio es ejecutar ambos modos sobre el mismo conjunto de escenas y comparar colisiones y casi colisiones por cada 100 km, así como la proporción de detenciones prolongadas o tanteos repetidos del vehículo propio. Solo si el modo interactivo revela claramente más fallos y la dirección coincide con los registros de toma de control en vehículo real, la actualización se justifica. Segundo, ciclo cerrado de trayecto completo: el informe subraya tareas continuas entre tramos, no escenas aisladas. La decisión es si el criterio de aceptación pasa de la tasa de aprobación por escena única a la tasa de finalización de trayectos continuos. La condición previa es que el sistema sea de extremo a extremo y que el error se acumule con el tiempo; el criterio es contar la tasa de finalización y las tomas de control en unidades de trayectos virtuales de decenas a cientos de kilómetros, y dividir por tramos de carretera para hacer regresión y localizar dónde empieza a acumularse el error. Si la puntuación por escena sube pero la finalización de trayectos continuos no se mueve, los indicadores no están captando el problema real. Tercero, presupuesto de tiempo real: el informe incluye como indicador que “el aumento de complejidad no afecte al tiempo de inferencia”. La decisión es si el modelo del mundo entra en bucle cerrado o solo sirve para aumento de datos fuera de línea. La condición previa es simulación en bucle cerrado y hardware en el bucle; el criterio es medir la latencia p99 por paso a medida que aumentan el número de agentes y las modalidades de sensores. Si se supera el presupuesto del ciclo de decisión, hay que limitar la complejidad de la escena o volver a fuera de línea; de lo contrario, las conclusiones del bucle cerrado no son fiables. Además, el informe separa la deriva en ejecuciones prolongadas; conviene fijar un límite de duración por ejecución y observar, con las horas simuladas en el eje horizontal, la consistencia de identidad y geometría de los mismos participantes, reiniciando al superar el umbral. Todas son recomendaciones condicionales basadas en el informe, no prácticas que Baidu haya divulgado.
Límites y cuestiones pendientes
Apollo World no está actualmente en el catálogo de modelos de KimiSeek, y el informe no menciona una API pública, pesos abiertos ni condiciones de licencia; es una infraestructura interna de entrenamiento y validación de Baidu, y cualquier disponibilidad, términos o facturación de una futura interfaz externa dependerá de Baidu. El informe no ofrece resultados cuantitativos de fidelidad, latencia o deriva del modelo del mundo; las menciones a “100.000 km al día” y “equivalente a unos tres años de pruebas continuas de un vehículo real” están atribuidas a analistas del sector, no a mediciones de Baidu, y son una analogía, no una medición. Que los kilómetros virtuales se traduzcan en seguridad real solo se apoya en la narrativa de bucle cerrado del fabricante; no hay datos independientes de validación sim-to-real. El llamado “2+3” es un marco definido por quien lo propone, por lo que usarlo como lista de aceptación conlleva riesgo de sesgo; precisión física y persistencia carecen de umbrales operativos. Afirmaciones como “más de un millón de kilómetros de operación totalmente no tripulada de extremo a extremo” y “el único L4 de China que opera a escala con tecnología de extremo a extremo” son declaraciones de la empresa y no se han verificado de forma independiente. La extensión a robots y otros escenarios se describe como un stack tecnológico “extensible”, no como una capacidad ya demostrada. La previsión de mercado de IA física citada en el texto proviene de una institución de investigación de terceros y no guarda relación directa con las capacidades del modelo.
Ilustraciones de la noticia original