Cantina publica apex-flash-1: modelo de pesos abiertos para investigación de vulnerabilidades, ajustado sobre GLM-5.3-Flash, resuelve 40 de 60 tareas reservadas
Según MarkTechPost, el 4 de octubre de 2026, Cantina Security, junto con Yeta Labs, publicó el modelo de pesos abiertos apex-flash-1, ajustado con GRPO sobre GLM-5.3-Flash, liberado bajo licencia MIT en Hugging Face, y que según sus autores resuelve 40 de 60 tareas reservadas de vulnerabilidades y cuyos pesos en BF16 requieren aproximadamente 640 GB de VRAM.
Qué ha cambiado
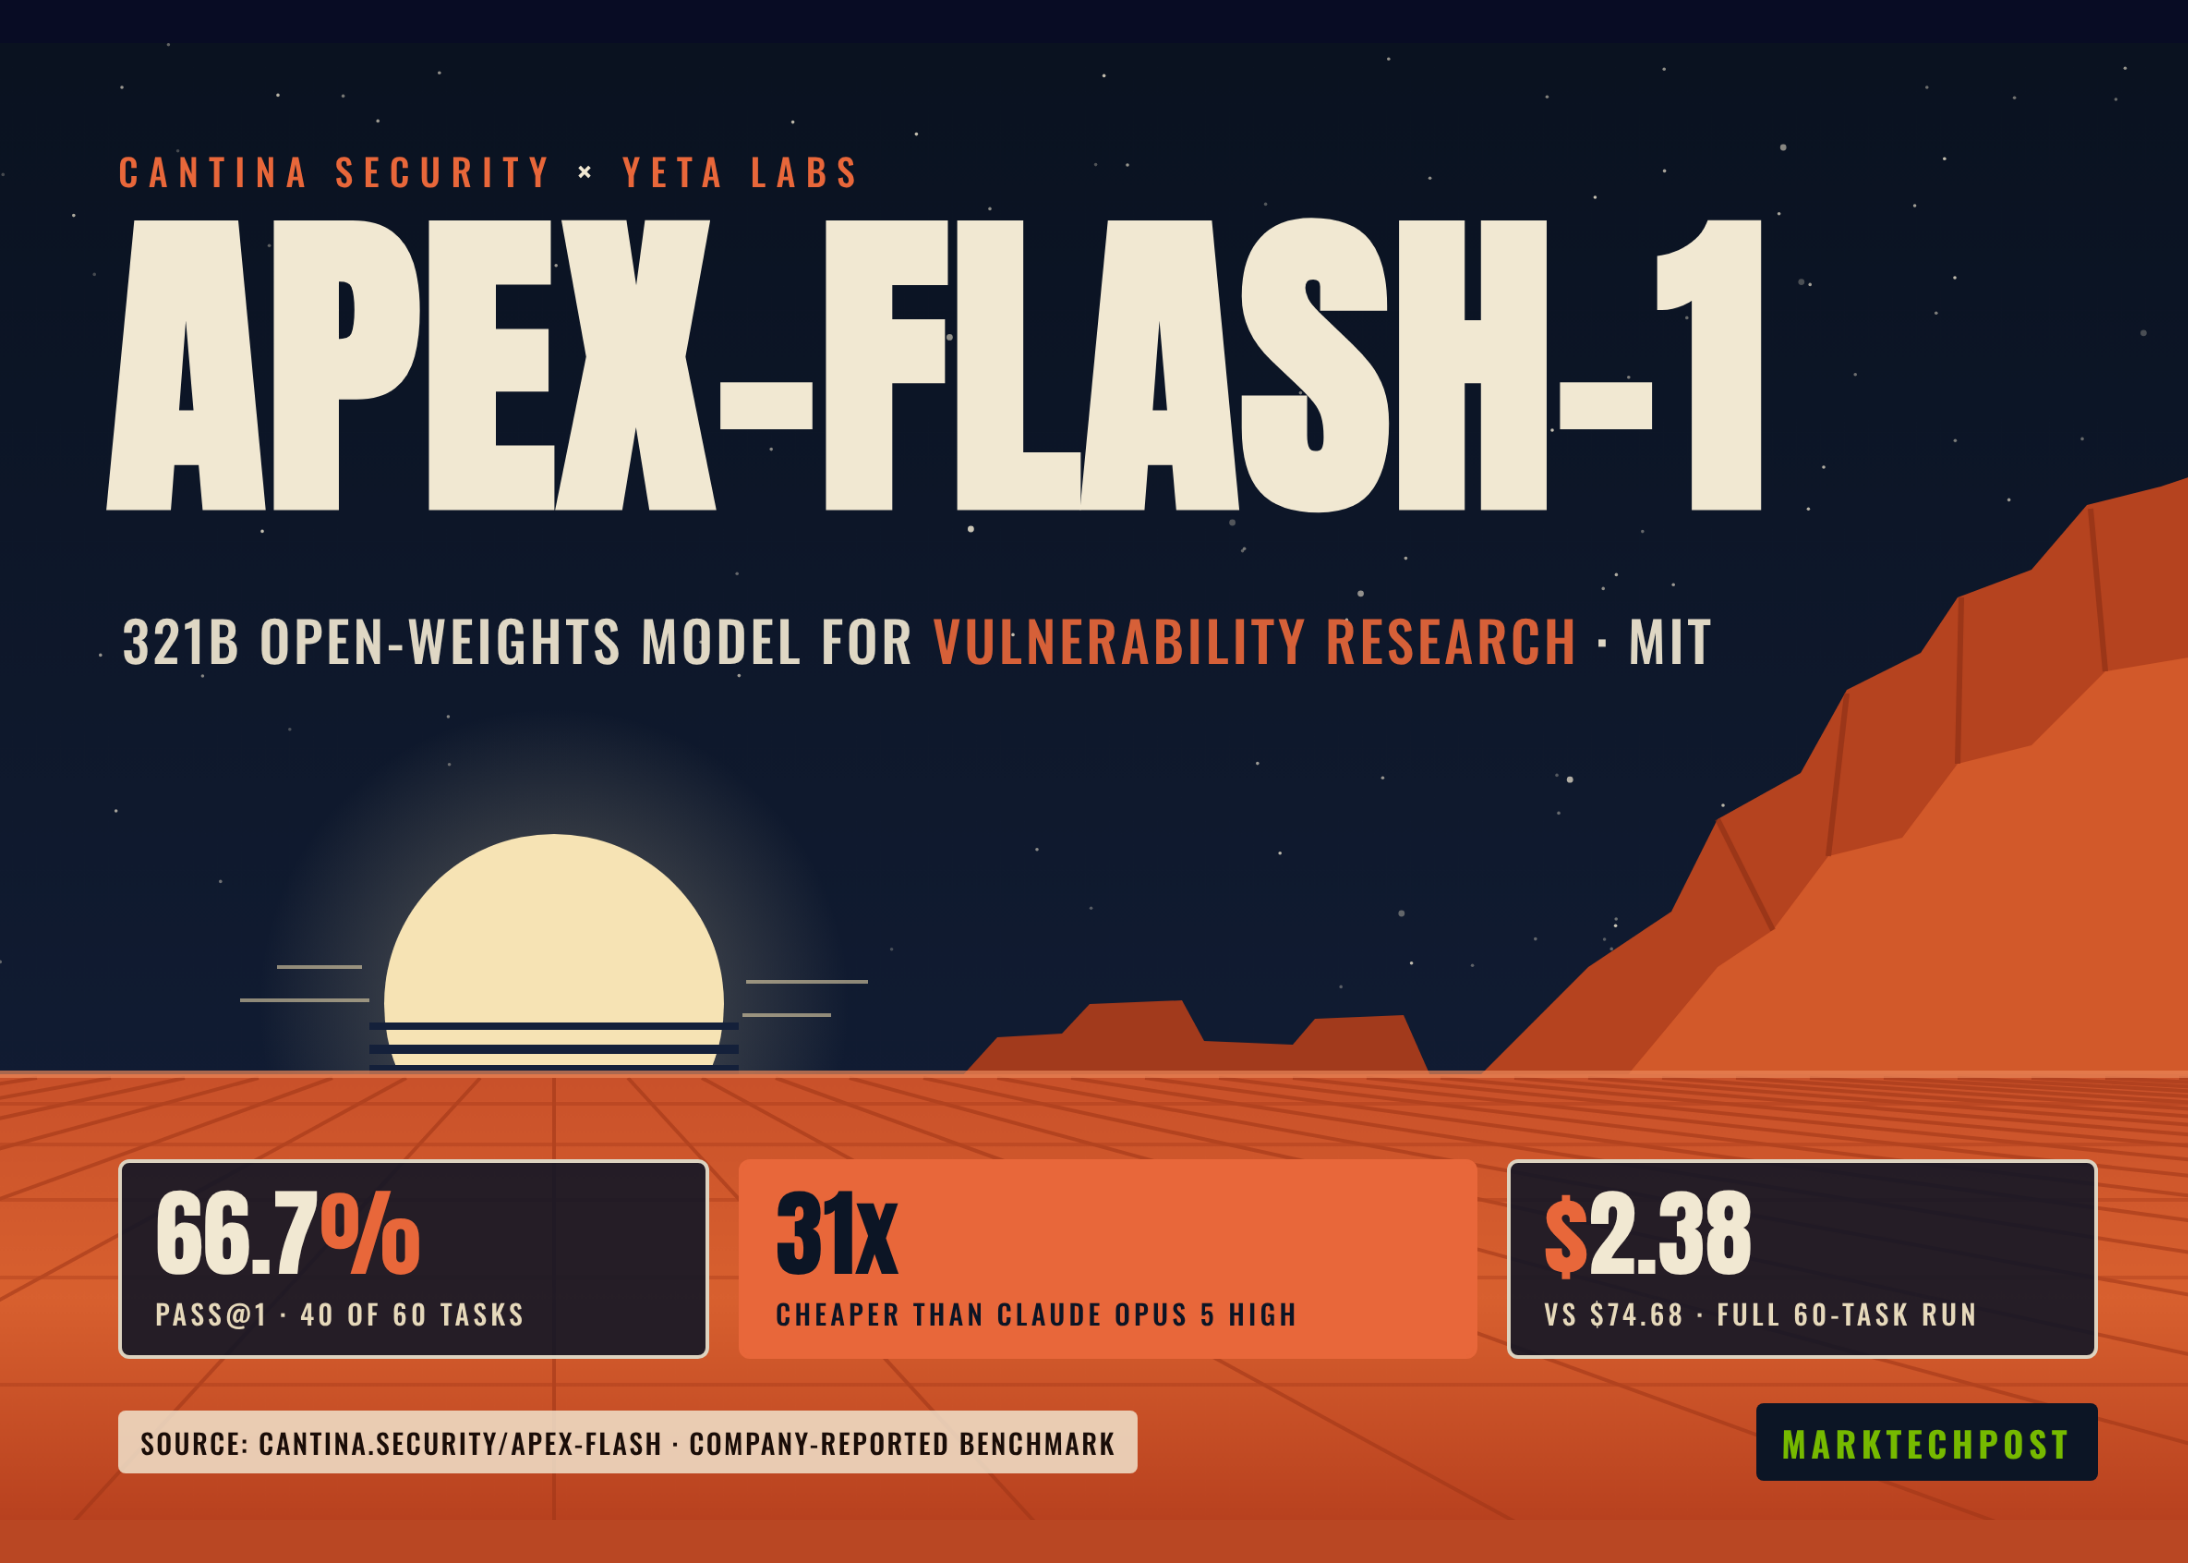
Según MarkTechPost, el 4 de octubre de 2026, Cantina Security, junto con Yeta Labs, publicó apex-flash-1. Este modelo es el resultado de un ajuste fino con aprendizaje por refuerzo sobre GLM-5.3-Flash de Z.ai (MoE, con aproximadamente 320 mil millones de parámetros totales y 18 mil millones activos), y sus pesos ya fueron publicados en Hugging Face bajo licencia MIT. El reporte indica 321.3 mil millones de parámetros totales, entrenamiento con GRPO, LoRA de rango 256 y entrenamiento selectivo de todos los parámetros; los datos provienen de 150 tareas derivadas de 50 casos reales de vulnerabilidades, cada uno con tres variantes: caja blanca guiada, caja blanca enfocada y caja negra enfocada. Entre los tipos de casos, los defectos de autorización/identidad/alcance de permisos representan el 72%, los de contabilidad y precisión numérica el 18%, y el resto son de validación temporal, reglas de negocio y SSRF. El reporte cita la tarjeta del modelo según la cual el rollout se ejecuta en el harness de agente Codex. En cuanto a la evaluación, Cantina seleccionó 60 tareas de 20 casos reservados y ejecutó una pasada por modelo: apex-flash-1 resolvió 40/60 (66.7% pass@1, aproximadamente 2.38 dólares), el modelo base GLM-5.3-Flash 36/60 (60.0%, aproximadamente 4.56 dólares), y Claude Opus 5 High 43/60 (71.7%, aproximadamente 74.68 dólares). El reporte también menciona la existencia de una variante experimental apex-flash-1-abliterated, cuyo comportamiento de rechazo fue modificado y que no fue evaluada por separado. Cantina lo posiciona como un modelo de trabajo orquestado por modelos mayores, orientado a escenarios de defensores con despliegue local autocontrolado. Cabe señalar que tanto los benchmarks como los costos mencionados son datos internos autoinformados por el fabricante.
Impacto para desarrolladores
El impacto para los desarrolladores puede dividirse en tres capas. La primera es la licencia y los límites de uso: el reporte afirma que los pesos se publican bajo licencia MIT, lo cual es distinto de que "los pesos se puedan descargar" —MIT es una cláusula de licencia, con una ruta relativamente clara para uso comercial y redistribución, pero aún debe verificarse con la LICENSE y el NOTICE del repositorio oficial, y el reporte no detalla si se adjunta una política de uso separada. La segunda es la estructura de costos de despliegue: el reporte indica que los pesos en BF16 requieren aproximadamente 640 GB de VRAM, una magnitud que no cabe en una sola tarjeta; el autoalojamiento requiere nodos multi-GPU o una adaptación cuantizada; el reporte menciona que ya existe una adaptación comunitaria a 4 bits, pero no ofrece evaluación de calidad, y el impacto de la cuantización en tareas de explotación de vulnerabilidades es una incógnita que debe contrastarse por cuenta propia. La tercera es la adaptabilidad a tareas: el 72% de los datos de entrenamiento se concentra en defectos de autorización, identidad y alcance de permisos, por lo que el rendimiento en este tipo de tareas no puede extrapolarse a vulnerabilidades de seguridad de memoria, concurrencia, criptografía o cadena de suministro; la evaluación debería estratificarse por categoría de defecto en lugar de mirar solo el pass@1 total. Además, el reporte posiciona este modelo como un "modelo de trabajo" orquestado por modelos mayores, lo que sugiere que su forma de integración prevista es un eslabón de ejecución dentro de un harness de agente, y el grado de alineación de la interfaz y el protocolo de llamadas a herramientas afectará directamente su usabilidad. En cuanto al estado actual del catálogo: apex-flash-1 no tiene una coincidencia exacta en el catálogo en vivo de KimiSeek; si se necesita invocar su base GLM-5.3-Flash, existe una entrada con el mismo nombre en el catálogo, pero la información del catálogo solo indica la capacidad de invocación actual y no puede usarse como evidencia de los benchmarks, precios o pesos de este reporte.
Integración y evaluación
Lo siguiente son recomendaciones y análisis condicionales, no afirmaciones factuales del reporte. Recomendación uno: hacer primero una comparación de muestra pequeña por categoría de defecto antes de decidir si invertir en autoalojamiento. El cambio concreto del reporte es que el 72% de los datos de entrenamiento se concentra en defectos de autorización/identidad/alcance de permisos; la decisión correspondiente es elegir apex-flash-1 o el base GLM-5.3-Flash, con la condición previa de si las tareas objetivo caen en esas categorías; el criterio de evaluación medible es comparar la diferencia de pass@1 entre ambos en 20 a 30 tareas propias reservadas de autorización, y si la mejora es inferior a unos 5 puntos porcentuales, no vale la pena asumir el costo operativo adicional del despliegue multi-GPU. Recomendación dos: establecer un umbral de tasa de éxito de llamadas a herramientas para la integración del agente. El reporte afirma que el rollout se ejecuta en el harness de agente Codex y enumera lectura de código, llamadas a herramientas, desarrollo de exploits y verificación como capacidades objetivo; la decisión correspondiente es usarlo como ejecutor dentro del agente y no como planificador, con la condición previa de que el esquema de herramientas de tu harness sea cercano a su entorno de entrenamiento; el criterio de evaluación medible es contar la tasa de formato válido y la tasa de finalización de extremo a extremo en 50 llamadas reales a herramientas, y si la tasa de formato válido es inferior a aproximadamente 95%, conviene añadir una capa de validación de salida antes de integrarlo. Recomendación tres (condicional): si la VRAM es insuficiente, elegir o no la adaptación comunitaria a 4 bits. El reporte menciona que ya existe una adaptación a 4 bits pero sin datos de calidad; la decisión correspondiente es optar entre esperar una cuantización oficial o adoptar la adaptación comunitaria, con la condición previa de si tus tareas son más sensibles a la precisión numérica o al rendimiento; el criterio de evaluación medible es ejecutar el mismo conjunto de 60 tareas antes y después de la cuantización y comparar la caída en el número de tareas resueltas; si la caída supera 3 a 5 tareas, no es apto para sustituir directamente BF16 en verificación automatizada de vulnerabilidades.
Límites y cuestiones pendientes
Todos los datos de benchmark (66.7% pass@1, 40/60, aproximadamente 2.38 dólares, etc.) son resultados internos autoinformados por Cantina, la muestra proviene de 20 casos reservados con un total de 60 tareas, es de escala pequeña y la distribución de tipos de tareas no se ha publicado por completo, y terceros aún no lo han reproducido. El reporte no revela las reglas de puntuación de la evaluación, si se permiten múltiples intentos ni el criterio para determinar que una tarea fue "resuelta"; pass@1 puede significar cosas distintas según la implementación. La variante apex-flash-1-abliterated no fue evaluada por separado, y el impacto de los cambios en su comportamiento de rechazo sobre la seguridad es completamente desconocido. En cuanto a los requisitos de hardware, el cuerpo del reporte dice aproximadamente 640 GB, la tabla comparativa aproximadamente 642 GB y la tabla de parámetros BF16 328 GB; varias cifras son inconsistentes, por lo que al elegir conviene guiarse por el tamaño real de los archivos de pesos del repositorio oficial; la adaptación comunitaria a 4 bits no tiene datos de calidad. En cuanto a esta ronda de verificación del catálogo, la versión apex-flash-1 no aparece actualmente en el catálogo en vivo de KimiSeek; cualquier disponibilidad de API o costo de invocación mencionado en este artículo apunta a fabricantes o proveedores terceros y no significa que pueda invocarse directamente en esta plataforma; su base GLM-5.3-Flash tiene una entrada con el mismo nombre en el catálogo, pero esa información del catálogo solo refleja la capacidad de invocación actual y no constituye corroboración de los benchmarks o precios del reporte. La fecha del reporte es el 4 de octubre de 2026; la comparación de costos y las conclusiones contenidas tienen vigencia temporal y no deben considerarse el estado actual; para información de precios, consúltese la página oficial de precios.