Deep Principle publica Hydrogen-1.0: modelo científico de 753B con pesos abiertos y servicio en 8 GPU con SGLang
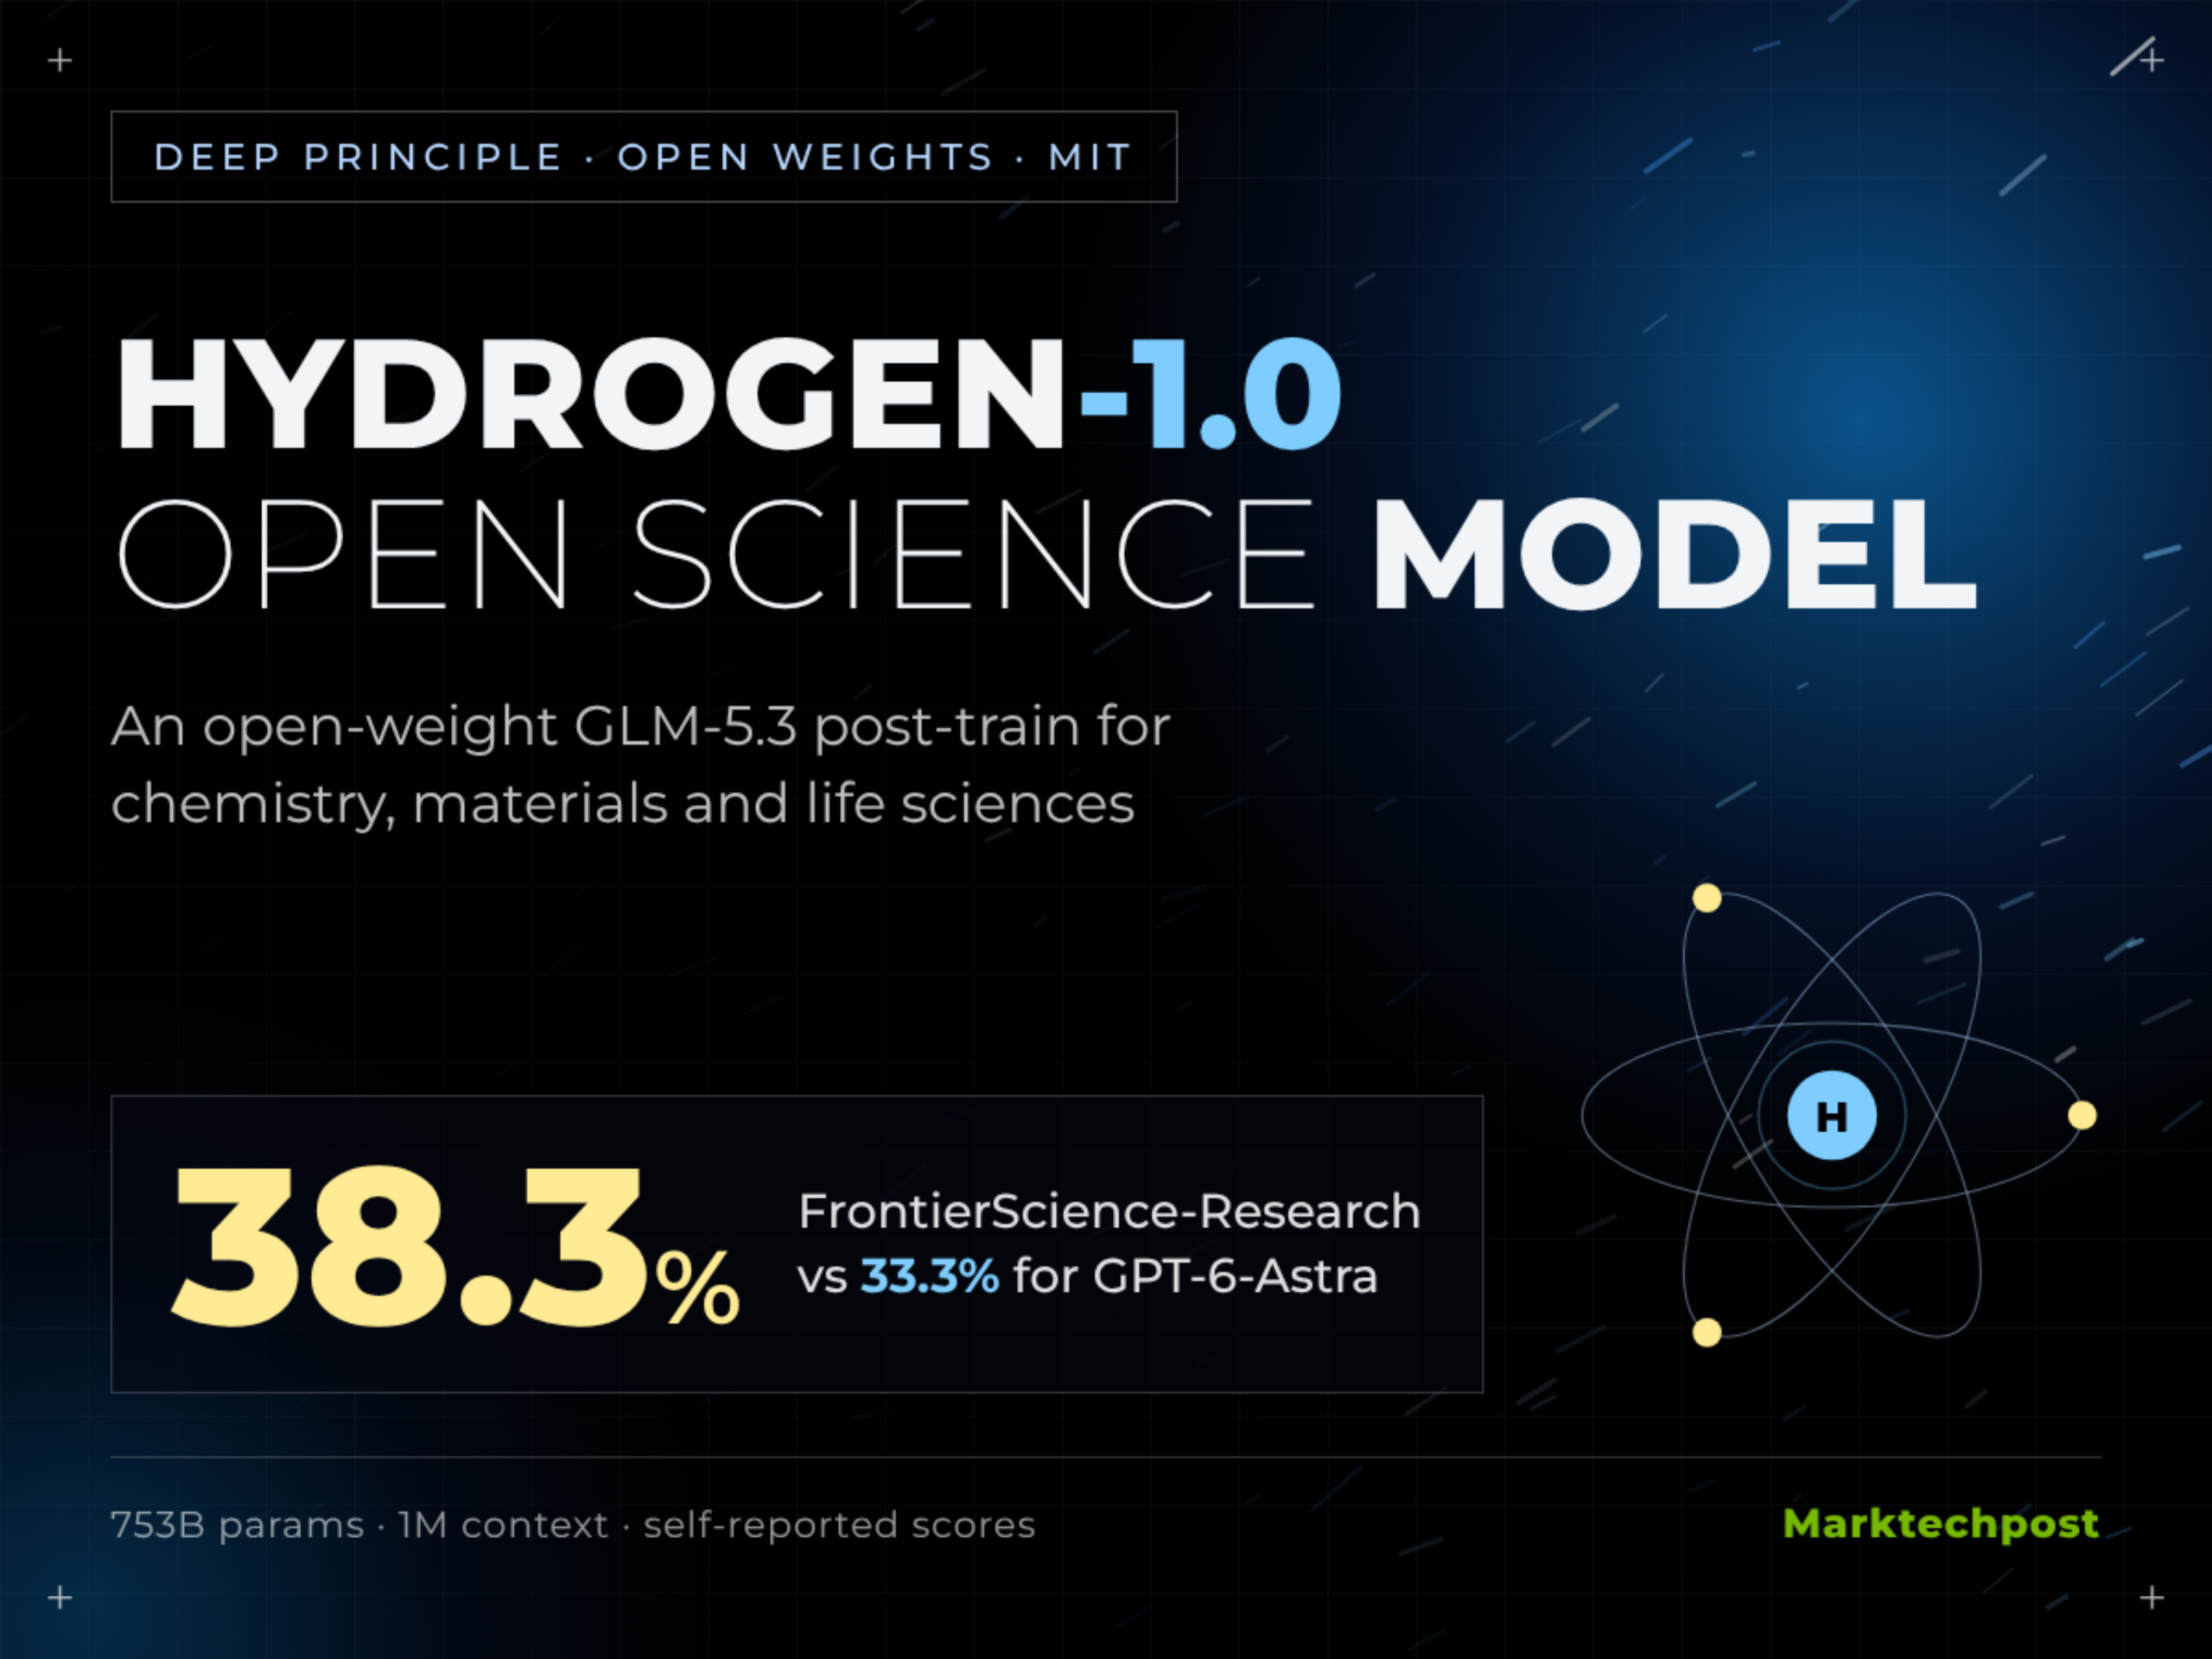
MarkTechPost informó el 2 de noviembre de 2026 que Deep Principle, con sede en Hangzhou, publicó Hydrogen-1.0, un modelo postentrenado a partir de GLM-5.3 con 753B parámetros totales y 1M de contexto; se informa que los pesos se publican bajo licencia MIT. Su autoevaluación en FrontierScience-Research es 38,3 %, frente al 33,3 % de GPT-6-Astra, y en elucidación estructural por NMR queda 3,33 puntos porcentuales por detrás.
Qué ha cambiado
Según el reportaje de MarkTechPost del 2 de noviembre de 2026, Deep Principle, empresa de AI for Materials con sede en Hangzhou, publicó Hydrogen-1.0; los pesos ya se han subido a Hugging Face y ModelScope, y el reportaje afirma que se publican bajo licencia MIT. La tarjeta del modelo lo describe como un modelo derivado de GLM-5.3 de Z.ai, orientado a la formulación de problemas, planificación de experimentos, análisis de resultados y descubrimiento abierto. El equipo afirma que ofrece una alternativa reproducible y auditable a modelos científicos propietarios que antes no estaban abiertos. En especificaciones, el reportaje indica 753B parámetros totales, un MoE de unos 40B activos (la escala de activación se hereda de la base GLM-5.3), contexto de 1M tokens, salida máxima de 128K y modalidad exclusivamente de texto. El entrenamiento combina ajuste supervisado y aprendizaje por refuerzo, con datos de cuatro fuentes: conocimiento de química, materiales y ciencias de la vida; retroalimentación de tareas de científicos de Deep Principle; registros electrónicos de laboratorio de ciclo completo recopilados mediante Mira; y secuencias de selección y retroalimentación que incluyen intentos fallidos. La infraestructura se basa en Megatron y SGLang y cubre NVIDIA CUDA y AMD ROCm; los checkpoints de entrenamiento se convierten mediante un adaptador de layout en pesos de inferencia BF16 y FP8 con bloques de 128×128. El reportaje indica explícitamente que el conjunto de datos completo y la receta de entrenamiento no se han publicado. Todos los benchmarks son autoevaluaciones del fabricante. En FrontierScience-Research, Hydrogen-1.0 obtiene 38,3 % y GPT-6-Astra, según el reportaje, 33,3 %. El 93,0 % en GPQA-Diamond proviene de un hilo de tuits del fundador; la afirmación de que supera a GLM-5.3 y está aproximadamente a la par de Kimi-K3 es del blog, mientras que en la tabla comparativa del reportaje las puntuaciones de esos dos modelos en esa prueba figuran como no divulgadas y el 96,0 % de GPT-6-Astra en la tabla está marcado como informe de OpenAI. La evaluación interna de tareas de investigación usa GPT-6-Astra en modo de máximo pensamiento como referencia: Hydrogen-1.0 aventaja en 5,13 puntos porcentuales en cálculo científico y en 4,76 puntos porcentuales en predicción de reacciones directas, pero queda 3,33 puntos porcentuales por detrás en elucidación estructural por NMR. En una tarea de diseño de complejos de metales de transición, el modelo busca un gap HOMO-LUMO mayor a lo largo de cinco rondas; el mejor histórico promedio de la quinta ronda es 4,318 eV, frente a 3,689 eV de GPT-6-Astra y 3,353 eV de Kimi-K3 según el reportaje. En 117 preguntas de planificación de experimentos, Hydrogen-1.0 supera en puntuación a Kimi-K3; GPT-6-Astra y Opus-5.5 quedan fuera de esa comparación porque rechazaron más de la mitad de las solicitudes. Hay cuatro demostraciones: construir una masa fundida de polietileno con Python y ejecutar GROMACS, detectar un error de topología, corregirlo y analizar la trayectoria corregida de 40 ns; ampliar una red de reacciones Ireland-Claisen con 27 estructuras mediante 30 reacciones plausibles; ordenar 7 productos monoformilados candidatos de 2-bromonaftaleno a partir de espectros de 1H NMR; y redactar un protocolo JSON para un estudio de acoplamiento Suzuki con 12 viales. El paso de compilación del laboratorio virtual también detuvo, antes de la ejecución, una operación de pipeteo en la que no se había cambiado la punta. En despliegue, el equipo probó el servicio BF16 con SGLang en 8 GPU con paralelismo tensorial 8; también existen una versión NVFP4 para NVIDIA B200/B300 y una versión MXFP4 para AMD Instinct MI350X/MI355X. El servidor ofrece una interfaz compatible con OpenAI con un ajuste reasoning_effort. El reportaje no revela el precio de API de Hydrogen-1.0 ni menciona un servicio alojado.
Impacto para desarrolladores
La primera barrera para los desarrolladores es la máquina, no la integración. Con 753B parámetros totales y unos 40B activos, la inferencia autoalojada es un proyecto de ingeniería de nivel ocho GPU, y la única configuración verificada en el reportaje es BF16 con TP=8. Para reducir el número de GPU, solo cabe recurrir a los checkpoints NVFP4 o MXFP4; esas dos versiones están atadas a Blackwell (B200/B300) y a MI350X/MI355X, respectivamente, y para equipos con H100/H200 o MI300 el reportaje no ofrece una ruta equivalente. Es más una opción para quien tiene recursos y puede autohospedarlo que una de levantar un contenedor sin más; esto vale especialmente para el contexto de 1M, donde el tiempo de prefill y el uso de VRAM deben medirse por separado con solicitudes largas, sin extrapolar el rendimiento de prompts cortos. La forma de la interfaz reduce el coste de migración. El servidor de SGLang expone una interfaz compatible con OpenAI, así que la mayoría de los clientes existentes y capas de orquestación de prompts pueden conectarse directamente; reasoning_effort convierte el presupuesto de pensamiento en un parámetro de la solicitud, pero el reportaje no especifica su rango de valores, su valor predeterminado ni su relación con los tokens de salida. Esto debe confirmarse primero en la propia puerta de enlace; de lo contrario, la latencia en producción variará según el nivel predeterminado. Hay que separar dos cosas en la licencia: el reportaje afirma que los pesos publicados usan MIT, lo que es más permisivo que solo abrir los pesos; pero en la tabla comparativa del mismo reportaje la base GLM-5.3 aparece con otra licencia, la licencia GLM-5.3. Que un modelo ajustado a partir de una base con licencia personalizada pueda ser redistribuido por el derivador bajo MIT debe verificarse leyendo el texto de la licencia y la tarjeta del modelo; no puede inferirse de que los pesos sean descargables. El conjunto de datos y la receta de entrenamiento no son públicos, así que la reproducibilidad y auditabilidad que menciona el equipo solo cubren, por ahora, la capa de pesos; los registros de laboratorio y las trazas de descubrimiento no forman parte de lo abierto. Hay una asimetría en el perfil de capacidades. El propio reportaje reconoce que el modelo queda 3,33 puntos porcentuales por detrás de GPT-6-Astra en elucidación estructural por NMR; se trata de una comparación dentro de tareas internas de investigación. El mismo reportaje incluye una demostración en la que el modelo ordena 7 productos monoformilados candidatos a partir de espectros de 1H NMR. Son tareas distintas: la primera es la debilidad señalada por el reportaje y la segunda solo una demostración. Que tu negocio tropiece con esa debilidad depende del peso de las tareas de elucidación en tus solicitudes, no del número de demostraciones en la documentación. También hay un detalle metodológico que conviene tener en cuenta. En la prueba de planificación de experimentos, dos competidores fueron excluidos porque su tasa de rechazo superaba la mitad, lo que significa que la comparación solo se produjo en solicitudes que el modelo estaba dispuesto a responder. Si tus prompts en producción son ambiguos o contienen información sensible, la tasa de rechazo debería entrar en la evaluación junto con la exactitud; de lo contrario, podrías elegir el modelo más dispuesto a aceptar trabajo, no el más preciso.
Integración y evaluación
El siguiente análisis es condicional y se basa en el reportaje; no son hechos verificados. Decisión uno: elegir BF16 o FP4 como versión de precisión. El cambio que describe el reportaje es que el mismo modelo tiene tres rutas de inferencia: BF16 ya probado (8 GPU, TP=8), NVFP4 para B200/B300 y MXFP4 para MI350X/MI355X. Lo que hay que hacer es no elegir FP4 directamente porque el formato nuevo sea más rápido, sino tratarlo como un sustituto que debe validarse. El primer factor es la generación de acelerador: solo el hardware correspondiente tiene checkpoints FP4; el resto de máquinas solo puede volver a BF16. El segundo es si queda suficiente VRAM para BF16. Un criterio medible es tomar un lote de tareas propias (por ejemplo, un lote de ordenación de productos a partir de espectros y otro de predicción de reacciones directas), ejecutarlas en BF16 y en FP4, y comparar la coincidencia top-1 y la latencia de salida por solicitud; si la caída de coincidencia supera tu umbral de negocio y BF16 puede ejecutarse, quédate en BF16. Decisión dos: sustitución completa o enrutamiento por tarea. El punto de cambio que describe el reportaje es que Hydrogen-1.0 recibió un postentrenamiento científico sobre GLM-5.3, mientras que el reportaje describe el enfoque de la base GLM-5.3 como programación y agentes. Lo que hay que hacer es enrutar por tipo de solicitud, no sustituir un modelo por otro: razonamiento y planificación experimental de química, materiales y ciencias de la vida van a Hydrogen-1.0; la programación general y la orquestación de herramientas se quedan en la base u otros modelos. El requisito es tener suficiente volumen de solicitudes para separar estadísticamente ambos tipos de tráfico; de lo contrario, el enrutamiento solo añade carga operativa. El criterio es reservar un conjunto de validación por categoría de tarea, registrar la tasa de aprobación y el coste real por tarea exitosa, y separar solo cuando la mejora en tareas científicas compense el coste de mantener un despliegue adicional. Decisión tres: el nivel predeterminado de reasoning_effort. El reportaje confirma que el servidor expone esa configuración y también que la comparación con GPT-6-Astra se hizo en modo de máximo pensamiento. Lo que hay que hacer es no copiar el nivel del competidor, sino recorrer la curva propia. El requisito es poder registrar los tokens de salida y la latencia de extremo a extremo de cada solicitud. El criterio es la curva de exactitud frente a tokens de salida: toma como valor predeterminado el punto de inflexión donde la ganancia marginal se aplana claramente y fija un nivel bajo aparte para las interfaces en línea sensibles a la latencia. Los pasos de evaluación complementarios pueden ordenarse según los puntos fuertes y débiles que el propio reportaje declara: primero reproduce en tus datos la debilidad de elucidación estructural por NMR y observa si los tipos de error coinciden con la dirección de la desventaja señalada; después reproduce las fortalezas que declara, por ejemplo la optimización iterativa de buscar un gap mayor durante varias rondas, y comprueba si la tendencia de convergencia en la quinta ronda se acerca a la evolución numérica indicada en el reportaje; por último, mide la tasa de rechazo y el cumplimiento de formato, porque en el reportaje dos competidores fueron precisamente filtrados por su tasa de rechazo.
Límites y cuestiones pendientes
Hydrogen-1.0 no está actualmente en el catálogo de modelos de KimiSeek; este sitio no lo lista ni ofrece una entrada para llamarlo. La dirección de descarga de pesos y la interfaz compatible con OpenAI del reportaje apuntan a un despliegue propio del fabricante; cualquier disponibilidad alojada, precio y límite de peticiones debe confirmarse con Deep Principle o con el proveedor de alojamiento real. El GLM-5.3 del catálogo de este sitio es su base; no son el mismo modelo. Los benchmarks del reportaje son autoevaluaciones de Deep Principle; el reportaje no menciona reproducciones independientes de FrontierScience-Research ni de la evaluación interna de tareas. El 33,3 % de GPT-6-Astra es una cifra transmitida por Deep Principle; el 93,0 % de GPQA-Diamond proviene de un hilo de tuits del fundador; y la afirmación de que supera a GLM-5.3 y está aproximadamente a la par de Kimi-K3 carece del respaldo de los valores correspondientes en la tabla del reportaje. El conjunto de datos y la receta de entrenamiento no son públicos; según el reportaje, la licencia MIT solo cubre los pesos publicados, la base usa otra licencia en la tabla comparativa y la posibilidad de redistribuir los pesos derivados bajo MIT debe comprobarse directamente en el archivo de licencia. Las cuatro demostraciones solo muestran que el flujo puede ejecutarse; no validan exactitud ni seguridad. El reportaje no revela el precio de API ni un servicio alojado para el modelo; si más adelante aparece un proveedor de alojamiento, el precio y las cuotas deben consultarse en su página de precios.