EmbeddingGemma 2: pesos abiertos con 740 millones de parámetros en un espacio compartido de 768 dimensiones, con código y audio como nuevas variables
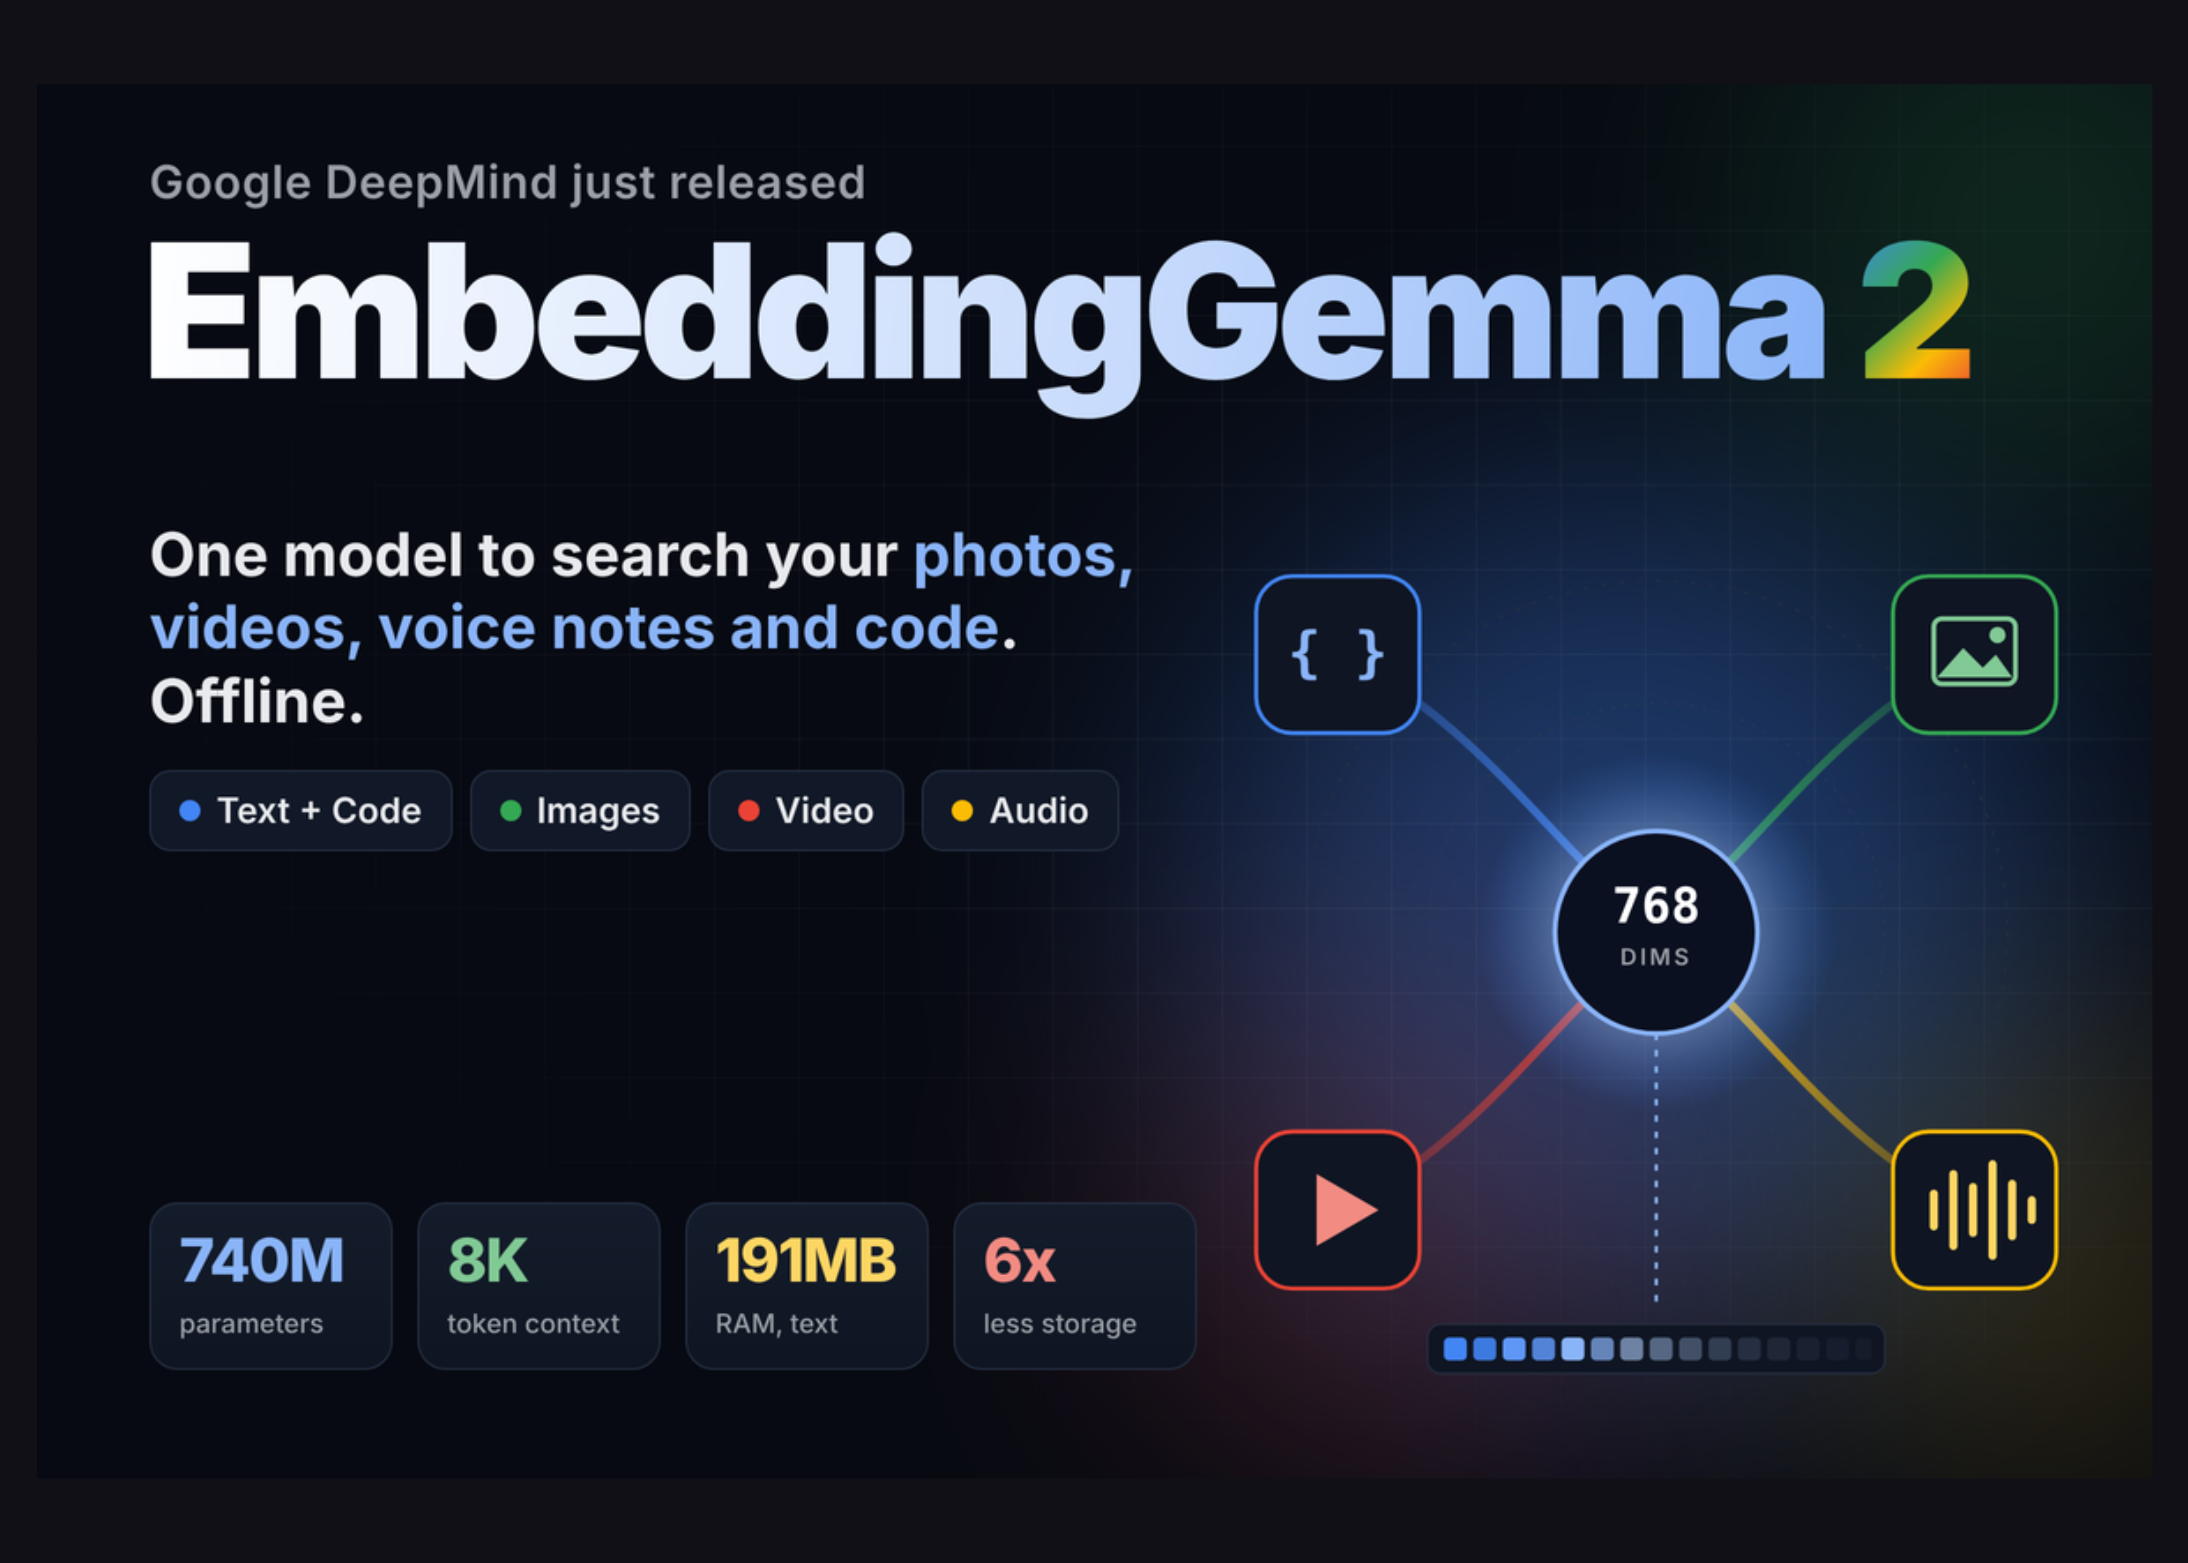
Según MarkTechPost, el 6 de octubre de 2026, Google DeepMind publicó EmbeddingGemma 2, un modelo de embeddings multimodal de pesos abiertos, 740 millones de parámetros, contexto de 8K y licencia Apache 2.0, que asigna texto, código, imágenes, vídeo y audio a un mismo espacio de 768 dimensiones. El troncal de texto, de 270 millones de parámetros, puede cargarse por separado.
Qué ha cambiado
Según MarkTechPost, el 6 de octubre de 2026, Google DeepMind publicó EmbeddingGemma 2, un modelo de embeddings multimodal de pesos abiertos basado en la arquitectura Gemma 4, con licencia Apache 2.0. Mediante codificadores modulares, asigna distintas modalidades a un mismo espacio vectorial de 768 dimensiones: el troncal de texto y código tiene unos 270 millones de parámetros (130 millones de transformer más 140 millones de embedder), el codificador visual de 170 millones de parámetros es opcional, el codificador de audio de 300 millones de parámetros es opcional y, con todo cargado, suma unos 740 millones de parámetros, de modo que los desarrolladores pueden cargar solo las partes necesarias. La ventana de contexto es de 8192 tokens, lo que según el reporte cuadruplica la de la primera generación y equivale aproximadamente a 29 imágenes, 58 fotogramas de vídeo o 5,5 minutos de audio. Según la tarjeta del modelo, MTEB Code v1 sube de 68,76 en la generación anterior a 78,68, MTEB multilingual v2 pasa de 61,15 a 61,36, y se añaden métricas como MIEB lite imagen 64,64, MMEB v2 puntuación total 59,01 y MAEB audio 49,39. El reporte indica que los pesos ya están disponibles en Hugging Face y Kaggle, y ofrece vías de ejecución como Ollama, llama.cpp GGUF, LiteRT, sentence-transformers v6.1.0+, vLLM, SGLang, MLX, LM Studio y MediaPipe; el almacenamiento vectorial está soportado por Qdrant y el ajuste fino por Unsloth; MRL permite truncar los vectores a 512, 256 y 128 dimensiones.
Impacto para desarrolladores
Para los desarrolladores, el cambio clave de este lanzamiento no es el número de parámetros, sino que un mismo espacio vectorial cubra a la vez código y audio, y que pueda cargarse solo el troncal de texto. Esto altera directamente tres tipos de decisión de selección. Primero, la capa de recuperación de RAG multimodal solía requerir dos modelos de embeddings, uno para texto y otro para imagen, dos índices y lógica de normalización de puntuaciones; el reporte afirma que los vectores de consulta generados por la configuración solo de texto pueden coincidir con los vectores de documentos generados por el modelo completo, y si esto se reproduce, significaría que puede indexarse primero con el troncal de 270 millones de parámetros y añadir después codificadores visuales o de audio sin reconstruir la base. Segundo, la magnitud de la mejora en los benchmarks de recuperación de código (según el reporte, unos 9,92 puntos, cerca del 14 %) lo sitúa como candidato en escenarios de búsqueda semántica de repositorios de código, pero se trata de cifras de la tarjeta del fabricante, no de una garantía de rendimiento en repositorios propios. Tercero, frente a Qwen3-VL-Embedding-2B de Alibaba plantea un compromiso distinto: según el reporte, este último reporta 73,2 puntos en su propia prueba MMEB v2, tiene aproximadamente 2,7 veces más parámetros y no soporta audio, mientras que EmbeddingGemma 2 destaca por el contexto de 8K, la memoria en dispositivo y el soporte de audio. Cabe señalar que pesos abiertos no equivale a una licencia de código abierto sin restricciones: Apache 2.0 es una licencia permisiva, pero el origen de los datos de entrenamiento y los requisitos de cumplimiento posteriores deben verificarse por cuenta propia. Además, el catálogo actual de modelos de KimiSeek no contiene ninguna entrada llamada EmbeddingGemma 2, por lo que esta versión no está disponible en KimiSeek; la disponibilidad mencionada en el reporte se refiere a canales externos como Hugging Face, Kaggle u Ollama, y si en el futuro se ofrece como API, deberá consultarse la página de su proveedor.
Integración y evaluación
Lo siguiente son recomendaciones y análisis de condiciones, no hechos reportados. Recomendación uno: determinar primero si se necesita recuperación transmodal. Si solo se trabaja con texto en chino y código, y ya se usa un modelo de embeddings de texto maduro, EmbeddingGemma 2 puede considerarse un candidato para A/B en lugar de un reemplazo inmediato; conviene hacer primero experimentos de recuperación con el mismo conjunto propio de consultas y documentos, evaluando con Recall@10 y nDCG@10 en lugar de mirar solo las puntuaciones MTEB. Si la carga de trabajo incluye realmente texto con imágenes o recuperación de notas de voz, vale la pena validar prioritariamente la hipótesis del espacio vectorial compartido: crear la base con el troncal de texto de 270 millones y luego embeber los mismos documentos con imágenes usando el modelo completo, midiendo la consistencia de similitud entre configuraciones; si el orden de relevancia se desvía claramente, habrá que crear índices separados para cada configuración. Recomendación dos: el compromiso entre dimensión y almacenamiento. El reporte indica que a 256 dimensiones MTEB multilingual solo baja ligeramente de 61,36 a 60,41, mientras que a 128 dimensiones MMEB cae a 45,65 y la recomendación oficial es usar 128 dimensiones principalmente para texto puro. Si el cuello de botella es el coste de almacenamiento del vector store y el escenario es solo texto, puede probarse primero con 256 dimensiones; si hay recuperación de imágenes o vídeo, conviene mantener 768 dimensiones y comparar en datos propios la diferencia de recuperación entre 256 y 768 dimensiones, fijando un umbral aceptable de pérdida de recuperación antes de decidir. Recomendación tres: el riesgo de dependencia del stack de despliegue. Hay muchos stacks ejecutables, por lo que la elección debe guiarse por el objetivo de servidor o de dispositivo, e incluir en la configuración la dimensión del vector, las plantillas de prompt (los nombres de prompt SearchQuery y Document mencionados en el reporte) y el método de cuantización, ejecutando una vez antes y después de la cuantización con un conjunto de regresión fijo para comparar la recuperación. En la evaluación es imprescindible usar datos propios de la empresa y no tablas públicas, porque la calidad multilingüe se mantiene prácticamente igual según el reporte y la mejora se concentra en código y en las nuevas modalidades.
Límites y cuestiones pendientes
Las cifras de benchmark, uso de memoria y latencia anteriores provienen de la tarjeta del modelo de Google o de declaraciones del propio equipo de investigación, son informes del fabricante y no han sido reproducidos por terceros independientes; los 191 MB y 567 MB en dispositivo son memoria activa tras cuantización en un dispositivo concreto (Pixel 11 Pro) y no pueden extrapolarse directamente a otro hardware. El reporte no revela la composición de los datos de entrenamiento ni detalles de la distribución de idiomas, por lo que el rendimiento real en escenarios en chino debe verificarse por cuenta propia. En la comparación entre modelos, los 73,2 puntos de Qwen3-VL-Embedding-2B corresponden a su propio criterio autodeclarado en MMEB v2, y las comparaciones parciales y las puntuaciones de distintas tablas no son directamente comparables. Además, la versión EmbeddingGemma 2 no aparece actualmente en el catálogo de modelos de KimiSeek, por lo que este artículo no la considera un modelo disponible en KimiSeek; la publicación de pesos, la descarga con Ollama y los distintos soportes de runtime mencionados en el reporte se refieren a lanzamientos de proveedores o de la comunidad en canales externos, y su disponibilidad y futuros precios deben consultarse en las páginas oficiales de las plataformas correspondientes. El reporte menciona que el soporte de ML Kit para Android llegará en unas semanas, lo que es un plan y no un hecho consumado, y no debe usarse para planificar plazos.
Ilustraciones de la noticia original