Lanzamiento de EmbeddingGemma 2: modelo de incrustación multimodal de 740 millones de parámetros con pesos abiertos bajo Apache 2.0
Según el blog oficial de Google DeepMind del 6 de octubre de 2026, EmbeddingGemma 2 se publica bajo licencia Apache 2.0, con 740 millones de parámetros, capaz de mapear texto, código, imagen, audio y vídeo a un espacio de incrustación unificado, con soporte para contexto de 8K y dimensiones de vector truncables.

Qué ha cambiado
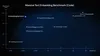
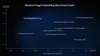
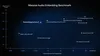
Según el blog oficial publicado por Google DeepMind el 6 de octubre de 2026, Google DeepMind presenta EmbeddingGemma 2, un modelo de incrustación multimodal orientado a inferencia en el dispositivo. El modelo se construye sobre la arquitectura Gemma 4, tiene 740 millones de parámetros y se publica bajo licencia Apache 2.0. La fuente afirma que puede mapear de forma nativa combinaciones de texto, código, imagen, audio y vídeo a un espacio de incrustación unificado, empleando tecnología de la misma raíz que Gemini Embedding. Los puntos de diseño reportados por la fuente incluyen: en escenarios de solo texto un mínimo de aproximadamente 270 millones de parámetros, con un codificador visual de aproximadamente 170 millones y un codificador de audio de aproximadamente 300 millones como módulos opcionales; mediante aprendizaje de representación Matryoshka se puede truncar el vector de salida de 768 dimensiones a 512, 256 o 128 dimensiones, y la fuente afirma que esto aporta hasta un ahorro de almacenamiento de aproximadamente 6 veces; la ventana de contexto es de 8K tokens, que según la fuente es 4 veces la de EmbeddingGemma 1, y puede procesar aproximadamente 5,5 minutos de audio, 29 imágenes o 58 fotogramas de vídeo. Los datos de referencia proporcionados por la fuente incluyen MTEB Code que pasa de 68,76 a 78,68, es decir, una mejora de 9,92 puntos en tareas de código, y afirma haber alcanzado un resultado líder entre los modelos de incrustación multimodal de menos de mil millones de parámetros. La fuente también afirma que tras la cuantización, en un Google Pixel 11 Pro los pesos de solo texto requieren aproximadamente 191 MB de memoria activa, y el modelo multimodal completo aproximadamente 567 MB. Los pesos ya están disponibles en Hugging Face y Kaggle; la fuente afirma que el soporte en Gemini Enterprise Agent Platform Model Garden llegará pronto, y la versión optimizada para el dispositivo se encuentra en LiteRT Community en Hugging Face.
Impacto para desarrolladores
Para los desarrolladores, la variable central de este lanzamiento es que los límites de capacidad del modelo de incrustación se extienden del texto a audio, vídeo y código, y que los pesos se publican bajo Apache 2.0, pudiendo ajustarse y redistribuirse, lo que impone restricciones distintas a las de los servicios de incrustación de código cerrado que solo se pueden invocar mediante API del proveedor. Cabe señalar que Apache 2.0 es una apertura a nivel de licencia, y que esto es distinto de si los pesos se pueden descargar; la información de licencia de este reportaje proviene del texto original de la fuente, y antes de usarlo conviene verificar la tarjeta del modelo y el archivo de licencia. La fuente afirma que EmbeddingGemma 2 comparte el tokenizador de texto y el codificador de audio con Gemma 4, lo que implica que al colocar el modelo de incrustación y el modelo generativo en un mismo flujo en el dispositivo, la fuente espera un menor uso total de memoria, lo que tiene impacto directo en el coste de despliegue de RAG sin conexión y agentes en el dispositivo. Las dimensiones de vector truncables son otra variable práctica: el almacenamiento y la calidad de recuperación de la base vectorial suelen compensarse a medida que disminuye la dimensión, y la elección entre 128 y 768 dimensiones debe medirse según la escala de los propios datos, sin aplicar directamente el discurso promocional de la fuente. La fuente también menciona que la cadena de herramientas de inferencia y despliegue disponible cubre transformers, sentence-transformers, MLX, vLLM, llama.cpp, SGLang, Ollama, LMStudio, así como transformers.js y WebGPU en el navegador, y para el almacenamiento vectorial menciona Qdrant. Estos nombres de herramientas son opciones de despliegue enumeradas por la fuente y no significan que esta plataforma haya integrado o verificado el modelo; esta versión no tiene actualmente una entrada de coincidencia exacta en el catálogo en vivo de KimiSeek, y la descarga de pesos y la capacidad de despliegue en el dispositivo mencionadas por la fuente apuntan a canales de editores como DeepMind y Hugging Face, no al suministro de API de esta plataforma.
Integración y evaluación
Recomendación uno: primero decida si necesita incrustación multimodal y luego si necesita el modelo completo. La fuente reporta que el multimodal completo en un Pixel 11 Pro tras cuantización requiere aproximadamente 567 MB de memoria activa, y solo texto aproximadamente 191 MB, y que los codificadores visual y de audio son módulos opcionales. Si su corpus de recuperación solo contiene texto y código, puede cargar primero solo la ruta de texto; si realmente tiene necesidades de recuperación de audio y vídeo, introduzca el codificador correspondiente. El criterio de evaluación accionable es: en el dispositivo objetivo o en la especificación de servidor mínima aceptable, medir la latencia de arranque en frío, el pico de memoria residente y el rendimiento de incrustación por segundo, y confirmar si aún se cumple el presupuesto de latencia. Recomendación dos: haga su propio experimento de recuperación con las dimensiones truncadas de MRL, en lugar de adoptar directamente las 768 dimensiones por defecto. La fuente ofrece tres niveles de 512, 256 y 128, y afirma un ahorro de almacenamiento de hasta 6 veces, pero si la calidad de recuperación es aceptable depende de su corpus y distribución de consultas. El criterio de evaluación puede establecerse como: en un conjunto de recuperación propio anotado o juzgado manualmente, comparar las diferencias entre 768 dimensiones y 256 y 128 dimensiones en Recall@10 y latencia media de consulta, y adoptar la dimensión más baja solo cuando la caída de calidad esté dentro de su umbral de negocio. Recomendación tres: si la recuperación de código es el escenario principal, puede considerar la mejora de MTEB Code reportada por la fuente como un objeto a reproducir. El criterio de evaluación puede establecerse como: en su propio repositorio de código, medir con el mismo conjunto de consultas la tasa de acierto y el rendimiento de recuperación entre lenguajes de EmbeddingGemma 1 y EmbeddingGemma 2, porque las puntuaciones absolutas de los benchmarks públicos no sustituyen una comparación relativa en un repositorio de código privado. Todo lo anterior son recomendaciones y análisis condicionales basados en la información de la fuente, no hechos consumados reportados por la fuente.
Límites y cuestiones pendientes
Primero hay que aclarar: EmbeddingGemma 2 no tiene actualmente una entrada de coincidencia exacta en el catálogo en vivo de KimiSeek, esta plataforma no aloja el modelo, y la descarga de pesos y la capacidad de despliegue en el dispositivo descritas por la fuente apuntan a canales de editores como DeepMind y Hugging Face, no al suministro de API de esta plataforma. Segundo, las puntuaciones de referencia de la fuente (incluida la mejora de MTEB Code de 68,76 a 78,68 y la afirmación de liderazgo por debajo de mil millones de parámetros) provienen de declaraciones del propio editor; el blog no enumera las condiciones completas de evaluación, la lista de modelos comparados ni la versión de evaluación, por lo que no pueden considerarse resultados verificados de forma independiente, y el rendimiento real debe reproducirse por cuenta propia. Tercero, los datos de memoria y almacenamiento proporcionados por la fuente (aproximadamente 191 MB, aproximadamente 567 MB, hasta 6 veces de ahorro) se basan en un modo de cuantización específico y en el dispositivo Google Pixel 11 Pro, y no necesariamente se cumplen en otro hardware o configuración de cuantización. Cuarto, la fuente afirma una ventaja de memoria conjunta por compartir tokenizador y codificador de audio con Gemma 4, pero su valor real no se proporciona en la fuente. Quinto, el soporte en Gemini Enterprise Agent Platform Model Garden está marcado en la fuente como "próximamente", lo que es una declaración de planificación y no significa que ya esté disponible; esta plataforma tampoco ofrece acceso API a este modelo. Los precios y la disponibilidad cambian con el tiempo, y los lectores deben guiarse por las páginas de precios y tarjetas de modelo actuales de cada editor.
Ilustraciones de la noticia original