GLM 5.3 llega a Amazon Bedrock: MoE de 753B en API gestionada, con caché de prompts explícita e inferencia entre regiones como focos de integración
Según una publicación oficial del blog de AWS del 5 de octubre de 2026, GLM 5.3 de Z.ai ya está disponible en Amazon Bedrock para clientes empresariales que cumplan los requisitos, puede invocarse mediante Responses/Chat Completions compatibles con OpenAI y mediante Invoke/Converse de Bedrock, admite caché de prompts implícita y explícita, configuraciones de inferencia entre regiones US y Global, y ofrece una vía para invocarlo con el agente de pruebas de penetración de código abierto Strix.
Qué ha cambiado
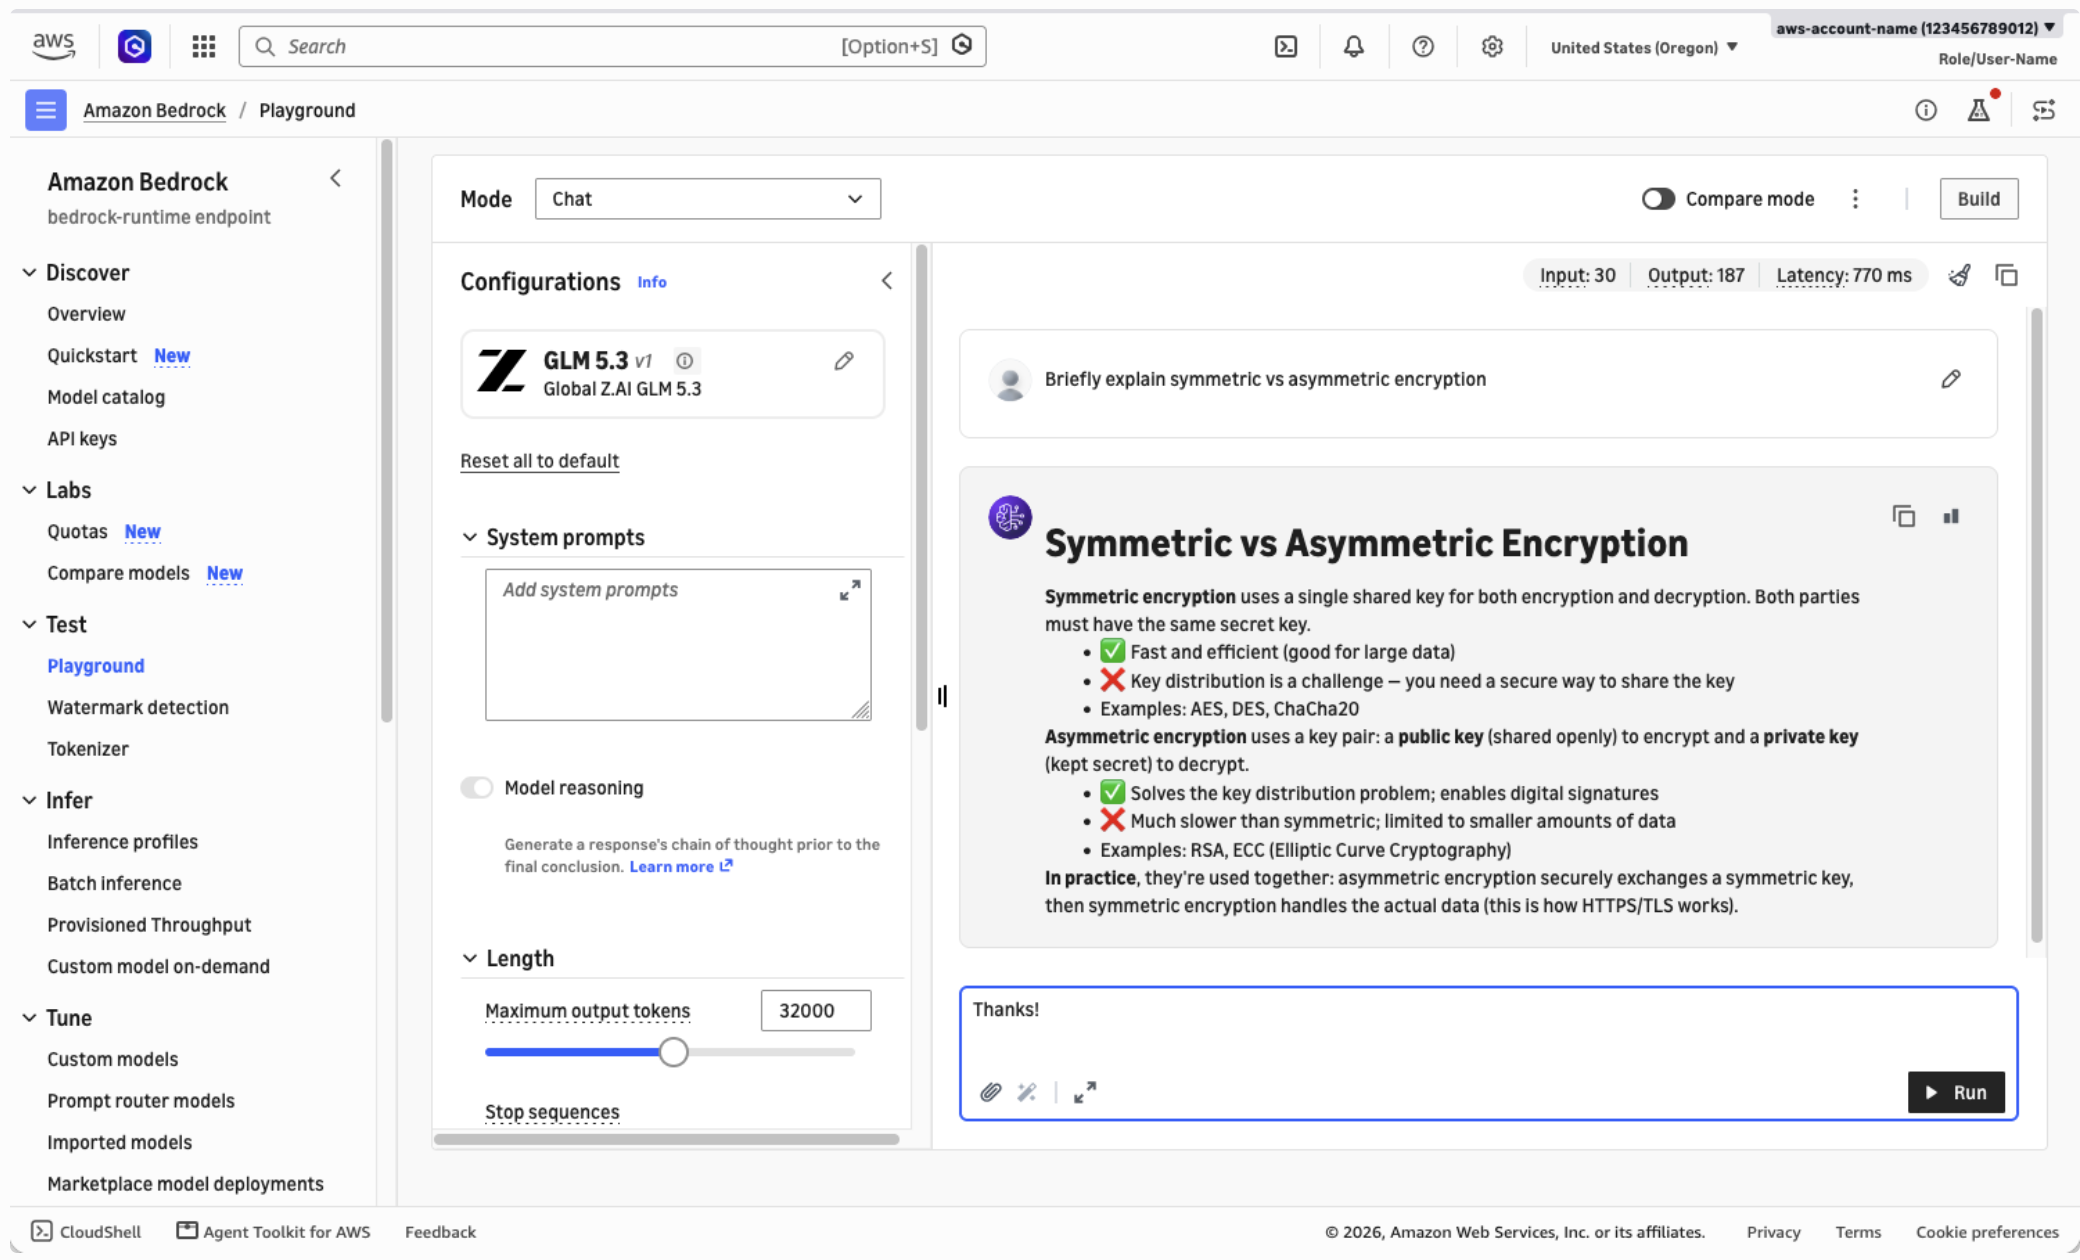
Según una publicación oficial del blog de AWS del 5 de octubre de 2026, GLM 5.3 de Z.ai (Zhipu AI) ya está disponible en Amazon Bedrock para clientes empresariales que cumplan los requisitos. El texto afirma que, según la información publicada en Hugging Face Hub, GLM 5.3 es un modelo de mezcla de expertos (MoE) de 753B parámetros, optimizado para tareas de programación y agentes de ciclo largo, y que Z.ai informa de un rendimiento destacado en tareas de seguridad, con 84,5 puntos en el benchmark CyberGym en el momento del lanzamiento. En comparación con GLM 5, que llegó a Bedrock a principios de este año, el texto enumera tres cambios: Z.ai afirma que es competitivo en benchmarks de programación como DeepSWE, Terminal Bench 3.0 y FrontierSWE, y que mejora un 50% respecto a GLM 5.2 en un benchmark interno de programación, pero no ofrece una comparación directa con GLM 5 porque los propios benchmarks se han actualizado desde GLM 5.1; la capacidad de seguridad se describe como "emergente"; y la integración con Bedrock es más completa. En cuanto al acceso, el modelo puede invocarse mediante el endpoint bedrock-runtime con las API Responses y Chat Completions compatibles con OpenAI, y también admite Invoke y Converse de Bedrock; AWS recomienda que las aplicaciones nuevas usen preferentemente la API compatible con OpenAI y credenciales de corta duración en lugar de claves de API de larga duración. El modelo se ofrece mediante dos perfiles de inferencia entre regiones, us.zai.glm-5.3 y global.zai.glm-5.3, y proporciona tres niveles de servicio: Flex, Priority y Standard.
Impacto para desarrolladores
Para los desarrolladores que están evaluando vías de alojamiento de modelos chinos, el cambio sustantivo de este acontecimiento no está en que "el modelo sea más potente", sino en la mejora de la superficie de invocación y de los medios de control de costes. Primero, que Bedrock ofrezca tanto interfaces compatibles con OpenAI como Invoke/Converse nativos significa que los cambios en el código existente del SDK de OpenAI se concentran en base_url, el método de autenticación (usar aws-bedrock-token-generator para canjear credenciales de AWS CLI por un token de corta duración) y el identificador del modelo, en lugar de reescribir la capa de invocación; para equipos que ya tienen varias adaptaciones compatibles con OpenAI, el coste de migración está sobre todo en credenciales y enrutamiento, no en la lógica de negocio. Segundo, la caché de prompts explícita está marcada por AWS como "recomendada"; para cargas de agentes que reenvían cada turno el prompt del sistema, definiciones de herramientas o archivos de repositorio, influye directamente en el coste de tokens de entrada y en la latencia del primer token, por lo que la tasa de aciertos de caché se convierte en una métrica de ingeniería observable. Tercero, los perfiles de inferencia entre regiones desacoplan "a qué región se envía la solicitud" de "dónde se procesa realmente"; los clientes empresariales deben revisar de nuevo la residencia de datos y los criterios de cumplimiento en lugar de suponer que la solicitud se ejecuta localmente. Cuarto, la documentación de Strix usa actualmente GLM 5.3 como modelo predeterminado y puede apuntar a Bedrock, lo que hace que la inferencia de cargas altamente sensibles como las pruebas de seguridad quede bajo el control de la propia cuenta de AWS, una opción significativa para los equipos de seguridad, aunque implica alcance de autorización y juicios de cumplimiento y no equivale simplemente a "listo para usar". Cabe señalar que las descripciones de capacidades anteriores provienen únicamente del blog unilateral de AWS y de benchmarks autoinformados por Z.ai, y aún no hay verificación independiente reproducida.
Integración y evaluación
Se recomienda evaluar con las siguientes reglas condicionales; son juicios basados en la fuente y no conclusiones ya verificadas. Primero, si cambiar a la interfaz compatible con OpenAI: si la aplicación existente ya se basa en el SDK de OpenAI y necesita el conjunto completo de funciones de caché explícita, según AWS conviene priorizar la API Responses compatible con OpenAI; si el código existente está profundamente vinculado a Bedrock Converse o necesita compartir la capa de invocación con otros modelos de Bedrock, conservar la interfaz nativa implica menos cambios. El requisito previo es que la cuenta ya disponga de los permisos bedrock:InvokeModel, bedrock:InvokeModelWithResponseStream y bedrock:CallWithBearerToken. Un criterio de evaluación medible es ejecutar dos turnos de conversación con el mismo prompt de sistema largo, comprobar si input_tokens_details.cached_tokens en la respuesta es distinto de cero y comparar la facturación de tokens de entrada y la diferencia de latencia del primer token entre ambos. Segundo, si activar la caché explícita: si la carga de trabajo reenvía cada turno grandes bloques de contexto estático (prompt del sistema, definiciones de herramientas, fragmentos de repositorio), según la fuente se recomienda cambiar al modo explicit de prompt_cache_options y marcar prompt_cache_breakpoint; si el contexto es corto o cambia con frecuencia, basta con la caché implícita y no merece la pena asumir el coste de mantenimiento de las marcas. El requisito previo es que cada punto de interrupción tenga al menos 1.024 tokens para ser elegible para caché; marcar prompts cortos no sirve. Un criterio medible es la proporción de tokens con acierto de caché bajo la misma carga y la magnitud de la reducción de la latencia de extremo a extremo, confirmando que la división de los puntos de interrupción no rompe los límites semánticos. Tercero, qué perfil de inferencia entre regiones elegir: los equipos orientados a usuarios de EE. UU. o con requisitos de cumplimiento ya existentes en la región us deberían evaluar us.zai.glm-5.3, y quienes necesiten una cobertura más amplia deberían evaluar global.zai.glm-5.3; la base de la elección son los requisitos de residencia de datos y las mediciones reales de latencia, no tomar "global" por defecto. Un criterio medible es la latencia P50/P95 de las solicitudes originadas desde la región de origen objetivo, junto con la conclusión por escrito de la revisión de cumplimiento sobre la región de procesamiento. Cuarto, nivel de servicio: para tareas no sensibles como procesamiento por lotes y análisis sin conexión, evaluar Flex para optimizar costes; para solicitudes sensibles a la latencia como asistentes de programación interactivos, evaluar Priority; y Standard como línea base predeterminada. El requisito previo es que la elección de nivel cambia el precio unitario, así que hay que verificar la facturación actual en la consola. En cualquier caso, conviene hacer primero una comparación a pequeña escala con el propio repositorio de código y trayectorias de agentes reales, en lugar de sustituir directamente el modelo predeterminado de producción.
Límites y cuestiones pendientes
Esta versión GLM 5.3 no aparece actualmente en el catálogo en tiempo real de KimiSeek; la disponibilidad en Bedrock, el identificador del modelo y los criterios de facturación mencionados en este artículo corresponden a AWS y a Z.ai y no representan la oferta en KimiSeek. En el catálogo de KimiSeek hay además entradas como GLM-5.3, GLM-5.3 Flash y GLM-5.2, que son versiones distintas o canales de suministro distintos, y no permiten inferir que la versión de Bedrock descrita aquí esté disponible en KimiSeek. Las afirmaciones de rendimiento de la fuente, incluidos los 84,5 de CyberGym, la mejora del 50% frente a GLM 5.2 en un benchmark interno de programación y las expresiones de "competitividad" en DeepSWE, Terminal Bench 3.0 y FrontierSWE, son autoinformadas por Z.ai o reproducidas por AWS, sin reproducción independiente, y los benchmarks también se han actualizado desde GLM 5.1, por lo que las comparaciones transversales deben hacerse con cautela. AWS indica explícitamente que GLM 5.3 está dirigido a "clientes empresariales que cumplan los requisitos"; la fuente no aclara si las cuentas normales pueden activarlo directamente ni si está disponible en todas las regiones. El texto original también menciona que LiteLLM todavía no podía resolver bedrock/global.zai.glm-5.3 en ese momento y que era necesario especificar explícitamente la ruta Converse y el ARN del perfil de inferencia; se trata de una limitación conocida en ese momento y se desconoce si se ha corregido después. La afirmación de que Strix usa GLM 5.3 como modelo predeterminado proviene de una descripción de la documentación "hasta el momento de redacción de este artículo" y puede haber cambiado. Los precios y los precios unitarios por nivel se ajustan con el tiempo; conviene guiarse por las páginas de precios en tiempo real de AWS y KimiSeek. El ejemplo de pruebas de seguridad solo se aplica a aplicaciones propias o con autorización por escrito, y el contenido de la fuente se corta en el párrafo sobre AWS Continuum.
Ilustraciones de la noticia original