JetBrains publica Mellum2.1 bajo Apache 2.0: modelo MoE de 12B para agentes de código, con pesos y versiones cuantizadas
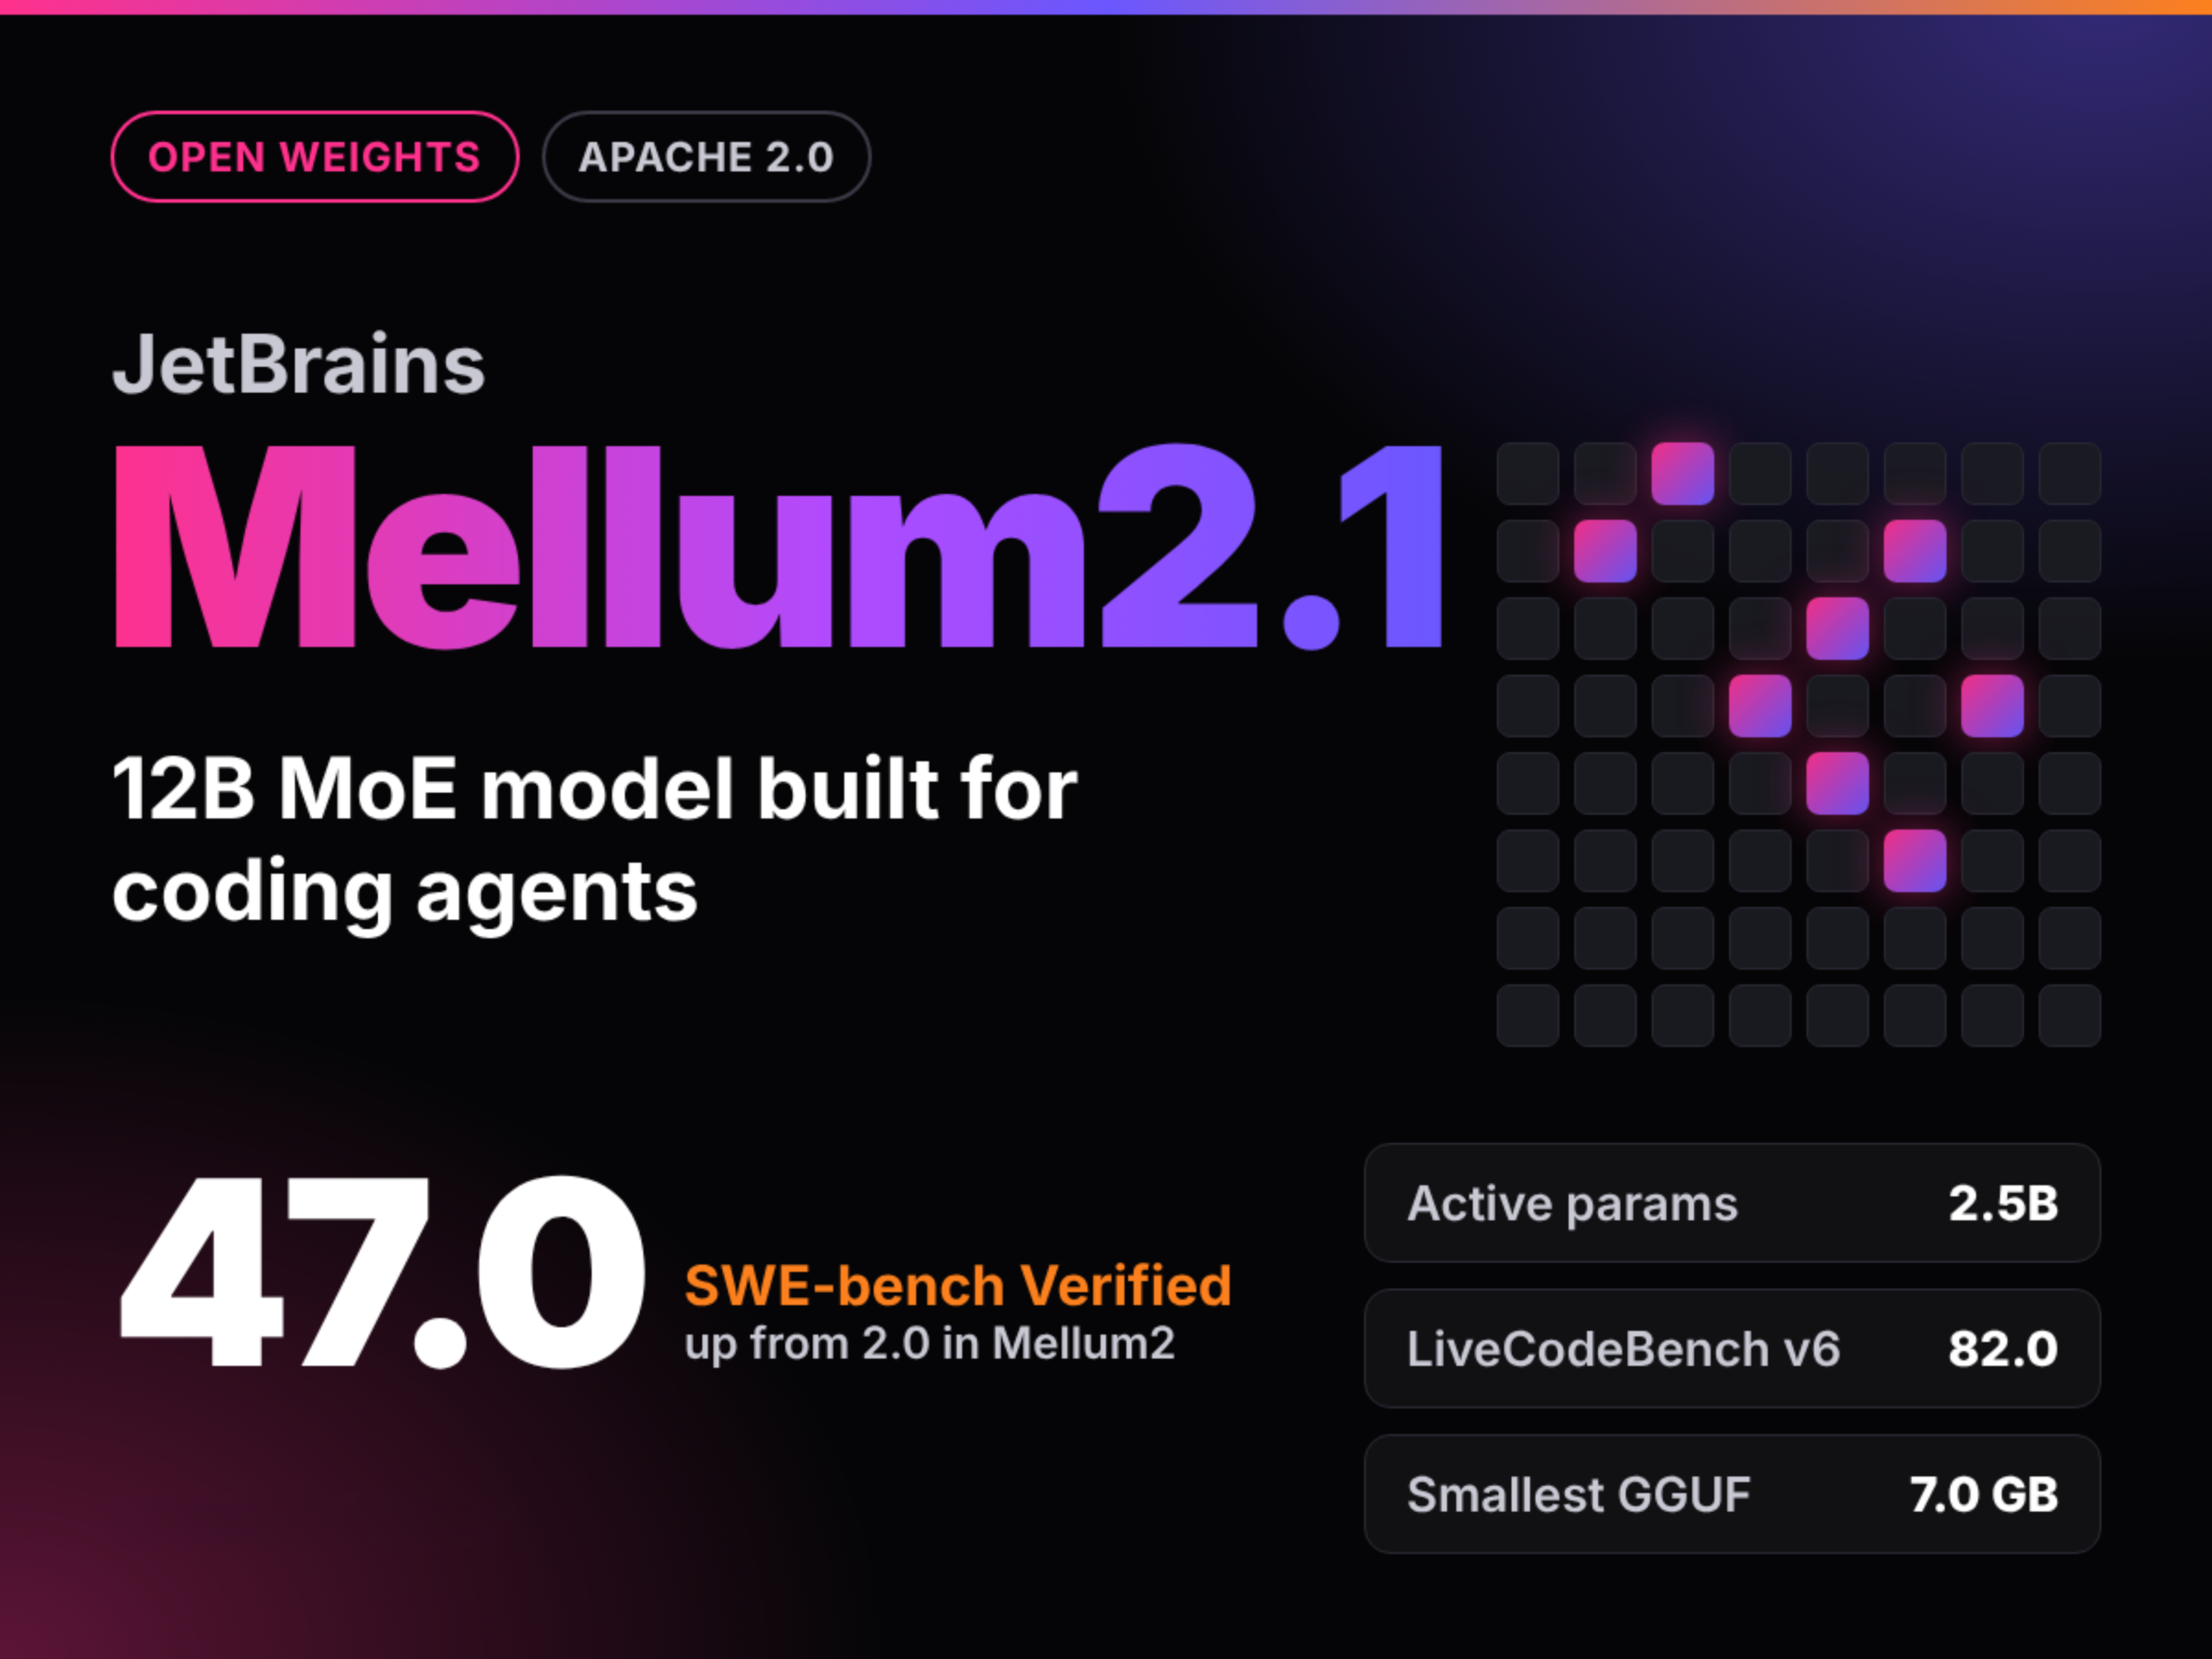
Según MarkTechPost, el 8 de octubre de 2026, JetBrains publicó Mellum2.1 bajo licencia Apache 2.0, concretamente Mellum2.1-12B-A2.5B-Thinking: un modelo MoE de razonamiento con 12B de parámetros totales y 2.5B activados por token, con la misma arquitectura que la generación anterior y mejoras provenientes sobre todo del aprendizaje por refuerzo en repositorios de código reales. El informe afirma que SWE-bench Verified subió de 2.0 a 47.0.
Qué ha cambiado
Según MarkTechPost, el 8 de octubre de 2026, JetBrains publicó Mellum2.1, cuyo checkpoint se denomina Mellum2.1-12B-A2.5B-Thinking, con pesos publicados en Hugging Face bajo licencia Apache 2.0. Es un modelo de razonamiento de mezcla de expertos con 12B de parámetros totales y 2.5B activados por token, 28 capas, 64 expertos, 8 activados por token, GQA (32 cabezas de consulta, 4 cabezas KV), ventana deslizante de 1024 tokens en 3 de cada 4 capas, contexto de 131072 tokens, vocabulario de 98304 y pesos en bfloat16. El informe señala que la arquitectura no cambió respecto de Mellum2 Thinking, publicado como código abierto en junio de 2026, y que la mejora proviene casi por completo del postentrenamiento: el RL pasa a ser el eje del entrenamiento, con tareas añadidas de matemáticas, programación competitiva, ciencia, llamada a herramientas e ingeniería de software, entrenadas en repositorios de código reales con herramientas de shell y edición de archivos, recompensando las pruebas superadas. El informe afirma que, en las pruebas propias de JetBrains, SWE-bench Verified subió de 2.0 a 47.0, SWE-bench Pro de 0.0 a 28.0 y Terminal-Bench 2.1 de 0.6 a 17.4, con LiveCodeBench v6 en 82.0, BFCL v4 en 62.3 y HarmBench bajando de 21.5 a 8.5; Qwen3.5-9B sigue por delante en SWE-bench Verified (50.0), SWE-bench Pro (38.0), GPQA Diamond (77.8) y AIME 25/26 (86.7).
Impacto para desarrolladores
Esta publicación tiene tres implicaciones para los agentes de código autoalojados, todas sujetas al relato del informe y no a una reproducción independiente. Primero, el modelo se publica con pesos abiertos bajo Apache 2.0, lo que constituye una publicación de pesos abiertos con licencia explícita, no solo pesos descargables; sin embargo, todas las puntuaciones de referencia del informe son autodeclaradas por JetBrains, y las cifras de LiveCodeBench v6 y GPQA Diamond de la tarjeta oficial de Qwen para el mismo modelo difieren notablemente del proceso de evaluación de JetBrains, lo que indica que las puntuaciones son sensibles al marco de evaluación y no deben tomarse como conclusiones comparables entre proveedores. Segundo, 2.5B de parámetros activados, junto con un contexto de 131072 tokens y cuantización GGUF, hacen viable un subagente local en entornos de consumo o de una sola GPU: el informe enumera versiones BF16 de 24.3 GB, Q8_0 de 12.9 GB, Q4_K_M de 8.1 GB (tasa de coincidencia del primer token del 88.0%) y MXFP4_MOE de 7.0 GB (85.6%). Los desarrolladores deben fijarse en si la degradación de capacidad tras la cuantización cae dentro de la tolerancia de su tarea, y no en el tamaño de un único archivo. Tercero, el informe afirma que el rendimiento bajo carga alta en una sola H200 se acerca al doble que el de Qwen3.5-9B, y que MTP acelera alrededor de 1.6 veces en escenarios de una sola solicitud, pero la cabeza MTP para decodificación especulativa en vLLM se señala como próxima, lo que significa que el despliegue actual no puede aprovechar esa aceleración directamente. Para los equipos que usan agentes de código, se trata más bien de un candidato a unidad de ejecución de bajo coste que de un sustituto principal de razonamiento general: el informe muestra que va por detrás en Terminal-Bench 2.1 y en referencias de conocimiento.
Integración y evaluación
Se recomienda validar por capas de tarea en lugar de sustituir toda la pila. Decisión uno: si la carga de trabajo es autocompletado de código o una unidad de ejecución de subagentes de alta concurrencia y pasos cortos, puede evaluarse primero el despliegue MoE con 12B/2.5B activados, siempre que se disponga de memoria de GPU de al menos una tarjeta y de un entorno vLLM o SGLang; el informe indica arrancar con vLLM y --reasoning-parser qwen3, añadir --enable-auto-tool-choice --tool-call-parser hermes para la llamada a herramientas, y usar temperatura 0.6, top_p 0.95 y top_k 20 como parámetros de muestreo; la métrica debería ser el rendimiento por token y el coste por tarea en el mismo hardware, no solo la puntuación de referencia. Decisión dos: si la carga es una reparación de repositorio de cadena larga, conviene hacer primero una comparación de muestra pequeña con repositorios propios frente a modelos como Qwen3.5-9B, comparando la tasa de tareas superadas y los modos de fallo, porque el SWE-bench Verified 47.0 autodeclarado es inferior al 50.0 de Qwen3.5-9B y la diferencia en Terminal-Bench 2.1 es aún más marcada; la condición aquí es que la empresa disponga de un conjunto de pruebas con veredicto automático; la métrica es la tasa de éxito de extremo a extremo y el número medio de pasos. Decisión tres: en entornos locales o sin conexión pueden probarse primero las versiones cuantizadas Q4_K_M y MXFP4_MOE, siempre que la tarea no sea sensible a la desviación de comportamiento del primer token; la métrica es la diferencia entre la tasa de coincidencia del primer token de la versión cuantizada y la de referencia BF16 sobre el propio conjunto de indicaciones, y la diferencia de precisión real. Además, la disponibilidad descrita en el informe se refiere a los pesos publicados por el proveedor y al soporte de los marcos de inferencia, y la forma de integración debe seguir la documentación de cada marco.
Límites y cuestiones pendientes
Deben explicitarse las limitaciones clave: Mellum2.1 no aparece en el catálogo de modelos en vivo de KimiSeek, por lo que esta versión no está actualmente disponible en KimiSeek; los pesos, los GGUF y las formas de despliegue con vLLM/SGLang mencionados en el informe se refieren a la publicación de JetBrains y no implican disponibilidad en este sitio. Todas las cifras de rendimiento provienen de JetBrains o de su proceso de evaluación unificado, incluidas SWE-bench, Terminal-Bench, LiveCodeBench y BFCL, y no han sido reproducidas de forma independiente; el propio informe señala que la tarjeta oficial de Qwen y la evaluación de JetBrains dan cifras distintas para el mismo modelo, por lo que las conclusiones comparativas deben tratarse con cautela. La tasa de coincidencia del primer token de las versiones cuantizadas no equivale a la tasa de acierto en la tarea; la lista de GGUF del informe y la nota de que "los GGUF siguen en preparación" presentan una discrepancia, y los archivos realmente disponibles y su calidad deben verificarse por cuenta propia. La cabeza MTP se señala como próxima, por lo que la aceleración por decodificación especulativa en vLLM aún no está disponible. Además, los precios de llamada y la facturación concretos deben consultarse en la página de precios del proveedor; este artículo no cita valores concretos.