Jiuzhang Yunji publica como código abierto Alaya-DFlash2, decodificación especulativa para GLM-5.3, con una aceleración declarada de 3,41 veces en contexto de 32k
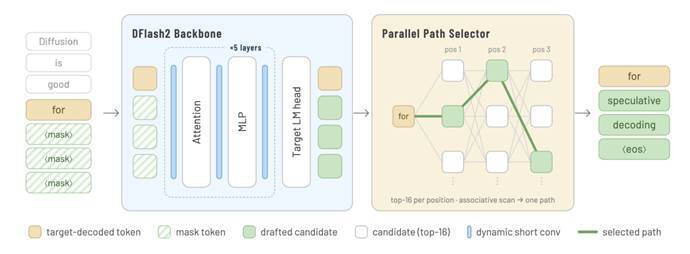
Según InfoQ, el 20 de octubre de 2026, Jiuzhang Yunji publicó como código abierto Alaya-DFlash2, un esquema de aceleración por decodificación especulativa para GLM-5.3, con un modelo borrador de redacción paralela y un mecanismo de selección de rutas, y publicó los pesos. La evaluación del fabricante afirma que, con 8×H200 y TP=8, la velocidad de decodificación con concurrencia 1 es 3,41 veces la del autoregresivo nativo, y que la longitud de aceptación en contextos de baja entropía de 1k a 32k supera a la de los dos esquemas comparados. Estas cifras y comparaciones son de autoevaluación del fabricante y aún no han sido reproducidas por terceros.
Qué ha cambiado
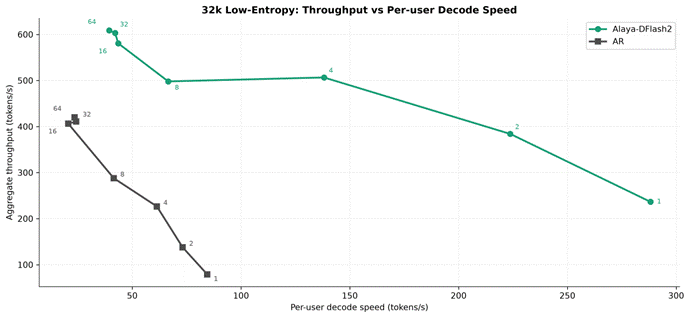
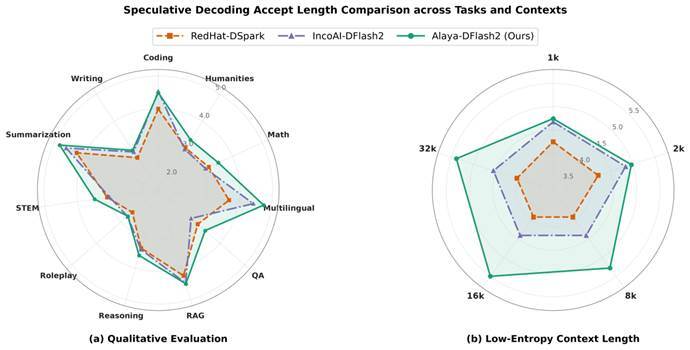
Según InfoQ, el 20 de octubre de 2026, Jiuzhang Yunji presentó Alaya-DFlash2, un esquema de aceleración por decodificación especulativa para GLM-5.3, compuesto por un modelo borrador capaz de redactar en paralelo y un mecanismo de selección de rutas; los pesos se publicaron bajo el nombre AlayaNeW/GLM-5.3-DFlash2, y la información no especifica los términos concretos de la licencia de código abierto. El reporte indica que el esquema se basa en el motor de cómputo inteligente AlayaNeW de Jiuzhang Yunji para entrenar un modelo borrador asociado en torno a GLM-5.3. En cuanto a la evaluación, el reporte ofrece datos en un entorno de 8×H200 y TP=8: la velocidad de decodificación con concurrencia 1 es de aproximadamente 288,2 tokens/s, frente a unos 84,5 tokens/s del autoregresivo nativo, lo que supone 3,41 veces; el rendimiento total de salida correspondiente pasa de 78,95 a 236,47 tokens/s. Al aumentar la concurrencia, la ventaja se reduce: con concurrencia 4 el rendimiento es 2,24 veces el del autoregresivo nativo, y con concurrencia 64 el rendimiento es de 608,71 tokens/s, un 44,9 % más que los 420,13 tokens/s del autoregresivo nativo. El reporte también enumera las longitudes de aceptación en contextos de baja entropía: 1k, 2k, 8k, 16k y 32k son 4,74, 4,97, 5,28, 5,50 y 5,39 respectivamente, superiores a las de IncoAI-DFlash2 y RedHat-DSpark evaluados; además, afirma que en 9 de 11 categorías de tareas la longitud de aceptación es líder, y que en las categorías de código y juego de rol es cercana a IncoAI-DFlash2.
Impacto para desarrolladores
El interés práctico de la decodificación especulativa para los desarrolladores radica en que modifica la estructura de costes de generación sobre el mismo hardware, no la capacidad del modelo en sí. Según el reporte, en escenarios de contexto largo la longitud de aceptación del borrador se mantiene en torno a 5, lo que significa que una pasada del modelo principal puede verificar y aceptar unos 5 tokens candidatos, reduciendo las rondas de decodificación repetida del modelo principal y comprimiendo directamente la espera de salida continua tras el primer token. Para los equipos que despliegan su propio servicio de inferencia de GLM-5.3, esto equivale a obtener rendimiento de decodificación sin cambiar el modelo principal ni modificar la distribución de salida, a costa de cargar adicionalmente un conjunto de pesos del modelo borrador y los correspondientes costes de memoria y planificación. El reporte también muestra que la ganancia varía con la concurrencia: la mejora de velocidad es máxima con concurrencia 1, mientras que con concurrencia 64 la mejora del rendimiento total se reduce al 44,9 %, lo que indica que el beneficio del esquema se manifiesta sobre todo en escenarios de interacción con baja concurrencia, y que en servicios de alta concurrencia el incremento de rendimiento por unidad es relativamente limitado. Cabe señalar que todas las cifras provienen de autoevaluación del fabricante, el entorno de prueba está fijado en TP=8 con 8×H200, la longitud de aceptación depende de la distribución concreta de los datos y podría comportarse de forma distinta fuera de contextos de baja entropía; además, la publicación de pesos no equivale a términos de licencia claros, por lo que antes de un uso comercial sigue siendo necesario verificar la información de licencia en el repositorio.
Integración y evaluación
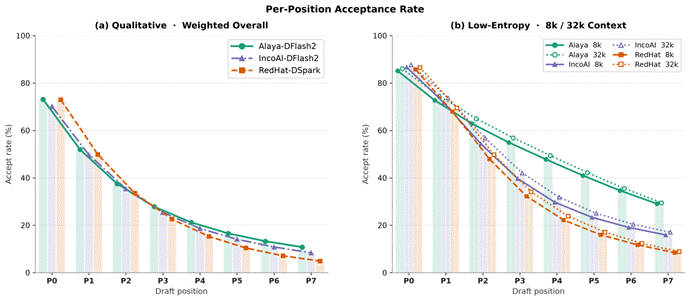
Se recomienda tomar decisiones según las siguientes condiciones, en lugar de adoptar directamente las conclusiones de la evaluación. La primera decisión es si incorporar este modelo borrador. Si la carga de inferencia se centra en contextos largos y concurrencia de baja a media, como preguntas y respuestas sobre documentos largos o resúmenes RAG, los datos del reporte de longitudes de aceptación superiores a 5 entre 16k y 32k respaldan realizar una prueba comparativa con tráfico real; si la carga se centra en solicitudes cortas de alta concurrencia, dado que el reporte indica que con concurrencia 64 el rendimiento solo mejora un 44,9 %, primero hay que calcular si merece la pena el consumo adicional de memoria y el coste de planificación que introduce el modelo borrador. El criterio de evaluación puede ser: medir la longitud de aceptación real y la latencia entre tokens sobre muestras propias de 32k; si la longitud de aceptación es claramente inferior a la del reporte o el incremento de memoria reduce el límite de concurrencia, no incorporarlo. La segunda decisión es la configuración del número de posiciones del borrador y del lote de verificación. El reporte muestra que la tasa de aceptación en la parte final del borrador sigue siendo considerable (en 32k, la quinta posición alcanza el 49,43 % y la octava el 29,51 %), lo que respalda ajustar la profundidad de verificación a un valor más profundo que el predeterminado; sin embargo, esta ganancia solo se sostiene si la tasa de aceptación en las posiciones finales se mantiene también en datos propios; si en tipos de tareas donde el reporte no obtuvo liderazgo, como código y juego de rol, la tasa de aceptación decae rápidamente, aumentar la longitud del borrador solo desperdiciará cómputo. El criterio de evaluación puede ser: registrar la tasa de aprobación por posición, identificar la posición en la que la tasa de aceptación cae por debajo del umbral fijado y truncar la longitud del borrador en consecuencia. Todas estas son recomendaciones condicionales basadas en los datos del reporte, no conclusiones de despliegue dadas por el fabricante.
Límites y cuestiones pendientes
Todos los datos de rendimiento del reporte provienen de autoevaluación de Jiuzhang Yunji, no se ofrece reproducción por terceros ni se divulgan los conjuntos de datos de prueba, las plantillas de prompt ni los parámetros de decodificación; la longitud de aceptación depende en gran medida de la distribución de los datos y podría no reproducirse con tráfico propio. El entorno de evaluación está fijado en 8×H200 y TP=8, y se desconoce el comportamiento en otro hardware y configuraciones de paralelismo. Lo que el reporte llama código abierto solo proporciona la dirección de los pesos, sin especificar el tipo de licencia; que los pesos estén disponibles no significa que los términos de licencia permitan cualquier uso comercial o redistribución, y hay que atenerse a lo declarado en el repositorio. Además, Alaya-DFlash2 es un esquema independiente de modelo borrador orientado a GLM-5.3, algo distinto del modelo principal en sí; GLM-5.3 sí tiene una entrada correspondiente en el catálogo actual de KimiSeek, pero el esquema de aceleración Alaya-DFlash2 en sí no está disponible como modelo invocable en KimiSeek, y su disponibilidad debe verificarse con el fabricante y el repositorio de pesos.
Ilustraciones de la noticia original