Kimi K3.1 Pro Highspeed llega a Bedrock: razonamiento predeterminado en max y límites en Flex y caché explícita
AWS afirma en un blog del 10 de noviembre de 2026 que Kimi K3.1 Pro Highspeed ya está disponible en Amazon Bedrock, que reutiliza el endpoint y la API de K3 y que Moonshot AI declara una velocidad de salida 2–3 veces la de K3.1 Pro; el razonamiento predeterminado en max, el coste de latencia de Flex y la falta de caché explícita en Converse son las tres decisiones previas a la integración.
Qué ha cambiado
AWS anunció en su blog de machine learning del 10 de noviembre de 2026 que Kimi K3.1 Pro Highspeed, de Moonshot AI, ya está disponible en Amazon Bedrock. El artículo lo describe como una versión post-entrenamiento de Kimi K3: mantiene la misma arquitectura de pesos abiertos de escala 3T y una ventana de contexto de 1 millón de tokens, y se entrenó con bastante más cómputo de post-entrenamiento; según Moonshot AI, ese entrenamiento se orienta a tareas de agentes de ciclo largo, busca reducir errores factuales y mejorar la modelización financiera, los documentos de oficina y la programación orientada a motores de juego, escenas 3D y scripts CAD. Su tasa de generación de tokens de salida es mayor, y Moonshot AI declara una velocidad 2–3 veces la de Kimi K3.1 Pro. En Bedrock reutiliza el endpoint, la API y las funciones de Kimi K3, de modo que una aplicación que ya usa K3 solo necesita cambiar el ID de modelo; admite llamadas a herramientas, salidas estructuradas, razonamiento configurable, entrada de imágenes y salida en streaming, y se accede mediante tres perfiles de inferencia entre regiones: global, us e in, siendo los requisitos de residencia de datos el criterio para elegir el perfil. AWS afirma que los datos se procesan dentro de su límite de datos, no se comparten con Moonshot AI ni se usan para entrenar modelos, que las solicitudes de inferencia tienen siempre la retención cero de datos activada y que los operadores no pueden ver prompts ni completaciones durante la inferencia. La serie K3.1 ya se había reportado antes; lo nuevo aquí es el canal gestionado de Bedrock y las opciones de inferencia y facturación que ello fija.
Impacto para desarrolladores
El impacto práctico para la integración se concentra en la forma de la interfaz y los valores predeterminados, no en la capacidad del modelo. Los equipos que ya usan el SDK de OpenAI solo tienen que apuntar base_url al endpoint de runtime de Bedrock y cambiar el nombre del modelo, pero la autenticación pasa a un bearer token de corta duración generado a partir de credenciales de AWS; IAM necesita los permisos InvokeModel e InvokeModelWithResponseStream, y con bearer token también CallWithBearerToken. Bedrock ofrece tanto Chat Completions y Responses compatibles con OpenAI como sus propios Converse e Invoke, y AWS recomienda los primeros. El segundo cambio es que el razonamiento viene al máximo por defecto: el modelo siempre razona antes de responder y, si no se fija la intensidad, toma max, lo que en tareas con poco espacio de respuesta como clasificación, extracción de campos o preguntas y respuestas cortas eleva directamente la latencia y los tokens de salida; al analizar la respuesta de Converse también hay que seleccionar el bloque de texto, porque la respuesta puede empezar con un bloque de razonamiento. El tercer punto son los niveles: AWS afirma que Flex se sirve a la mitad del precio de Standard, a cambio de un tiempo de respuesta potencialmente mayor, y que las cuotas bajo demanda se comparten entre Standard, Priority y Flex, de modo que mover tráfico a Flex no crea cuota adicional; el nivel se especifica por solicitud y una misma aplicación puede mezclarlos. El cuarto es el límite de interfaz de la caché: la caché de prompts explícita sirve para Chat Completions, Responses e Invoke, no para Converse; antes del punto de corte debe haber al menos 256 tokens de contenido estable, el contenido en caché se conserva al menos 30 minutos, la escritura se factura a una tarifa superior a la entrada estándar y la lectura a una tarifa con descuento y sin computar en la cuota de tokens de entrada por minuto. Para agentes y asistentes de programación que reenvían cada turno instrucciones de sistema, definiciones de herramientas y convenciones del repositorio, acertar en la caché suele pesar más en la factura que el precio unitario. El reportaje también explica por qué la velocidad de salida importa más en agentes de programación: leer archivos, planificar cambios, editar código, ejecutar pruebas y corregir fallos son una cadena de llamadas en serie en la que cada paso espera al anterior, y generar más tokens por unidad de tiempo acorta todo el bucle. Son cambios estructurales del lado del canal y no constituyen una verificación independiente de la calidad del modelo.
Integración y evaluación
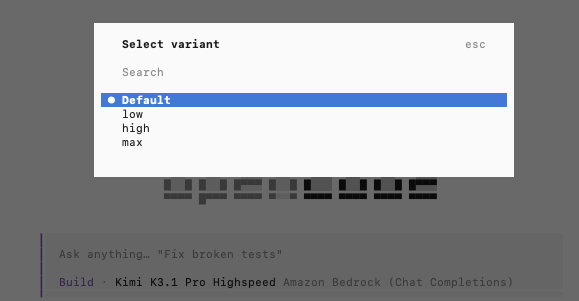
Lo siguiente es análisis condicional y recomendaciones basadas en ese reportaje; son sugerencias, no hechos verificados. Decisión uno: fijar explícitamente la intensidad de razonamiento en la configuración. El reportaje indica que sin definir reasoning_effort el valor predeterminado es max, con opciones low, high y max, y que en Responses el ajuste equivalente es reasoning.effort. Si tu carga es clasificación, extracción de campos, preguntas y respuestas cortas o reescritura con plantillas, tareas con poco espacio de respuesta, conviene fijar low o high según el tipo de tarea y reservar max solo para las rutas que realmente requieren razonamiento en varios pasos. La premisa es disponer de resultados de evaluación propios por nivel, no bajar por intuición; si la ruta impone un formato de salida estricto, confirma además que bajar el nivel no reduce campos de la salida estructurada. Criterio medible: sobre el mismo conjunto propio de preguntas, comparar la tasa de aprobación y la mediana de tokens de salida entre low y max; si la caída de aprobación cae en un rango aceptable y los tokens de salida bajan claramente, fija el nivel en la configuración en lugar de depender del valor predeterminado. Decisión dos: elegir el nivel de servicio por solicitud y comprobar cuál se aplicó realmente. AWS afirma que Flex puede tener más latencia pero menor precio, que el nivel se puede fijar por solicitud y que los tres comparten cuota. Si tu tarea es evaluación offline, resumen por lotes o pasos en segundo plano de un agente, insensible al tiempo de respuesta individual, puedes enviar una pequeña parte del tráfico a Flex y dejar las solicitudes síncronas de cara al usuario en Standard o Priority. La premisa es confirmar con las dimensiones ServiceTier y ResolvedServiceTier de CloudWatch qué nivel sirvió realmente la solicitud, porque pedir Flex y ser servido por Flex son cosas distintas, y mezclar niveles altera a la vez la latencia de cola y el consumo de cuota. Criterio medible: para el mismo lote de tareas, la latencia p95 y el coste por cada mil tareas en Flex y en Standard; ampliar la proporción solo si el coste mejora y la latencia de cola sigue dentro del presupuesto de timeout fijado. Decisión tres: tratar la disponibilidad de caché como condición de elección de interfaz, no como una optimización posterior. La caché explícita no está disponible en Converse, requiere al menos 256 tokens estables antes del punto de corte y conserva el contenido al menos 30 minutos. Si tu servicio ya está construido sobre Converse y el contexto contiene prefijos estables grandes (instrucciones de sistema, definiciones de herramientas, convenciones del repositorio), hay que elegir entre pasar a Chat Completions o Responses para obtener caché explícita y aceptar depender solo de la caché automática: lo primero puede elevar la tasa de acierto a cambio de cambiar la ruta de llamada y aceptar que la escritura de caché se factura a tarifa superior. Criterio medible: leer primero el número de tokens de caché en el uso devuelto para confirmar que el acierto es mayor que cero, comparar después el coste de entrada y la latencia del primer token antes y después de activarla y confirmar que un ajuste fino de la posición del punto de corte no hunde la tasa de acierto. Queda un punto que conviene cerrar en la revisión de arquitectura: el perfil global cuesta menos por token que los perfiles de alcance geográfico, pero si hay requisitos de residencia de datos solo se puede elegir us o in, y cambiarlo después del lanzamiento afecta la topología de despliegue. Si ya ejecutas negocio con Kimi K3 en Bedrock, la verificación mínima es mantener un conjunto de tareas y lanzarlas en paralelo contra K3 y Highspeed, comparando el tiempo de finalización por tarea y el número de reintentos fallidos, en lugar de mirar solo la velocidad del primer paquete.
Límites y cuestiones pendientes
Hay que preservar dos incertidumbres. Primera, el factor 2–3 es una velocidad declarada por Moonshot AI; el blog de AWS no aporta referencia, método de medición ni condiciones de concurrencia, la diferencia real depende de la longitud de salida y del nivel usado, y no debe tomarse como conclusión reproducida de forma independiente. Segunda, la expresión “arquitectura de pesos abiertos de escala 3T” describe la arquitectura, mientras Bedrock entrega un servicio de inferencia gestionado: si los pesos se pueden descargar y bajo qué licencia se publican no se deduce de esa frase y exige consultar el anuncio oficial y el texto de licencia de Moonshot AI; incluso si los pesos son descargables, pesos abiertos no equivale a licencia de código abierto. Hay otra confusión fácil: según el texto original, el mayor cómputo de post-entrenamiento, la reducción de errores factuales y las mejoras en capacidades profesionales como modelización financiera, documentos de oficina, motores de juego, 3D y scripts CAD son descripciones relativas a Kimi K3; entre Highspeed y el K3.1 Pro no Highspeed, la diferencia que da este artículo es principalmente la tasa de generación de tokens de salida, y el artículo no ofrece comparación capacidad por capacidad ni datos de evaluación independientes de Highspeed. La conservación “al menos 30 minutos” de la caché solo da un mínimo, no un máximo, y el coste de latencia de Flex solo se describe de forma cualitativa. Las regiones compatibles, las cuotas y los precios deben consultarse en la ficha del modelo, la página de disponibilidad regional y la de precios de Bedrock, que cambian; en la comprobación de este catálogo ya existe una entrada con el mismo nombre, cuyos precios y cuotas figuran en la página de precios del sitio, pero la inclusión en el catálogo y el lanzamiento en Bedrock son cosas independientes, y lo primero no verifica lo segundo.
Ilustraciones de la noticia original