Kimi K3.1 Pro: MoE de 2,8T/104B y contexto de 1M, API disponible
Según Marktechpost, el 23 de octubre de 2026, Moonshot AI lanzó Kimi K3.1 Pro, el primer modelo de la serie K3.1, con una arquitectura MoE de 2,8T parámetros totales y 104B activos, contexto de 1M tokens, ya disponible en la API de Kimi a un precio inferior al de K3, y pesos abiertos previstos para noviembre de 2026. Sus benchmarks autodeclarados se acercan a la frontera en codificación, pero quedan claramente por detrás en tareas de terminal científica.
Qué ha cambiado
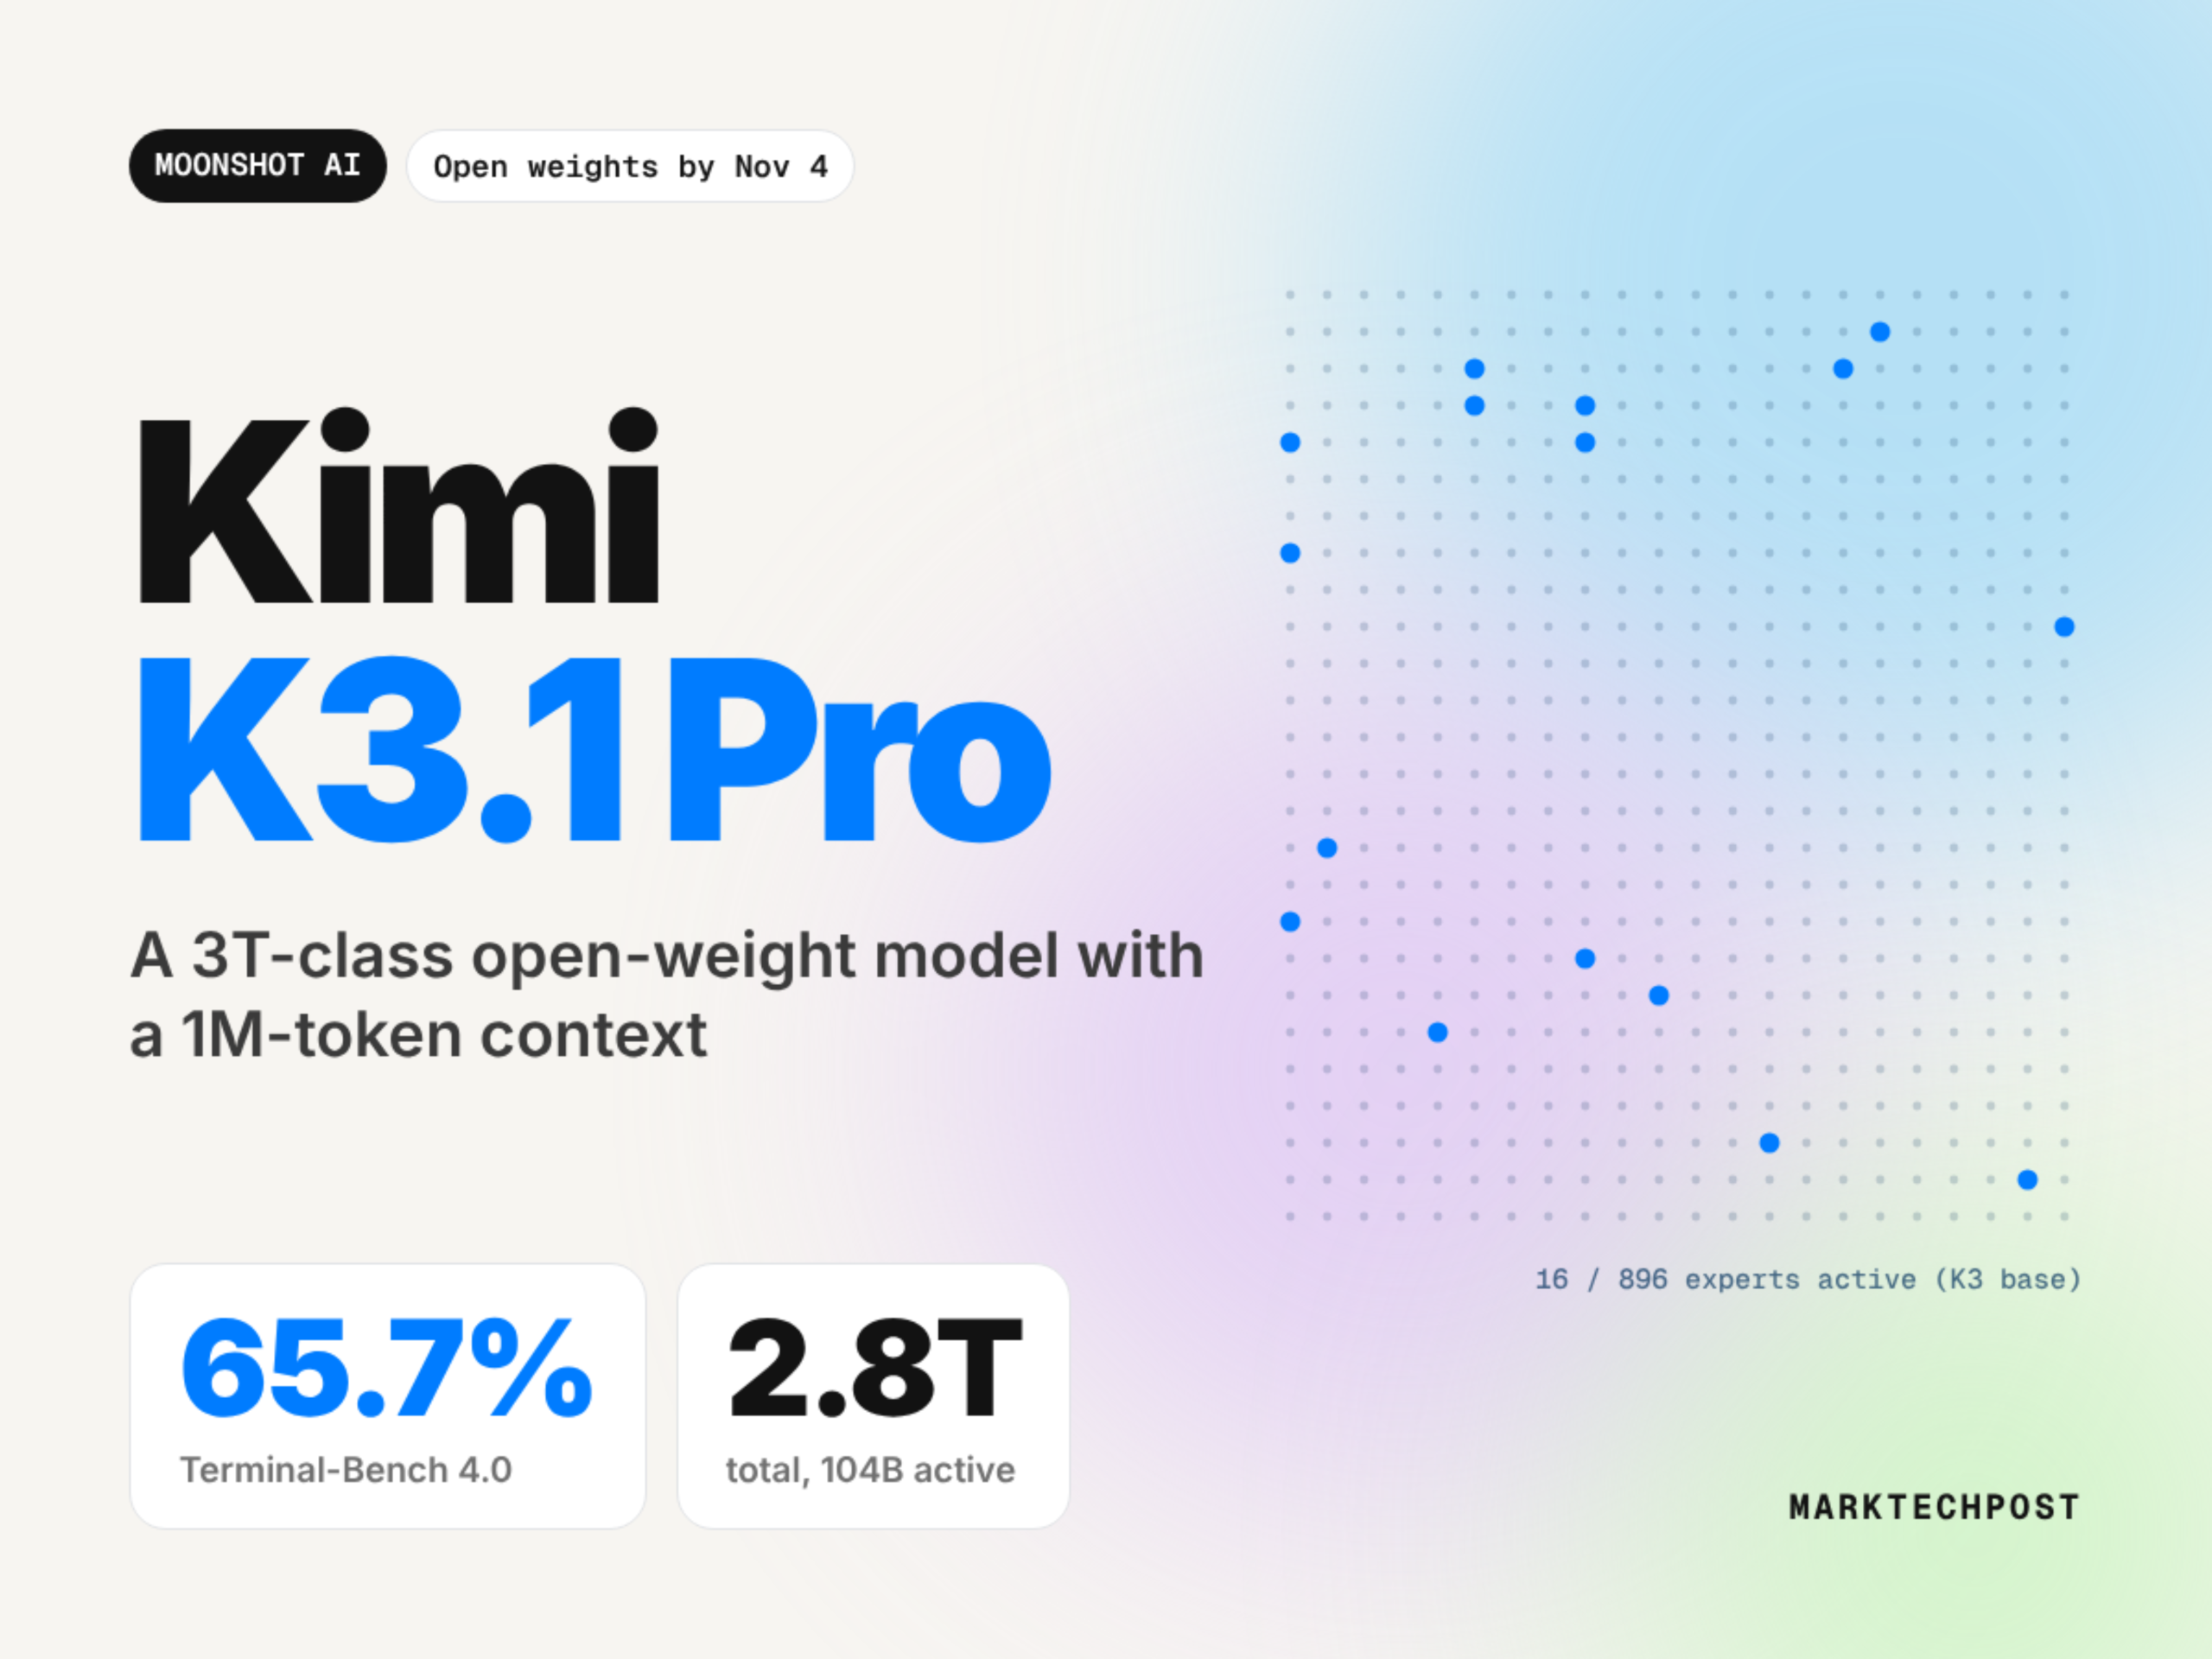
Según Marktechpost, el 23 de octubre de 2026, Moonshot AI lanzó Kimi K3.1 Pro, el primer modelo de la serie K3.1, una versión post-entrenamiento de K3, con un aumento reportado del cómputo de post-entrenamiento y aprendizaje por refuerzo conjunto en cientos de dominios downstream. La fuente indica 2,8T parámetros totales y 104B activos (MoE); la arquitectura base K3 usa Kimi Delta Attention y Attention Residuals, activa 16 de 896 expertos mediante Stable LatentMoE, admite contexto de 1M tokens y la API acepta texto, imágenes y vídeo. También se lanzó una variante Highspeed, que el blog oficial describe como 2 a 3 veces más rápida. Los identificadores de API son kimi-k3.1-pro y kimi-k3.1-pro-highspeed, con endpoint compatible con OpenAI. La fuente citada afirma que el precio de API es inferior al de K3, con facturación aparte por aciertos de caché; los pesos abiertos aún no se han publicado y se esperan para noviembre de 2026. Los datos de benchmark son autodeclarados por Moonshot, en su mayoría con máximo esfuerzo de razonamiento y el harness de Claude Code: Terminal-Bench 4.0 un 65,7%, SWE-Marathon 51,7, Terminal-Bench Science 0.1 solo 38,1, y en el interno Kimi Hallu Bench Hard la alucinación a nivel de afirmación bajó del 23,4% en K3 al 8,3%. La documentación de inicio rápido enumera varias limitaciones prácticas: el modo de pensamiento está siempre activo, el esfuerzo de razonamiento se divide en low, high y max (por defecto max); temperatura 1,0 y top-p 0,95 son valores fijos; la salida por defecto es de 131.072 tokens, con máximo de 1.048.576; la entrada visual no acepta URL de imágenes públicas, requiere base64 o ID de archivo subido.
Impacto para desarrolladores
El impacto directo para los desarrolladores se centra en tres puntos: forma de integración, estructura de costes y comportamiento con contexto largo. Primero, es el primer modelo de la serie K3.1; la información indica que es una iteración post-entrenamiento de K3 y no una arquitectura nueva, por lo que el coste de migración podría ser menor que un cambio de generación, pero hay que reconfirmar los identificadores de API y los parámetros del modo de pensamiento: como el modo de pensamiento está siempre activo y el esfuerzo de razonamiento por defecto es max, las rutas de llamada que antes dependían de desactivar el razonamiento o de controlar el presupuesto de pensamiento necesitan rediseñarse, o la latencia y el consumo de tokens serán superiores a lo esperado. Segundo, la fuente reporta que el modelo acepta texto, imágenes y vídeo vía API, pero no acepta URL de imágenes públicas y requiere base64 o ID de archivo subido, una restricción real para la construcción de peticiones, el tamaño y el flujo de subida en pipelines multimodales. Tercero, el contexto de 1M y el límite de salida de hasta 1.048.576 tokens permiten incluir repositorios o registros más largos en una sola petición, pero la fuente recuerda devolver el mensaje completo del asistente, y K3 ya advertía que descartar el historial de razonamiento en el harness provoca salidas inestables; si se mantiene la práctica de truncar el historial de razonamiento, el beneficio del contexto largo podría anularse. En cuanto al precio, la fuente afirma 2 USD por millón de tokens de entrada y 10 USD de salida para la versión estándar, y 4/20 USD para Highspeed, por debajo de los 3/15 USD de K3; se trata de precios del fabricante reproducidos por la fuente en la fecha del reportaje, y deben confirmarse con la página de precios de KimiSeek y la facturación real de las llamadas, ya que los precios cambian. Hay que dejar claro que K3.1 Pro no figura actualmente en el catálogo de modelos en vivo de KimiSeek; la disponibilidad de API mencionada por la fuente se refiere al lado del fabricante.
Integración y evaluación
Se sugiere avanzar con dos decisiones independientes, ambas como análisis condicional y no como conclusión de la fuente. Decisión uno: si migrar agentes de codificación o de terminal existentes de K3 a K3.1 Pro. El cambio reportado por la fuente es una mejora general en benchmarks de codificación y una bajada de precio, pero las tareas de terminal científica quedan claramente peor. La elección depende de la composición de tu carga de trabajo: si predominan codificación a nivel de repositorio, correcciones tipo SWE y automatización de terminal, se puede hacer un despliegue gradual con poco tráfico; si incluye una alta proporción de cálculo científico, simulación o tareas de terminal de investigación, conviene conservar el modelo anterior o enrutar en paralelo. Criterio medible: comparar en tu propio conjunto de tareas de codificación la tasa de finalización y la proporción que requiere corrección humana entre K3 y K3.1 Pro, registrando también el total de tokens necesarios para la misma calidad y calculando el coste por tarea con la estructura de precios reproducida por la fuente; solo ampliar el tráfico si la tasa de finalización no baja y el coste por tarea disminuye. Decisión dos: si activar la variante Highspeed. El cambio reportado es que Highspeed es 2 a 3 veces más rápida pero con precio unitario más alto, y el esfuerzo de razonamiento fijo en max. La elección depende de si hay restricciones de latencia interactiva: si se usa para autocompletado en IDE o bucles de agente con alternancia humano-máquina, y las peticiones toleran la longitud de salida que impone el esfuerzo de razonamiento max fijo, puede probarse Highspeed primero; si son tareas por lotes sin conexión y sensibles al coste, la versión estándar es más razonable. Criterio: medir con concurrencia fija la latencia P95 de extremo a extremo y las tareas completadas por segundo, y calcular si la reducción de latencia compensa el aumento del precio unitario. Condición previa común a ambas decisiones: verificar primero si los límites de parámetros de la documentación de inicio rápido coinciden con el cliente actual, en especial la temperatura y top-p fijos y que la entrada visual no acepta URL públicas; antes de cualquier cambio, mantener un interruptor de reversión, porque los pesos abiertos aún no se han publicado y a corto plazo no es posible autohospedarlo.
Límites y cuestiones pendientes
Hay que dejar claro que Kimi K3.1 Pro no está actualmente en el catálogo de modelos en vivo de KimiSeek; la disponibilidad de API mencionada por la fuente se refiere al lado del fabricante, y antes de integrarlo conviene guiarse por la documentación del fabricante y el catálogo real. La mayoría de las cifras de benchmark de la fuente son autodeclaradas por Moonshot, en su mayoría con máximo esfuerzo de razonamiento y el harness de Claude Code, y los gráficos comparativos provienen de la página de comparación del fabricante, sin confirmación en páginas de competidores, por lo que no deben tomarse como conclusiones de rendimiento verificadas de forma independiente; algunas victorias provienen de benchmarks internos. El claro retraso en tareas de terminal científica es una carencia señalada por la propia fuente, pero sus valores concretos también son autodeclarados. Los pesos abiertos se esperan para noviembre de 2026, una fecha anticipada por la fuente que puede cambiar; actualmente no es posible autohospedarlo, y la escala de 2,8T apunta a un despliegue de servicio en múltiples nodos. El precio es el del fabricante reproducido por la fuente en la fecha del reportaje y puede ajustarse en cualquier momento. Los límites de parámetros de petición, el modo de pensamiento siempre activo y la temperatura fija provienen de la documentación de inicio rápido citada por la fuente; el comportamiento real debe confirmarse con la documentación más reciente del fabricante. Además, ya ha habido reportes recientes sobre el lanzamiento de este modelo; el valor de esta fuente está en añadir limitaciones de integración y detalles técnicos, no en confirmar la primicia.