Liquid AI publica LFM3: seis modelos del nivel 2B comparten un backbone y los pesos abiertos marcan las decisiones para el dispositivo
Según el blog de Liquid AI del 27 de octubre de 2026, LFM3 unifica los modelos de texto, visión, audio, omni y de decisión en un backbone compartido de aproximadamente 1,7B de parámetros; afirma que todos tienen pesos abiertos y se pueden afinar en una sola GPU. Los desarrolladores deben reconsiderar las dos rutas: un único modelo omni o modelos pequeños especializados.

Qué ha cambiado
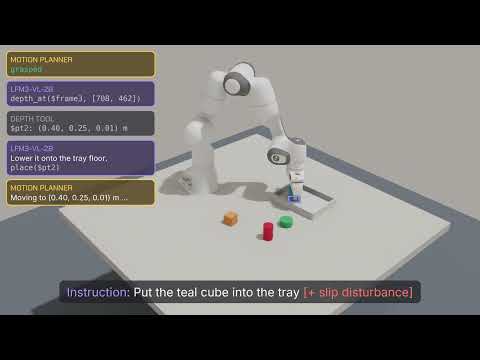
Liquid AI publicó la serie LFM3 en su blog oficial el 27 de octubre de 2026. Según el blog, la serie incluye seis modelos del nivel 2B: LFM3-1.7B (texto), LFM3-VL-2B (entrada de texto, imagen y vídeo), LFM3-Audio-2B (entrada de texto y audio, salida de texto y voz), LFM3-Omni-2B (entrada omni, salida de texto y voz), y los modelos de decisión d1-2B y d1-omni-2B basados en las ramas de visión y omni; además, LFM3-1.7B-Base para post-entrenamiento propio. El fabricante afirma que todos los modelos derivan de un mismo backbone, están disponibles en Hugging Face y pueden afinarse en una sola GPU; el modelo de texto ocupa unos 1 GB en precisión de 4 bits y la ventana de contexto del backbone se amplía a 256K tokens. El blog también ofrece varias cifras comparativas, por ejemplo LFM3-1.7B obtiene 38.42 en WebArena-Verified frente a 3.02 de la generación anterior LFM2.5-2.6B; y la media de LFM3-VL-2B en 62 benchmarks visuales sube de 57.6 a 71.4. El fabricante también afirma que, en términos de parámetros, LFM3-1.7B es comparable a LFM2-1.2B en dispositivos de borde con prompts cortos, y aproximadamente un 25% más rápido cuando el contexto contiene 8K tokens. Todas estas cifras son declaradas por el fabricante y no se ha visto una reproducción por terceros.
Impacto para desarrolladores
El impacto principal de este lanzamiento para los desarrolladores no es un modelo más, sino un cambio en la granularidad de la selección: antes, para ejecutar multimodalidad en el dispositivo, a menudo había que encadenar ASR, un modelo de visión-lenguaje y TTS en una tubería; ahora el fabricante ofrece una opción de modelo omni único. Pero al mismo tiempo conserva modelos unimodales, lo que indica que fusionar la multimodalidad no necesariamente es rentable en todos los escenarios. Las restricciones del lado de la inferencia también cambian: el modelo de visión exige transformers 5.21.0 o superior, los modelos de audio y omni exigen 5.20.2 o superior, y d1 exige 5.19 o superior; además, la mayoría de los ejemplos dependen de trust_remote_code, por lo que actualizar el framework y revisar el código remoto personalizado se convertirá en una tarea previa a la integración. En cuanto a la memoria en el dispositivo, que el modelo de texto ocupe unos 1 GB en 4 bits es una cifra planificable, pero el blog no ofrece el consumo de VRAM o memoria de los modelos de visión y audio; el coste real de recursos de la entrada de vídeo y la salida de voz en streaming debe medirse por cuenta propia. El blog destaca la eficiencia del nuevo codificador visual y de LiquidCodec, y afirma que el primer token de audio puede llegar a 50 ms y que la síntesis de voz es aproximadamente 87 veces en tiempo real en un solo hilo de CPU; estos indicadores dependen en gran medida del hardware y de la longitud de la entrada, y no deberían usarse directamente como base para la planificación de capacidad en producción. El fabricante también ofrece notebooks de afinado que cubren SFT, DPO, GRPO y preentrenamiento continuo; para los equipos que necesitan terminología privada y llamadas a herramientas, esto es más valioso de probar primero que las puntuaciones de los benchmarks.
Integración y evaluación
Recomendación 1 (análisis condicional): si la aplicación en el dispositivo necesita procesar voz e imagen en la misma solicitud, primero compara el modelo omni único con la combinación de "modelo de audio + modelo de visión". La condición es que realmente exista una relación entre modalidades dentro de una misma solicitud, por ejemplo, formular una pregunta hablando mientras se muestra un fotograma; si el audio y el vídeo no están relacionados en el negocio, los modelos especializados suelen ofrecer mejor control. Criterio medible: comparar en el mismo lote de muestras reales la latencia del primer token, el tiempo de finalización de extremo a extremo y el pico de memoria, y comprobar si el modelo omni presenta una degradación evidente frente a los modelos especializados en subtareas de solo texto o solo voz. Recomendación 2 (análisis condicional): si ya tienes un servicio de inferencia basado en la serie LFM2.5, no cambies directamente basándote solo en cifras del fabricante como 38.42 frente a 3.02 en WebArena-Verified; primero haz una prueba A/B con tus propias trayectorias de agente. La condición es que la carga de trabajo se base principalmente en llamadas a herramientas con contexto largo; el blog afirma que las mejoras se concentran en tareas de agente y contexto largo, y que la comparación con prompts cortos se calcula por parámetros, no implica igualdad de rendimiento absoluto. Criterio medible: en tu propio conjunto de tareas, registrar la tasa de éxito de llamadas a herramientas, la tasa de cumplimiento de formato y el tiempo real por cada mil tokens, en lugar de mirar solo las clasificaciones públicas. Recomendación 3 (análisis condicional): si te interesa más el juicio estructurado que la generación de texto, puedes evaluar si d1-2B sustituye la solución de "modelo de lenguaje pequeño + postprocesamiento de análisis". La condición es que el negocio acepte salidas de probabilidad calibradas en lugar de lenguaje natural; si la fase posterior necesita texto explicable, la ruta d1 no es adecuada. Criterio medible: usar tickets históricos o facturas anotadas para calcular el error de calibración de cada campo y comparar la latencia de una pasada hacia delante con la tubería actual.
Límites y cuestiones pendientes
La fuente es un blog del fabricante; las puntuaciones de benchmark, la velocidad y las cifras de memoria son declaradas por el fabricante, sin reproducción independiente ni metodología de evaluación completa; también hay que verificar por cuenta propia los criterios de comparación internos del blog (por ejemplo, algunas comparaciones de codificadores usan un backbone de lenguaje LFM2.5-230M común). El blog afirma que todos los modelos LFM3 tienen pesos abiertos, pero el texto no especifica los términos de la licencia; pesos abiertos no equivale a licencia de código abierto, y los derechos de uso comercial, redistribución y publicación tras el afinado deben verificarse en la model card y el texto de la licencia, no inferirse de que los pesos se puedan descargar. Los modelos LFM3 no tienen actualmente una entrada correspondiente en el catálogo en línea de KimiSeek; esta versión no está disponible en KimiSeek por ahora, y el blog tampoco ofrece una API alojada: la disponibilidad que menciona se refiere a la descarga de pesos en Hugging Face y a la ejecución local. Si más adelante aparece un servicio alojado o una tarifa aparte, debe prevalecer la página oficial. Además, los ejemplos dependen de trust_remote_code, por lo que en producción hay que auditar el código remoto por cuenta propia; el efecto real y el consumo de recursos de la entrada de vídeo, la voz en streaming y la traducción de voz multilingüe solo se ilustran con algunos ejemplos en el blog y requieren verificación propia.
Ilustraciones de la noticia original