Meta abre los pesos de Muse Spark Open: MoE de 816.000 millones ejecutable en dos Mac Studio, por debajo de GLM 5.3 max y Kimi K3 max en benchmarks de código
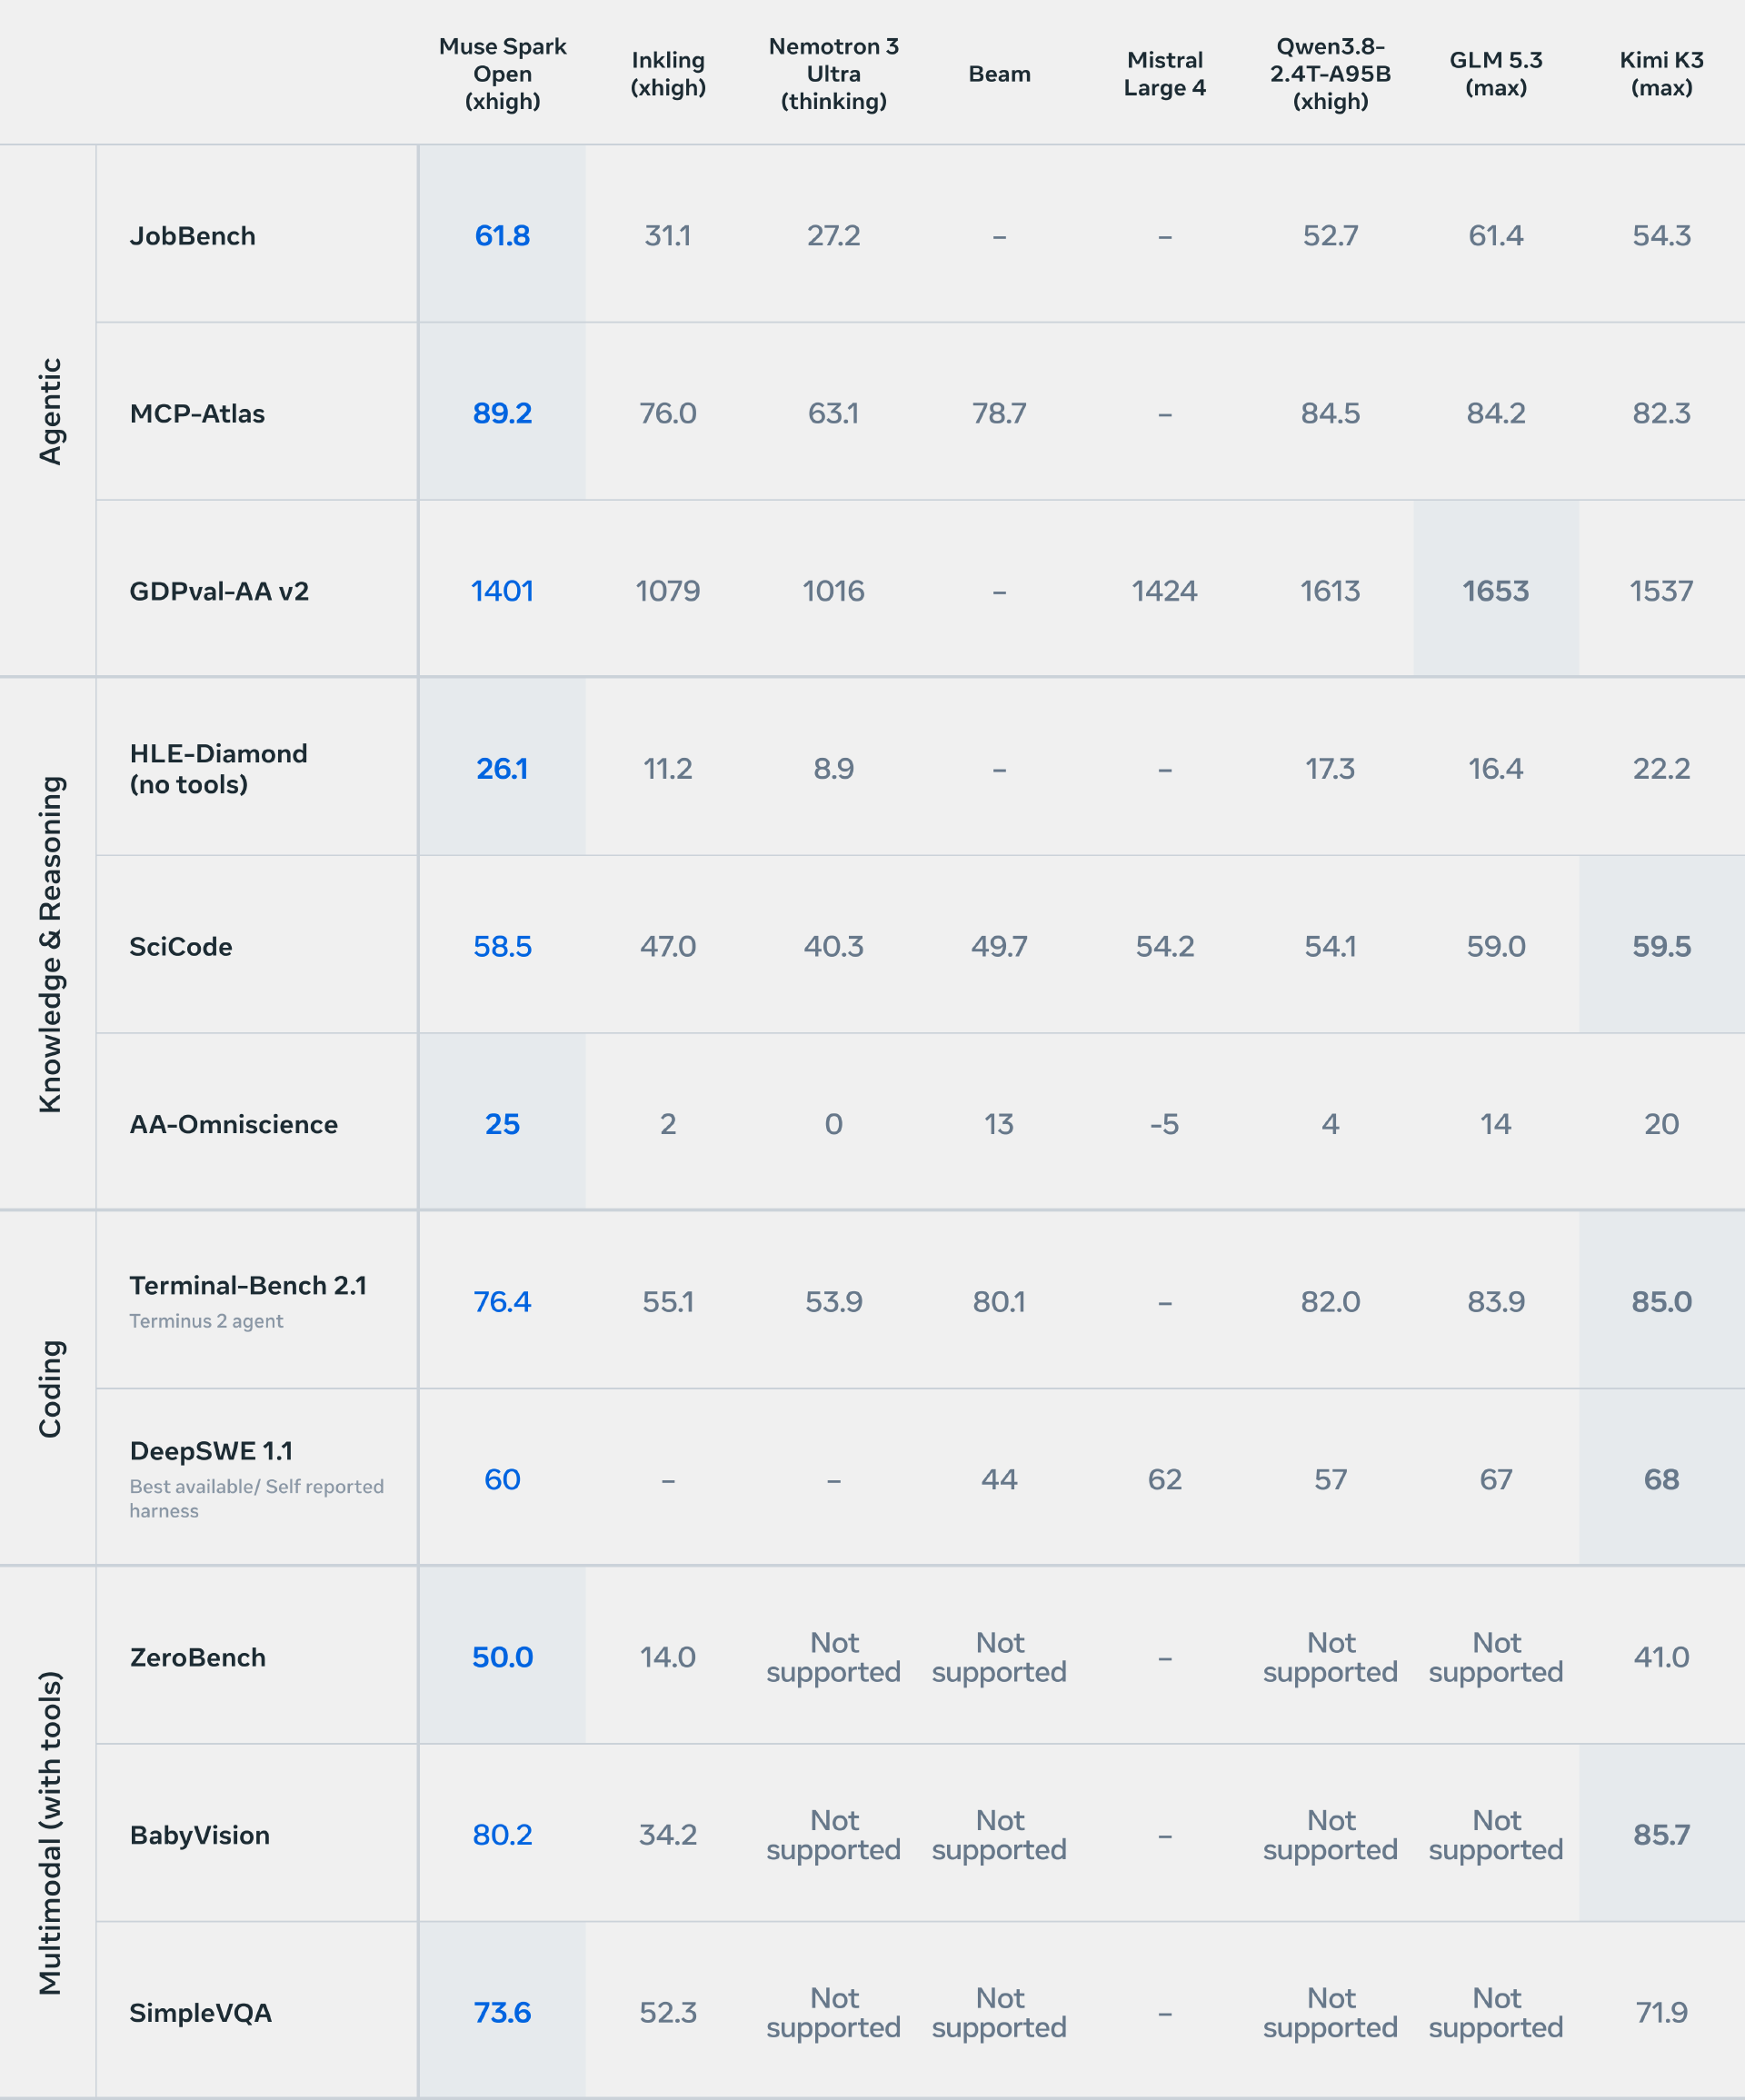
Según InfoQ el 18 de octubre de 2026, Meta abrió el 15 de octubre los pesos de Muse Spark Open: un MoE disperso de 816.000 millones de parámetros totales y unos 42.000 millones activados, con contexto de aproximadamente 1,05 millones de tokens y entrada de texto, imagen, audio y vídeo, desplegable con MLX en dos Mac Studio M5 Ultra; el reporte indica que sus resultados en Terminal-Bench 2.1 y DeepSWE 1.1 quedan por debajo de GLM 5.3 max y Kimi K3 max, bajo licencia Muse Model License.
Qué ha cambiado
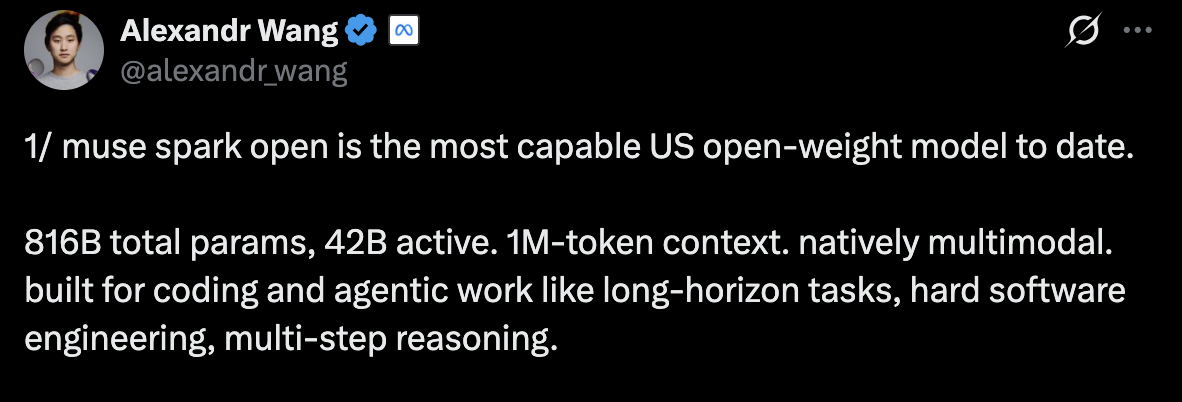
Según InfoQ el 18 de octubre de 2026, Meta anunció el 15 de octubre, hora local, la apertura de los pesos del modelo Muse Spark Open, posicionado como un modelo de agente grande orientado a ingeniería de software, ejecución de tareas de largo horizonte y razonamiento de varios pasos; Meta lo describe como el modelo de pesos abiertos más capaz de Estados Unidos hasta la fecha. El modelo emplea una arquitectura de mezcla de expertos dispersa, con 816.000 millones de parámetros totales y unos 42.000 millones activados por token, admite un contexto de 1.048.576 tokens, recibe entradas de texto, imagen, audio y vídeo, y produce salida de texto. El reporte señala que los resultados publicados por Meta son JobBench 61,8, MCP-Atlas 89,2, OSWorld Verified 80,4; en código, Terminal-Bench 2.1 es 76,4 y DeepSWE 1.1 es 60, y señala que estos dos últimos quedan por debajo de los modelos abiertos chinos GLM 5.3 max y Kimi K3 max. La ejecución local se realiza mediante MLX en dos Mac Studio con M5 Ultra; Apple publicó una prueba distribuida en cuatro máquinas con velocidad de generación superior a 36 tokens por segundo; la documentación oficial muestra pesos BF16 de aproximadamente 1,65 TB y NVFP4 de aproximadamente 537 GB. La licencia es Muse Model License, exige mostrar una atribución designada e impone a los licenciatarios con ingresos anuales agregados superiores a 20 millones de dólares que ofrezcan el modelo como servicio, requisitos de notificación y un acuerdo escrito por separado, además de enumerar excepciones para uso interno e investigación.
Impacto para desarrolladores
Para los desarrolladores, el significado directo de este lanzamiento no es "un peso descargable más", sino que divide las variables de decisión del despliegue de modelos grandes en tres cosas: almacenamiento de pesos, cómputo por token y comunicación entre dispositivos. La distinción entre 816.000 millones de parámetros totales y unos 42.000 millones activados es clave: lo primero determina si cabe o no, lo segundo determina si se puede calcular o no. Según los datos del reporte, BF16 de aproximadamente 1,65 TB requiere 8 tarjetas B300, NVFP4 de aproximadamente 537 GB requiere 4 tarjetas B300, y la prueba de Apple usó NVFP4, no BF16; esto implica que la cuantización y el paralelismo multinodo son condiciones previas para que el despliegue de escritorio sea viable, y ninguna de las dos explica el resultado por sí sola. Además, los dos Mac de 512 GB de memoria cada uno no se combinan en una máquina de direccionamiento unificado de aproximadamente 1 TB; la comunicación entre máquinas requiere RDMA y comunicación colectiva de MLX, por lo que el beneficio de escalado queda limitado por la comunicación. Para los equipos que ya usan GLM 5.3 max o Kimi K3 max en código y tareas de largo horizonte, esta comparación ofrece un candidato de reemplazo o complemento, pero el reporte también advierte que Muse Spark Open no lidera en Terminal-Bench 2.1 y DeepSWE 1.1, y que las demostraciones oficiales (desarrollo iOS de Ice Cubes, selección fotograma a fotograma en DaVinci Resolve) son exhibiciones del fabricante y no pueden extrapolarse a que tareas similares puedan operar sin supervisión.
Integración y evaluación
Lo siguiente son recomendaciones y análisis de condiciones basados en el reporte, no hechos verificados. Primero, si tu carga de trabajo consiste en llamadas a herramientas de largo horizonte y necesitas que los datos no salgan de tu máquina, puedes evaluar primero la tasa de finalización de tareas de Muse Spark Open mediante una API gestionada y luego decidir si lo autoalojas; el reporte menciona socios del ecosistema como Baseten, Fireworks AI, Groq, Modal, Nebius, Together AI y OpenRouter, y herramientas de despliegue como SGLang, vLLM, TensorRT-LLM, llama.cpp y MLX. La condición para decidir el autoalojamiento es si ya tienes aceleradores compatibles con NVFP4 o dos Mac de gran memoria; las métricas evaluables son la tasa de éxito de extremo a extremo y la diferencia de latencia por tarea entre la API gestionada y la inferencia local en un mismo conjunto de tareas reales de llamadas a herramientas. Segundo, al elegir entre NVFP4 y BF16, las premisas del reporte son NVFP4 de aproximadamente 537 GB y BF16 de aproximadamente 1,65 TB; si tu memoria de GPU o memoria unificada es insuficiente debes usar NVFP4, a costa de verificar la estabilidad de contextos largos tras la cuantización; las métricas evaluables son la caída en precisión de recuperación de información y en tasa de éxito de llamadas a herramientas cerca de 1,05 millones de tokens respecto a BF16. Tercero, si ofreces modelos como servicio a terceros y tus ingresos anuales agregados podrían superar el umbral de 20 millones de dólares descrito, antes de poner el modelo o modelos derivados en producción debes confirmar la aplicabilidad de la notificación y el acuerdo escrito por separado, y verificar si las excepciones de uso interno, investigación y productos propios que no sean modelo como servicio cubren tu caso; esto es una cuestión de términos de licencia que requiere criterio legal, no de ingeniería. Cuarto, si planeas escalar con varios Mac, no estimes la capacidad disponible por la suma de memoria de las máquinas; el reporte señala que la comunicación entre máquinas es un cuello de botella independiente; la métrica evaluable es si el incremento de velocidad de generación por token en configuraciones de dos y cuatro máquinas escala linealmente con el número de máquinas.
Límites y cuestiones pendientes
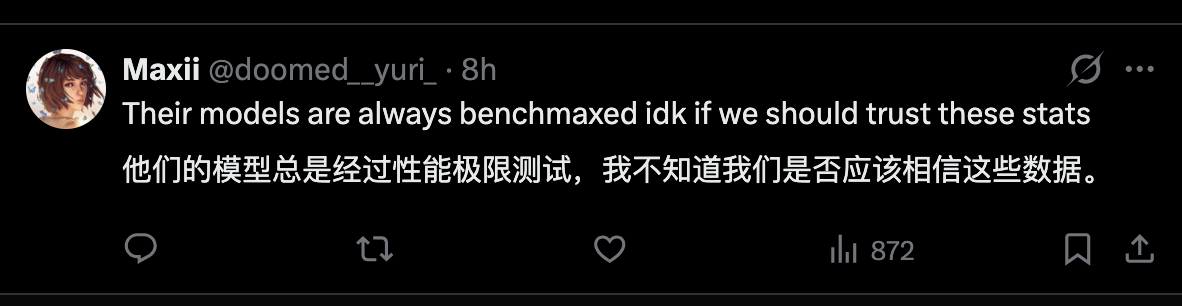
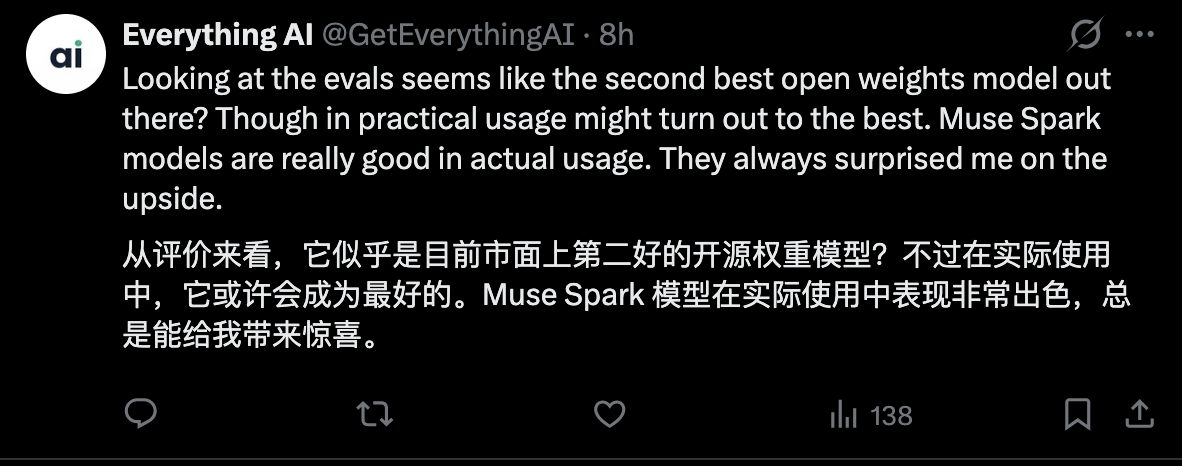
Conviene ser claro: Muse Spark Open y su versión 816B-A42B no aparecen actualmente en el catálogo de modelos en vivo de este sitio, y este sitio no tiene una entrada para ese modelo, por lo que la disponibilidad gestionada y de API mencionada se refiere al fabricante y a los socios de servicios de terceros que enumera, y no representa que este sitio pueda invocarlo. Todas las puntuaciones de evaluación, tamaños de pesos, configuraciones de hardware y términos de licencia del reporte provienen de la versión oficial de Meta y de la transcripción de InfoQ; este artículo no las reproduce de forma independiente ni ha realizado pruebas reales; existen reservas en la comunidad sobre la credibilidad de los resultados de las clasificaciones, y el reporte ya las cita. Pesos abiertos no equivale a ausencia de condiciones comerciales; las cláusulas de atribución y umbral de ingresos de Muse Model License deben confirmarse artículo por artículo según el texto original; el reporte aclara que existen excepciones para uso interno e investigación, y no debe simplificarse a "todas las empresas de ingresos altos deben pagar". Las afirmaciones del reporte sobre una aceleración a nivel de operador de 1,03 a 3,95 veces y una aceleración de extremo a extremo de aproximadamente 3% en AMD MI350 corresponden a dos métricas distintas, a nivel de operador y de extremo a extremo, y no pueden extrapolarse a una mejora general de la velocidad de inferencia. Las demostraciones oficiales y las citas de personas son declaraciones de terceros y no pueden considerarse evidencia de capacidad sin supervisión. Además, que el modelo admita entrada de vídeo y audio solo indica capacidad de comprensión, no capacidad de generación nativa; el despliegue local reduce la necesidad de sacar datos, pero no obtiene automáticamente las comprobaciones de seguridad y el control de acceso del lado de un servicio gestionado; si un agente obtiene permisos excesivos sobre archivos y comandos, aún puede causar modificaciones erróneas o pérdida de datos.
Ilustraciones de la noticia original