Nemotron 3.5 Super VL llega a SageMaker JumpStart: el modelo afirma un contexto de un millón, pero el endpoint solo llega a 15.600
Un blog de AWS del 9 de noviembre anunció que Nemotron 3.5 Super VL de NVIDIA está disponible en SageMaker JumpStart con dos variantes, NVFP4 y BF16. Tiene 120B de parámetros totales y 12B activos, y los pesos se ofrecen bajo la licencia OpenMDW 1.1; sin embargo, la configuración de servicio del endpoint gestionado limita el contexto a entre 520 y 15.600 tokens.
Qué ha cambiado
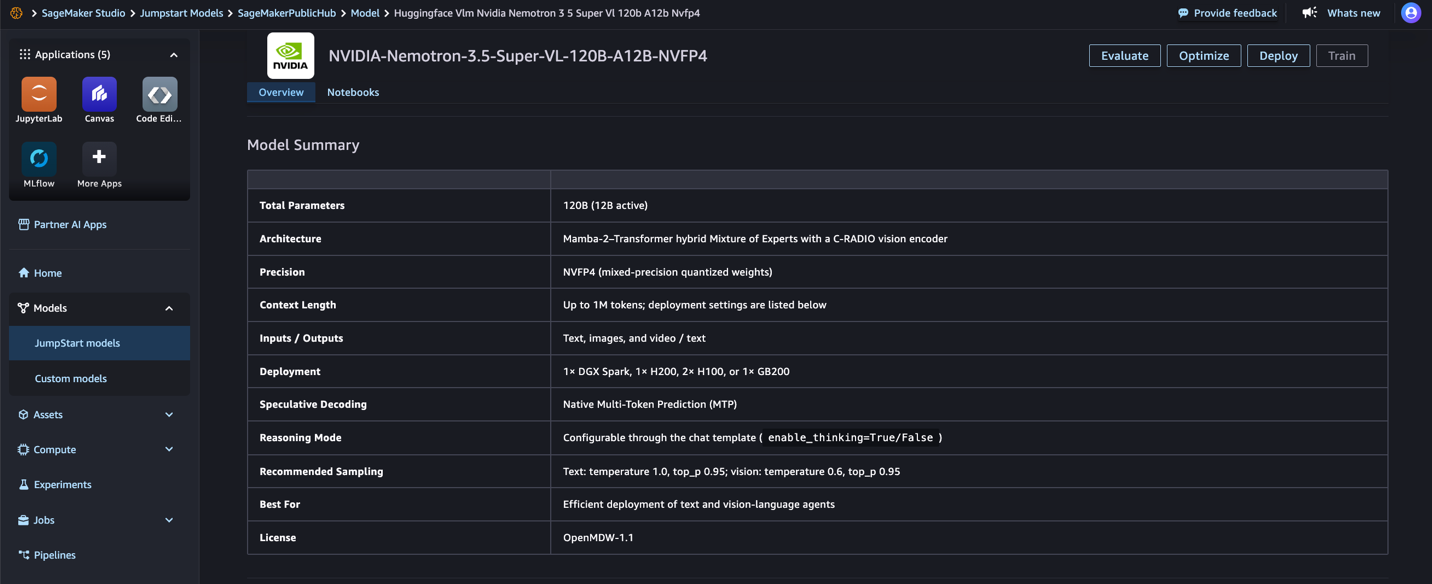
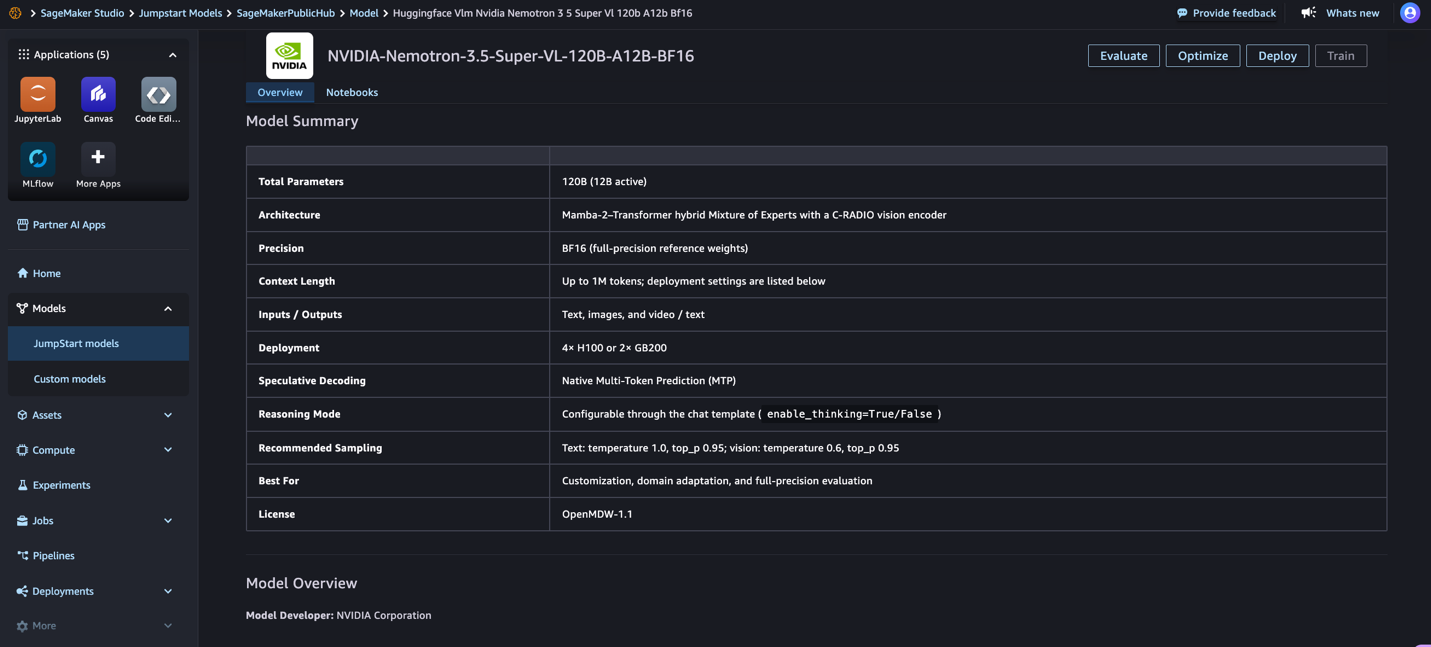
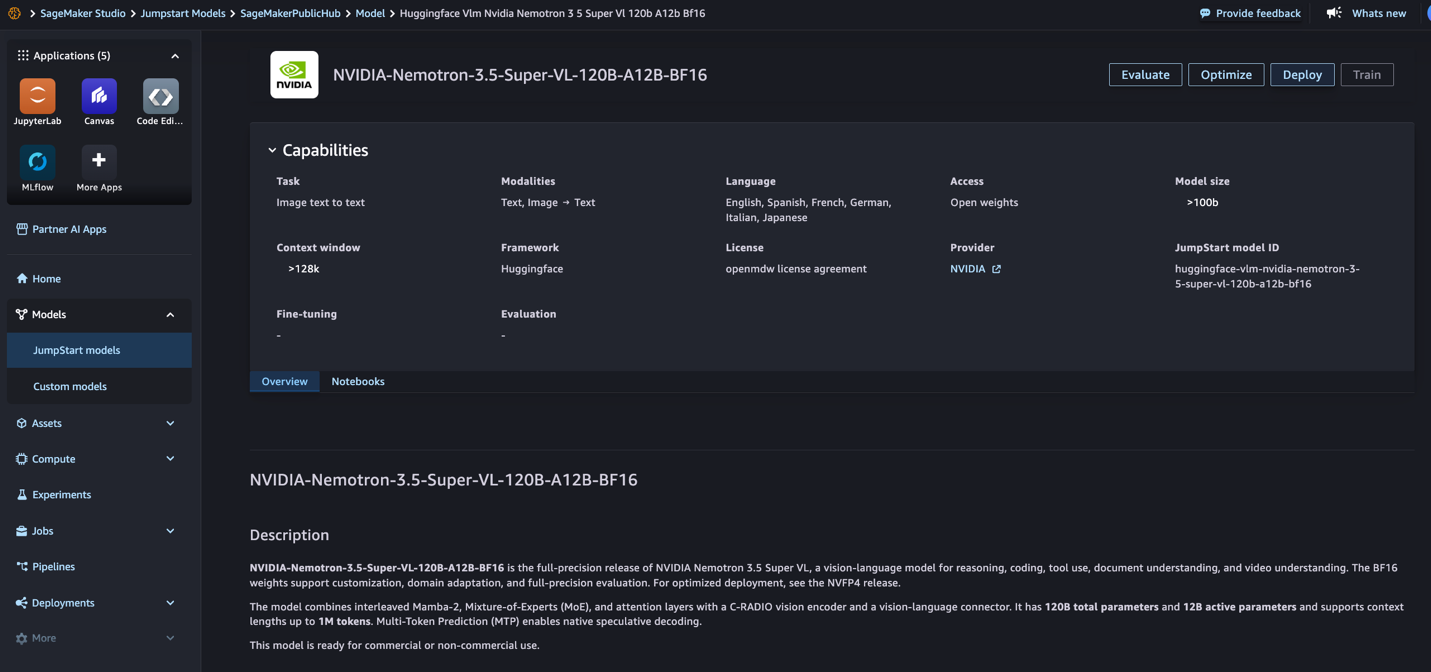
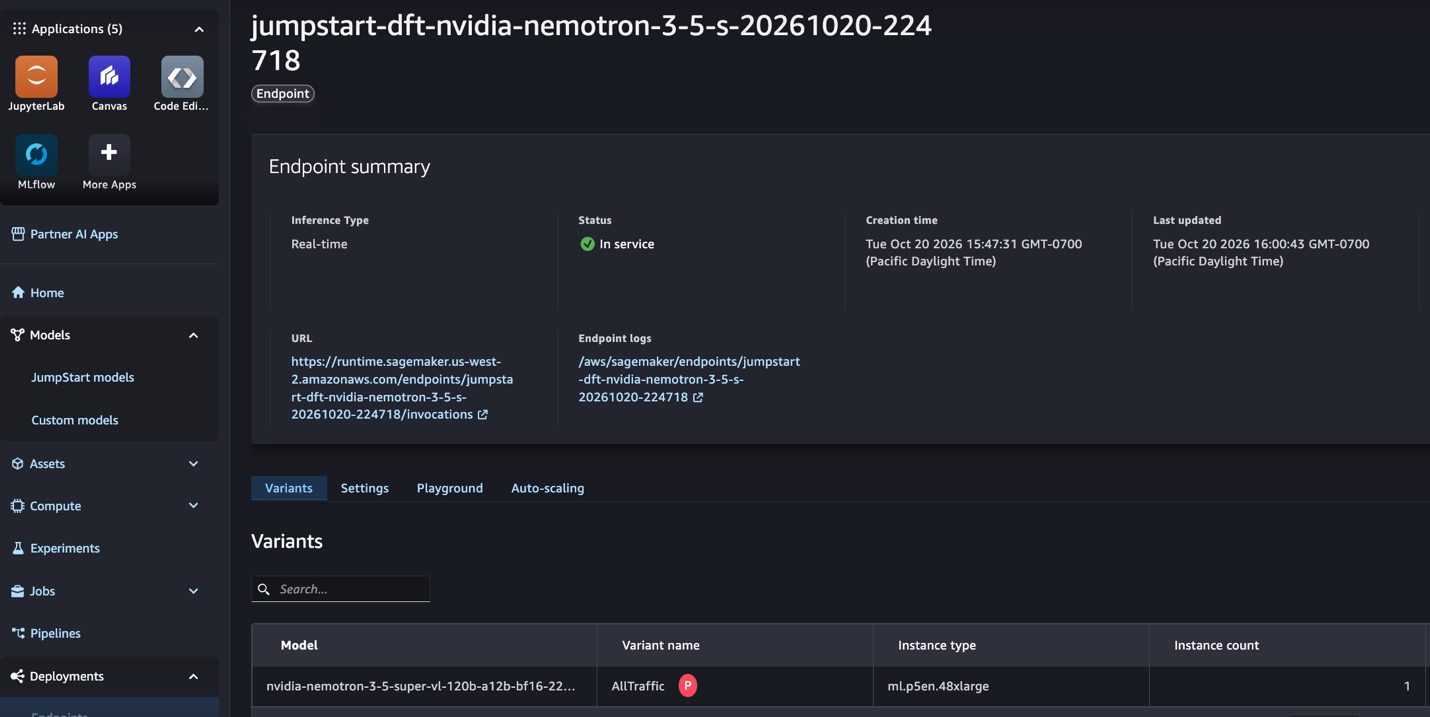
Según un blog de AWS publicado el 9 de noviembre de 2026 (autores Venu Kanamatareddy, Evan Kravitz y Naidile Murali), Nemotron 3.5 Super VL de NVIDIA ya está disponible en Amazon SageMaker JumpStart. Según el blog, el modelo es un modelo de lenguaje visual de la serie Nemotron 3.5 que acepta entradas de imagen, vídeo y texto y produce texto; el backbone lingüístico tiene 120B de parámetros totales y 12B activos por token: 88 capas que alternan Mamba-2 y MoE (512 expertos enrutados, con 22 activos por token), intercaladas con 8 capas de atención; el backbone se inicializa desde Nemotron 3 Super Base y se destila desde Nemotron 3 Ultra Base, y el lado visual usa un codificador C-RADIO. JumpStart ofrece dos variantes: NVFP4, obtenida de BF16 mediante destilación con reconocimiento de cuantización, de unos 75 GB, que se ejecuta en instancias G7 con RTX PRO 4500 Blackwell con pesos y activaciones de 4 bits; y BF16, los pesos de referencia en precisión completa, de unos 249 GB, que se ejecuta en 8 GPU H200 de ml.p5en.48xlarge. Los pesos se ofrecen bajo la licencia OpenMDW 1.1 y admiten inglés, francés, alemán, italiano, japonés, español y chino. El blog afirma que el modelo admite hasta un millón de tokens de contexto, pero la configuración de servicio de JumpStart solo llega a entre 520 y 15.600 tokens; el checkpoint incluye cabezas de predicción multi-token, la configuración de servicio de JumpStart no habilita decodificación especulativa y el endpoint tampoco carga adaptadores LoRA.
Impacto para desarrolladores
El primer efecto para los desarrolladores está en la forma de la interfaz. Según el blog, el endpoint de JumpStart expone una interfaz de chat completions impulsada por vLLM, el razonamiento está activado por defecto y el contenido de pensamiento se devuelve por separado del content, en el campo reasoning del mensaje; esto significa que los clientes actuales que solo analizan un único campo content tendrán que adaptarse, o perderán el cuerpo del texto o tomarán el proceso de razonamiento como cuerpo. Los medios deben enviarse en línea como data URL en base64, porque el endpoint está aislado de la red y no puede recuperar URL; esto eleva notablemente el tamaño del cuerpo de la solicitud y deja directamente inválidas prácticas como «pasar un enlace para que el modelo lo descargue».\n\nEl segundo efecto está en la planificación de capacidad. La tarjeta del modelo indica un contexto máximo de un millón de tokens, pero la configuración de servicio del endpoint gestionado solo ofrece en la práctica entre 520 y 15.600 tokens, y cada solicitud acepta solo una imagen y un vídeo. Una imagen de página de 1.536×1.024 consume unos 1.536 tokens, y el blog también dice explícitamente que el modelo recibe imágenes y no PDF sin procesar, por lo que primero hay que renderizar cada página como imagen. De ahí se deduce que un PDF de decenas de páginas no puede enviarse de una vez por esta vía gestionada: solo cabe hacer solicitudes página por página o combinar varias páginas en una imagen y ajustar el presupuesto de contexto.\n\nEl tercer efecto está en las expectativas de latencia. La medición que da el blog es que, en la configuración generate (250 tokens de entrada, 1.500 de salida, 5 flujos concurrentes en streaming), NVFP4 en G7 produce unos 63 tokens/segundo por solicitud y unos 0,45 segundos hasta el primer token; pero el mismo g7.24xlarge, en la configuración summarize con 10.000 tokens de entrada, pasa a 12,62 segundos hasta el primer token. Las solicitudes de imagen y vídeo suelen caer del lado de los prompts largos; antes de plantearse usarlo como agente GUI interactivo, conviene medir ese orden de magnitud del primer token.\n\nEn cuanto a calidad, el blog cita cinco benchmarks multimodales de la tarjeta de modelo de NVIDIA (con razonamiento activado): MMLongBench-Doc 62,82 frente a 62,82; OCRBench v2 inglés 68,12 frente a 68,34; CharXiv reasoning 80,82 frente a 79,88; Video-MME v2 32,85 frente a 32,54; OSWorld-Verified 51,14 frente a 52,30; el primer valor es BF16 y el segundo NVFP4. El blog afirma que la configuración de evaluación se mantuvo constante y que solo cambiaba el checkpoint. Son cifras declaradas por el fabricante y no se ha visto una reproducción por terceros.
Integración y evaluación
Las tres recomendaciones siguientes son condicionales y se basan en los hechos reportados, no son conclusiones verificadas.\n\nPrimero, decidir la variante. El cambio reportado es que JumpStart ofrece a la vez dos checkpoints, NVFP4 y BF16; NVFP4 es el predeterminado y arranca en ml.g7.24xlarge, y BF16 solo en ml.p5en.48xlarge. La elección es: para servicio de pura inferencia, empezar con NVFP4; solo si se va a hacer SFT, aprendizaje por refuerzo, destilación, adaptación de dominio o cuantización personalizada, descargar los pesos de referencia BF16 y montar el propio despliegue. La premisa clave que cambiaría esta elección es la necesidad de ajuste fino: el blog dice claramente que el endpoint solo ofrece pesos base y no carga adaptadores LoRA; si tu solución depende de cambiar LoRA en caliente, la vía gestionada directamente no sirve. El criterio medible es ejecutar ambos checkpoints sobre el mismo lote de capturas de documentos y clips de vídeo propios, comparar la diferencia en exactitud de tarea y en tasa de cumplimiento de salida JSON, y fijar la diferencia aceptable en no más del nivel de error correspondiente a tu tasa actual de revisión humana.\n\nSegundo, decidir la configuración de servicio antes de hablar de contexto. El cambio reportado es que inference_config_name determina la longitud del modelo: generate 2.275, interact 520, summarize 13.650, modify 15.600 tokens, y los ejemplos de imagen, vídeo y razonamiento del blog usan modify de forma uniforme. En la elección: usar modify para solicitudes con imagen, vídeo o razonamiento de varios pasos, generate para extracción de texto corto, y estimar cuántas páginas caben por solicitud a razón de «una página ≈ 1.536 tokens». La premisa es que los documentos de varias páginas deben dividirse en varias solicitudes o combinarse en una imagen. El criterio medible es registrar antes de salir a producción la tasa de rechazo por longitud excedida y el p95 del tiempo hasta el primer token, y tomar el valor de referencia de 12,62 segundos con 10.000 tokens de entrada como cota inferior de comparación del presupuesto de latencia.\n\nTercero, decidir el interruptor de razonamiento. El cambio reportado es que el razonamiento está activado por defecto, el contenido de pensamiento se devuelve por separado y, para solicitudes de vídeo con razonamiento, se recomienda fijar max_tokens en al menos 8.192. En la elección: para tareas que requieren respuestas cortas y directas, como extracción de campos de tickets o descripción de imágenes, desactivarlo con enable_thinking=False; mantenerlo para análisis de varios pasos y localización GUI. La premisa que cambia la elección es si la tarea realmente necesita pasos intermedios. El criterio medible es comparar, sobre el mismo lote de muestras, la exactitud de extracción de campos, el número de tokens de salida y la latencia de extremo a extremo con el razonamiento activado y desactivado, y ver si los tokens ahorrados compensan una pérdida de precisión aceptable. Antes de desplegar también hay que confirmar la cuota de ml.g7 (cero inicial en cuentas nuevas) y que el SDK de Python de SageMaker sea al menos 3.25, y pasar explícitamente el tipo de instancia; de lo contrario, el SDK recurre a ml.m5.large y la construcción falla.
Límites y cuestiones pendientes
Esta versión de Nemotron 3.5 Super VL no está actualmente en el catálogo de modelos de KimiSeek; la disponibilidad mencionada se refiere a AWS SageMaker JumpStart, es decir, un servicio gestionado del lado del fabricante, no a un modelo ya publicado en este sitio.\n\nLas demás incógnitas también deben mantenerse: los cinco benchmarks citados proceden de la tarjeta de modelo de NVIDIA y son cifras declaradas por el fabricante; el propio blog indica que las cifras de rendimiento de NVFP4 y BF16 se ejecutaron en sistemas y configuraciones de GPU distintos, no son una comparación de precisión aislada, por lo que no puede inferirse directamente una pérdida por cuantización comparando 63 tokens/segundo con 140,85 tokens/segundo. El contexto de un millón de tokens que declara la tarjeta de modelo no se expone en el endpoint gestionado, y el límite real depende de la configuración de servicio; el muestreo de fotogramas de vídeo se fija al iniciar el endpoint, y el endpoint también rechaza pasar media_io_kwargs por solicitud, así que controlar el muestreo por solicitud exige un despliegue propio. Los pesos se ofrecen bajo la licencia OpenMDW 1.1: pesos abiertos no equivalen a licencia de código abierto, y las condiciones de uso comercial, redistribución y modelos derivados deben leerse en el texto original de la licencia. La fuente no da precios; el coste depende de la instancia elegida y se rige por la página de precios de AWS SageMaker; aunque el chino figura entre los idiomas admitidos, la fuente no ofrece datos de benchmark para escenarios en chino.
Ilustraciones de la noticia original