NVIDIA lanza Nemotron 3.5 Bolt E4B: un agente local pensado para 4 GB de VRAM queda por detrás de Qwen3.5-4B en benchmarks de uso de herramientas
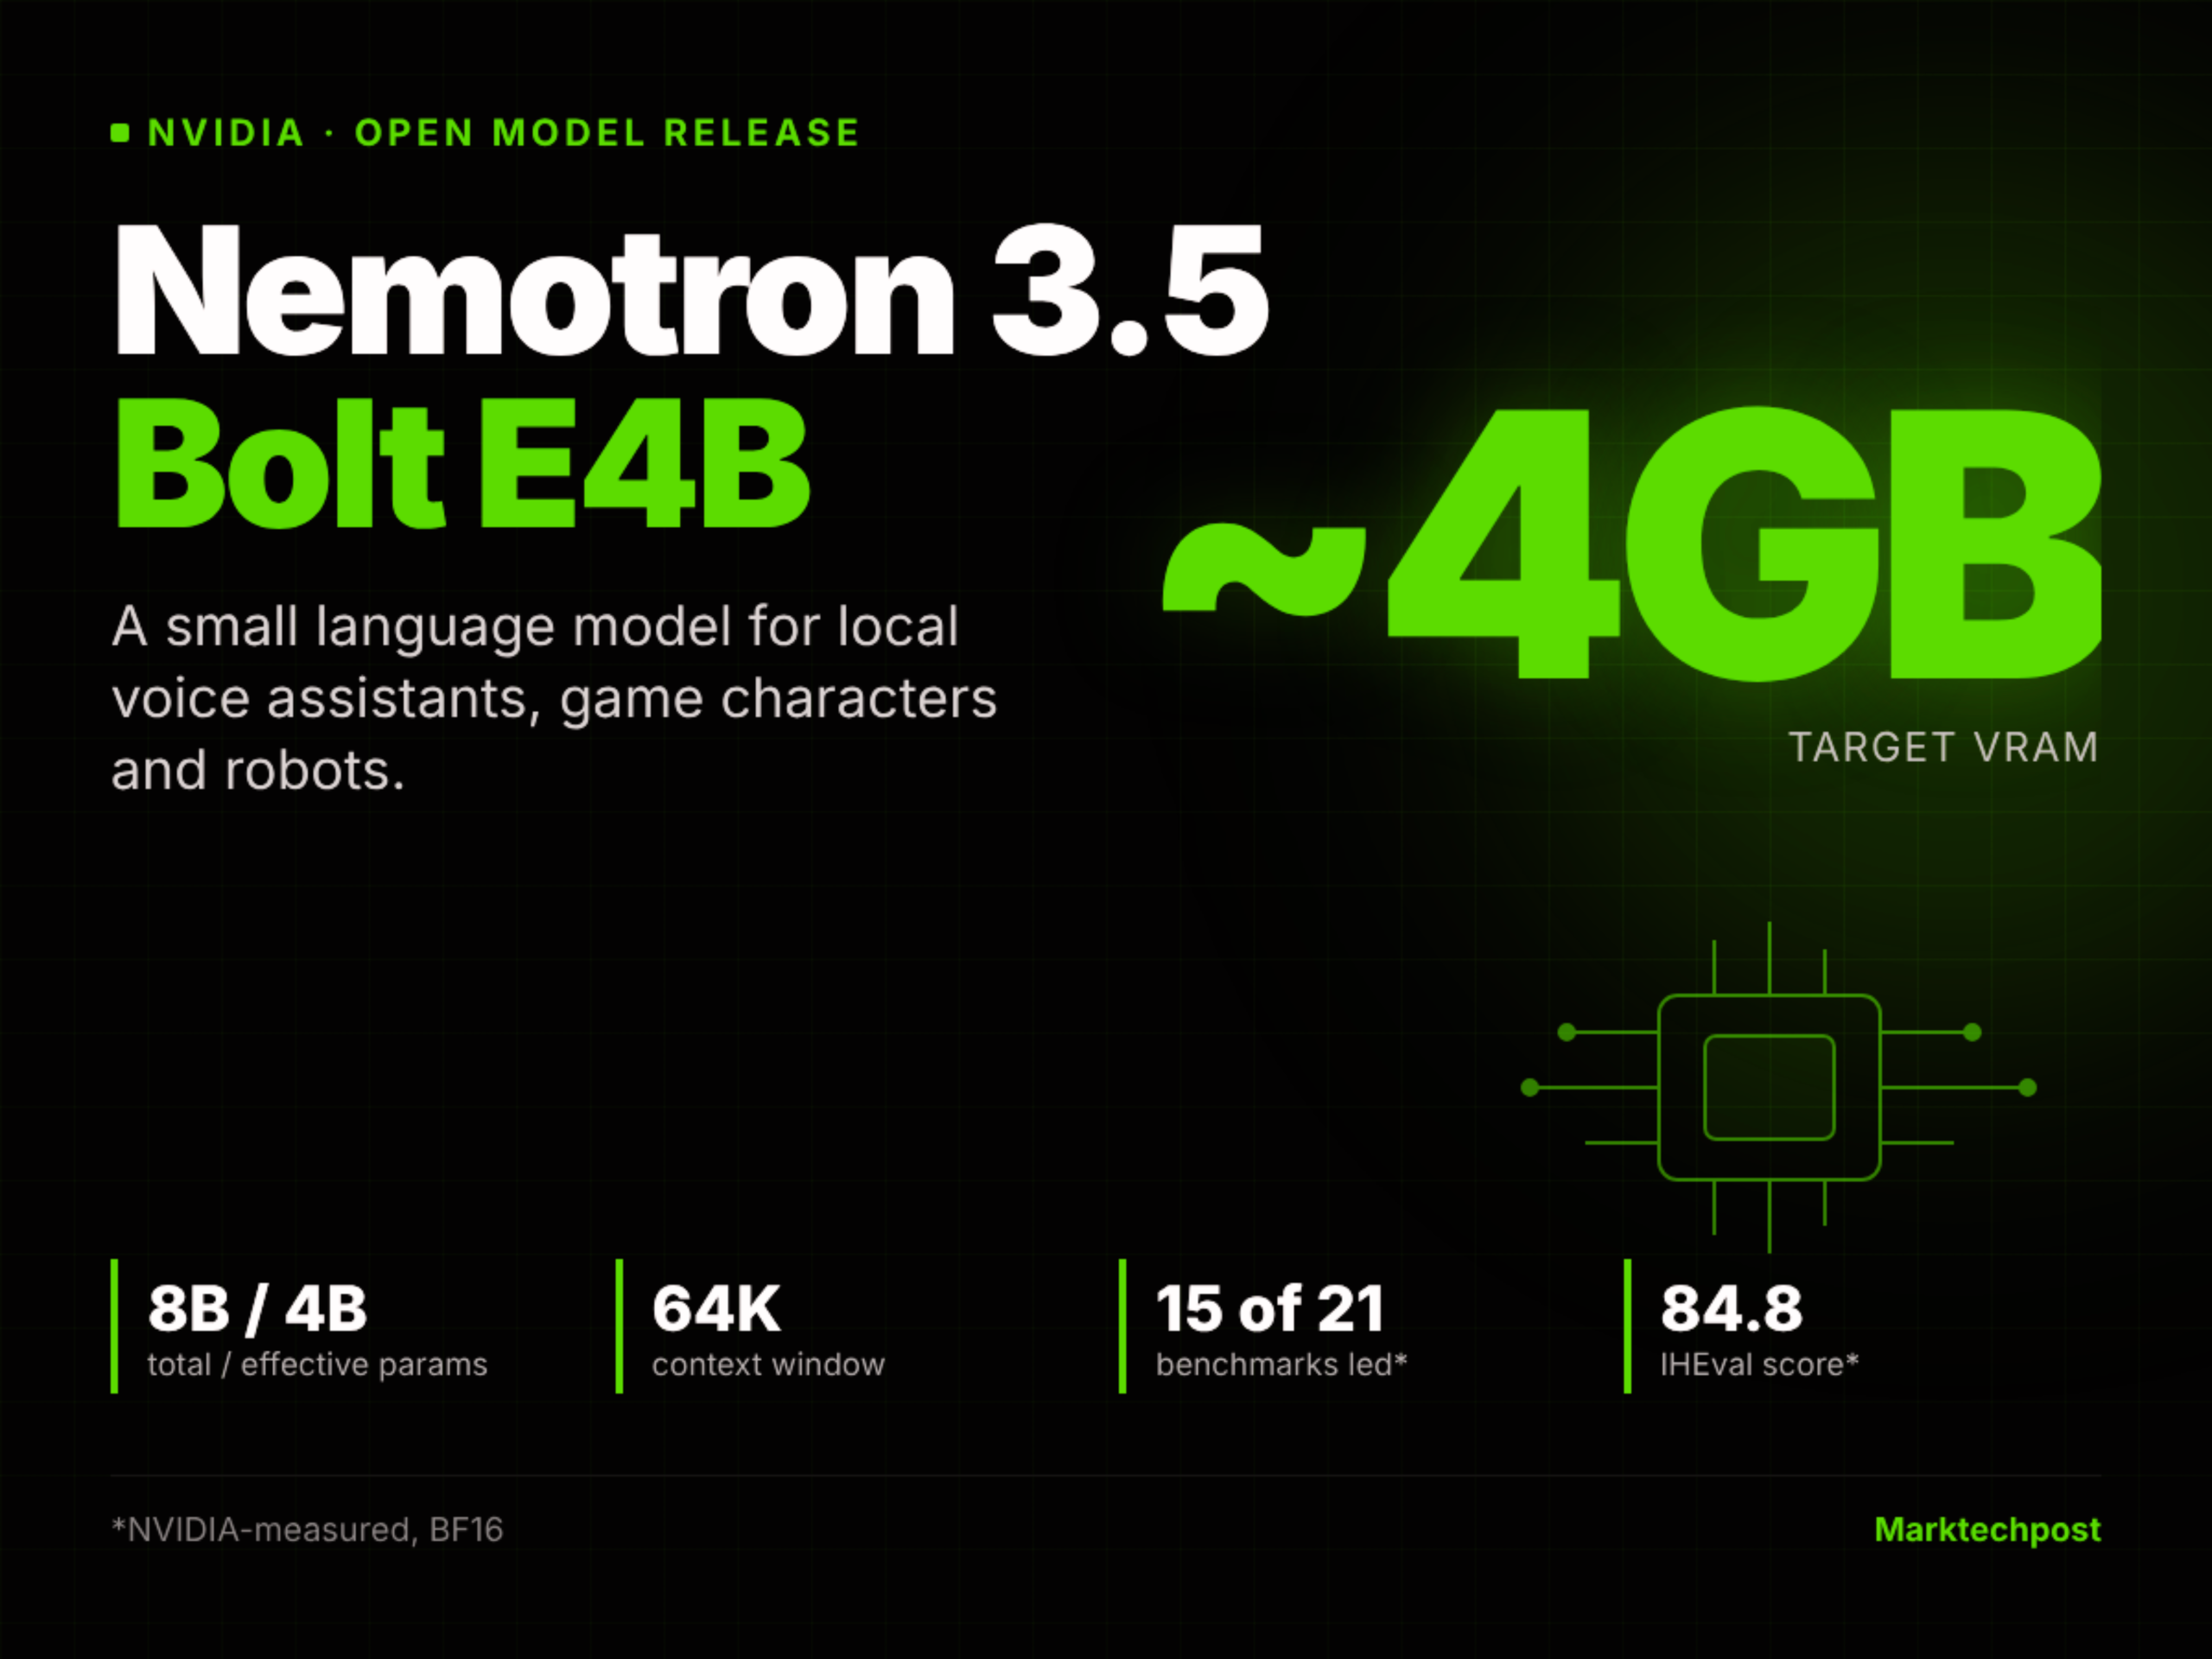
Según MarkTechPost, el 23 de octubre de 2026 NVIDIA lanzó el modelo de pesos abiertos Nemotron 3.5 Bolt E4B, entrenado solo con aprendizaje por refuerzo a partir de Gemma 4 E4B, con 8.000 millones de parámetros totales, 4.000 millones efectivos y 64K de contexto, orientado a asistentes de voz locales, NPC de videojuegos y robótica. En las 21 pruebas internas del fabricante lidera 15, pero en Tau2-Bench obtiene 55,1 frente a 75,1 de Qwen3.5-4B.
Qué ha cambiado
Una nota de MarkTechPost del 23 de octubre de 2026 afirma que NVIDIA lanzó Nemotron 3.5 Bolt E4B, partiendo de Gemma 4 E4B de Google, omitiendo por completo el ajuste supervisado y usando solo RLVR y RLHF mediante NeMo-RL y NeMo-Gym; cada muestra de entrenamiento ejecuta a la vez el modo de razonamiento y el de no razonamiento, con una proporción de 2:1 entre muestras sin razonamiento y con razonamiento en cada lote, y la penalización de longitud del entorno GenRM frena el alargamiento de las respuestas; el conjunto de datos y la receta son públicos. El modelo tiene 8.000 millones de parámetros totales, 4.000 millones efectivos y 64K de contexto, admite llamadas a herramientas multi-turno e instrucciones de llamadas asíncronas, incluye un indicador conversational_mode que genera respuestas cortas aptas para voz, y permite configurar la capacidad de razonamiento y el presupuesto de pensamiento en tiempo de ejecución. La nota lo presenta como la tercera generación de modelos pequeños para personajes de juego de NVIDIA ACE y muestra un robot Reachy Mini ejecutándose en una Jetson Orin Nano de 8 GB, donde Cosmos 3 Edge se encarga de la visión y Bolt de las respuestas de voz y las llamadas a herramientas. En el despliegue, NVIDIA cuantiza el checkpoint BF16 a Q4_K_M mediante calibración con matriz de importancia, usando unos 1 millón de tokens de rollouts de RL, y lo acompaña de un borrador DFlash para decodificación especulativa: la nota afirma que Bolt alcanza 272,6 tokens/s en una RTX 5070, frente a 225,9 tokens/s de Gemma 4 E4B con su borrador MTP. Las mediciones de hardware (Q4_K_M, llama.cpp, tamaño de lote 1, 3K de entrada y 50 tokens de salida) muestran que la RTX 5070 ocupa 3,5 GB de VRAM, con 548 ms hasta el primer token y 133,4 tokens/s; la Jetson AGX Orin de 32 GB ocupa 4,2 GB, con 3687 ms y 24,0 tokens/s; la Jetson Orin Nano de 8 GB ocupa 4,2 GB, con 5785 ms y 15,5 tokens/s. La nota subraya que «4 GB» es el rango objetivo de VRAM y no el tamaño del archivo: el GGUF Q4_K_M en Hugging Face pesa 6,18 GB. El modelo publica sus pesos bajo licencia OpenMDW-1.1, con datos y receta públicos, y ya está disponible en Hugging Face, Ollama, LM Studio, Unsloth y Jetson AI Lab, además de ofrecerse como NVIDIA NIM y mediante el SDK In-Game Inferencing, con una API gratuita adicional en la plataforma alojada oficial de NVIDIA. En cuanto a los benchmarks, todas las puntuaciones de la nota son en BF16 y fueron medidas por NVIDIA en su propio marco NeMo-Gym: lidera 15 de 21 pruebas, con 84,8 en IHEval (Gemma 4 E4B 67,0; Qwen3.5-4B 60,6); en Tau2-Bench obtiene 55,1 frente a 75,1 de Qwen3.5-4B, en RULER 64K logra 87,0, también por debajo de 95,1 de Qwen3.5-4B, y LongBench v2 (50,5 frente a 59,9) y BFCL-v3 (68,5 frente a 70,9) también favorecen a Qwen3.5-4B, mientras que Gemma 4 E4B supera ligeramente a Bolt en EQ-Bench v3 con 41,1 frente a 39,4. La nota recoge además afirmaciones de NVIDIA: la puntuación media es un 40 % superior a la de Nemotron 3 Nano 4B y, en comparaciones con razonamiento activado, los tokens de salida se reducen hasta un 80 %.
Impacto para desarrolladores
El efecto directo para los desarrolladores se concentra en dos cuestiones: el presupuesto de VRAM y el reparto de tareas. Las cifras de VRAM de la nota corresponden solo a la inferencia del modelo, sin incluir reconocimiento de voz, síntesis de voz ni modelos de visión; si se configura siguiendo la demostración de la Jetson Orin Nano de 8 GB del informe, el modelo por sí solo ya ocupa 4,2 GB, y el margen restante determina qué tamaño de modelo de percepción cabe, si se puede subir la resolución de imagen y si hay que pasar a un dispositivo de 16 GB o más. La diferencia en el tiempo hasta el primer token también es clave: 548 ms en la RTX 5070 y 5785 ms en la Orin Nano son experiencias de interacción completamente distintas; la segunda se acerca más a un diálogo por turnos que a una conversación con interrupciones naturales. El reparto de capacidades indica que encaja mejor como componente especializado que como modelo pequeño de propósito general. De las 21 pruebas repartidas en 5 dominios de capacidad, NVIDIA solo afirma liderazgo en 15, y las derrotas se concentran en contexto largo y en la cadena de herramientas para agentes: Tau2-Bench, RULER 64K, LongBench v2 y BFCL-v3 pierden frente a Qwen3.5-4B. En cambio, las puntuaciones de seguimiento de instrucciones como el 84,8 de IHEval son su punto fuerte, y conversational_mode también sugiere que la intención de diseño favorece respuestas breves, rápidas y directamente locutables. En conjunto, es un candidato para «conversación más llamadas ligeras a herramientas», no la opción por defecto para planificación compleja multi-turno o recuperación sobre contextos muy largos. Hay que tener en cuenta las diferencias de metodología al decidir. Todas las puntuaciones anteriores las midió el fabricante en su propio marco de pruebas y pueden diferir de una reproducción por terceros; la nota menciona además que Scale Labs otorga un 56,03 % en MultiChallenge, por encima del 53,1 que NVIDIA se atribuye. La coexistencia de dos conjuntos de cifras en la misma nota indica que al elegir no conviene tomar ninguna puntuación aislada como concluyente, sobre todo cuando la distribución de tu negocio no coincide con la de los benchmarks.
Integración y evaluación
A continuación se ofrecen recomendaciones condicionales y análisis de condiciones basados en la nota; no son conclusiones verificadas. Decisión uno: elegir la versión cuantizada y la forma de despliegue según el margen de VRAM del dispositivo objetivo. Si el dispositivo es una Jetson de gama 8 GB o una GPU de 12 GB y hay que ejecutar a la vez modelos de voz y de visión, conviene validar primero la ruta Q4_K_M con llama.cpp: los 4,2 GB de ocupación y los 6,18 GB de tamaño de archivo que da la nota muestran que el archivo de pesos no cabe en el presupuesto de «4 GB» y que la forma viable es la ejecución cuantizada. El criterio medible es concreto: medir la latencia hasta el primer token y los tokens/s con tu propia longitud de entrada (la nota usa 3K de entrada y 50 tokens de salida) y confirmar que queda margen tras añadir el modelo de percepción; si el primer token supera el límite aceptable para el diseño de interacción, hay que pasar antes a una cuantización menor o más agresiva que seguir ajustando los prompts. Decisión dos: decidir si usar Bolt según si la carga de trabajo se centra en llamadas a herramientas. Si el producto es un asistente de voz con diálogos cortos y pocas llamadas a herramientas, vale la pena probar su conversational_mode y su contexto de 64K; si la cadena principal son trayectorias largas de herramientas multi-turno con estado, la diferencia de 55,1 frente a 75,1 en Tau2-Bench que recoge la nota sugiere establecer primero una línea base con Qwen3.5-4B. El criterio medible es reunir las trayectorias de llamadas multi-turno de tu propio negocio en un conjunto de evaluación fijo y comparar la tasa de finalización de tareas y el número medio de llamadas con las mismas definiciones de funciones, en lugar de fijarse solo en si la respuesta de un turno es fluida. Decisión tres: tratar el presupuesto de pensamiento en tiempo de ejecución como un parámetro que hay que calibrar, no como un interruptor. La nota afirma que el modelo admite razonamiento configurable y presupuesto de pensamiento en ejecución, y que en comparaciones con razonamiento activado los tokens de salida se reducen hasta un 80 % (afirmación del fabricante). Esto implica que los mismos pesos generan dos curvas distintas de latencia y calidad según el razonamiento esté activado o no. El procedimiento es fijar un presupuesto de latencia para la cadena de voz, elegir una de las dos opciones dentro de ese presupuesto y comprobar con el número de tokens de salida y el tiempo hasta el primer token si la afirmación de ahorro de tokens se cumple en la distribución de tus tareas. Decisión cuatro: la licencia requiere verificación aparte. La nota afirma que los pesos se publican bajo OpenMDW-1.1, mientras que el modelo base Gemma 4 E4B es Apache 2.0, y las condiciones no son las mismas; antes de incorporar los pesos a un producto conviene leer directamente el texto de la licencia para confirmar las condiciones de distribución, atribución y uso comercial, en lugar de deducir permisos a partir de etiquetas como «pesos abiertos».
Límites y cuestiones pendientes
El Nemotron 3.5 Bolt E4B descrito en este artículo no está disponible actualmente en KimiSeek y no hay ninguna entrada correspondiente en el catálogo de modelos del sitio; la API gratuita mencionada en la nota se refiere a la disponibilidad del modelo en la plataforma alojada oficial de NVIDIA y no guarda relación con este sitio, por lo que la disponibilidad real y las condiciones deben consultarse en la documentación del fabricante. Entre los límites conocidos figuran: todas las puntuaciones de benchmark de la nota son en BF16 y las midió NVIDIA en su propio marco NeMo-Gym, no son reproducciones independientes; que la puntuación media supere en un 40 % a Nemotron 3 Nano 4B y que los tokens de salida se reduzcan hasta un 80 % con el razonamiento activado son afirmaciones del fabricante. La comparación de velocidad también tiene diferencias de metodología: 272,6 frente a 225,9 tokens/s corresponde a Bolt con borrador DFlash y a Gemma 4 E4B con borrador MTP en una RTX 5070, y no es intercambiable con los 133,4 tokens/s de la tabla de hardware. En MultiChallenge, NVIDIA se atribuye 53,1 y una publicación en X recogida por la nota indica que Scale Labs da 56,03; ambas cifras deben citarse con su fuente respectiva. En cuanto a la licencia, Bolt se publica bajo OpenMDW-1.1 y el modelo base Gemma 4 E4B es Apache 2.0: los pesos abiertos no equivalen a condiciones comerciales idénticas. Los datos de hardware solo cubren cuatro configuraciones de RTX y Jetson; no hay datos de otras plataformas. Respecto a las modalidades de entrada, según la tabla comparativa de la nota, la tarjeta del modelo Bolt indica entrada de texto, mientras que la forma NIM acepta además imagen y audio; las modalidades realmente disponibles y sus limitaciones deben confirmarse en la documentación oficial, y la nota no ofrece datos de evaluación de esas modalidades.