Reflection AI presenta Beam, su modelo de pesos abiertos: 501B de parámetros totales, 23B activos y pesos Apache 2.0 aún pendientes
Según un reporte de MarkTechPost del 5 de octubre de 2026, Reflection AI presentó Beam, su primer modelo de pesos abiertos: 501B de parámetros totales, 23B activos por token, orientado a tareas de programación y agentes, con parámetro de intensidad de razonamiento y contexto efectivo de 1 millón de tokens; los pesos bajo Apache 2.0 se publicarían a finales de octubre de 2026 y el modelo sigue en pruebas de red team con acceso solo por lista de espera.
Qué ha cambiado
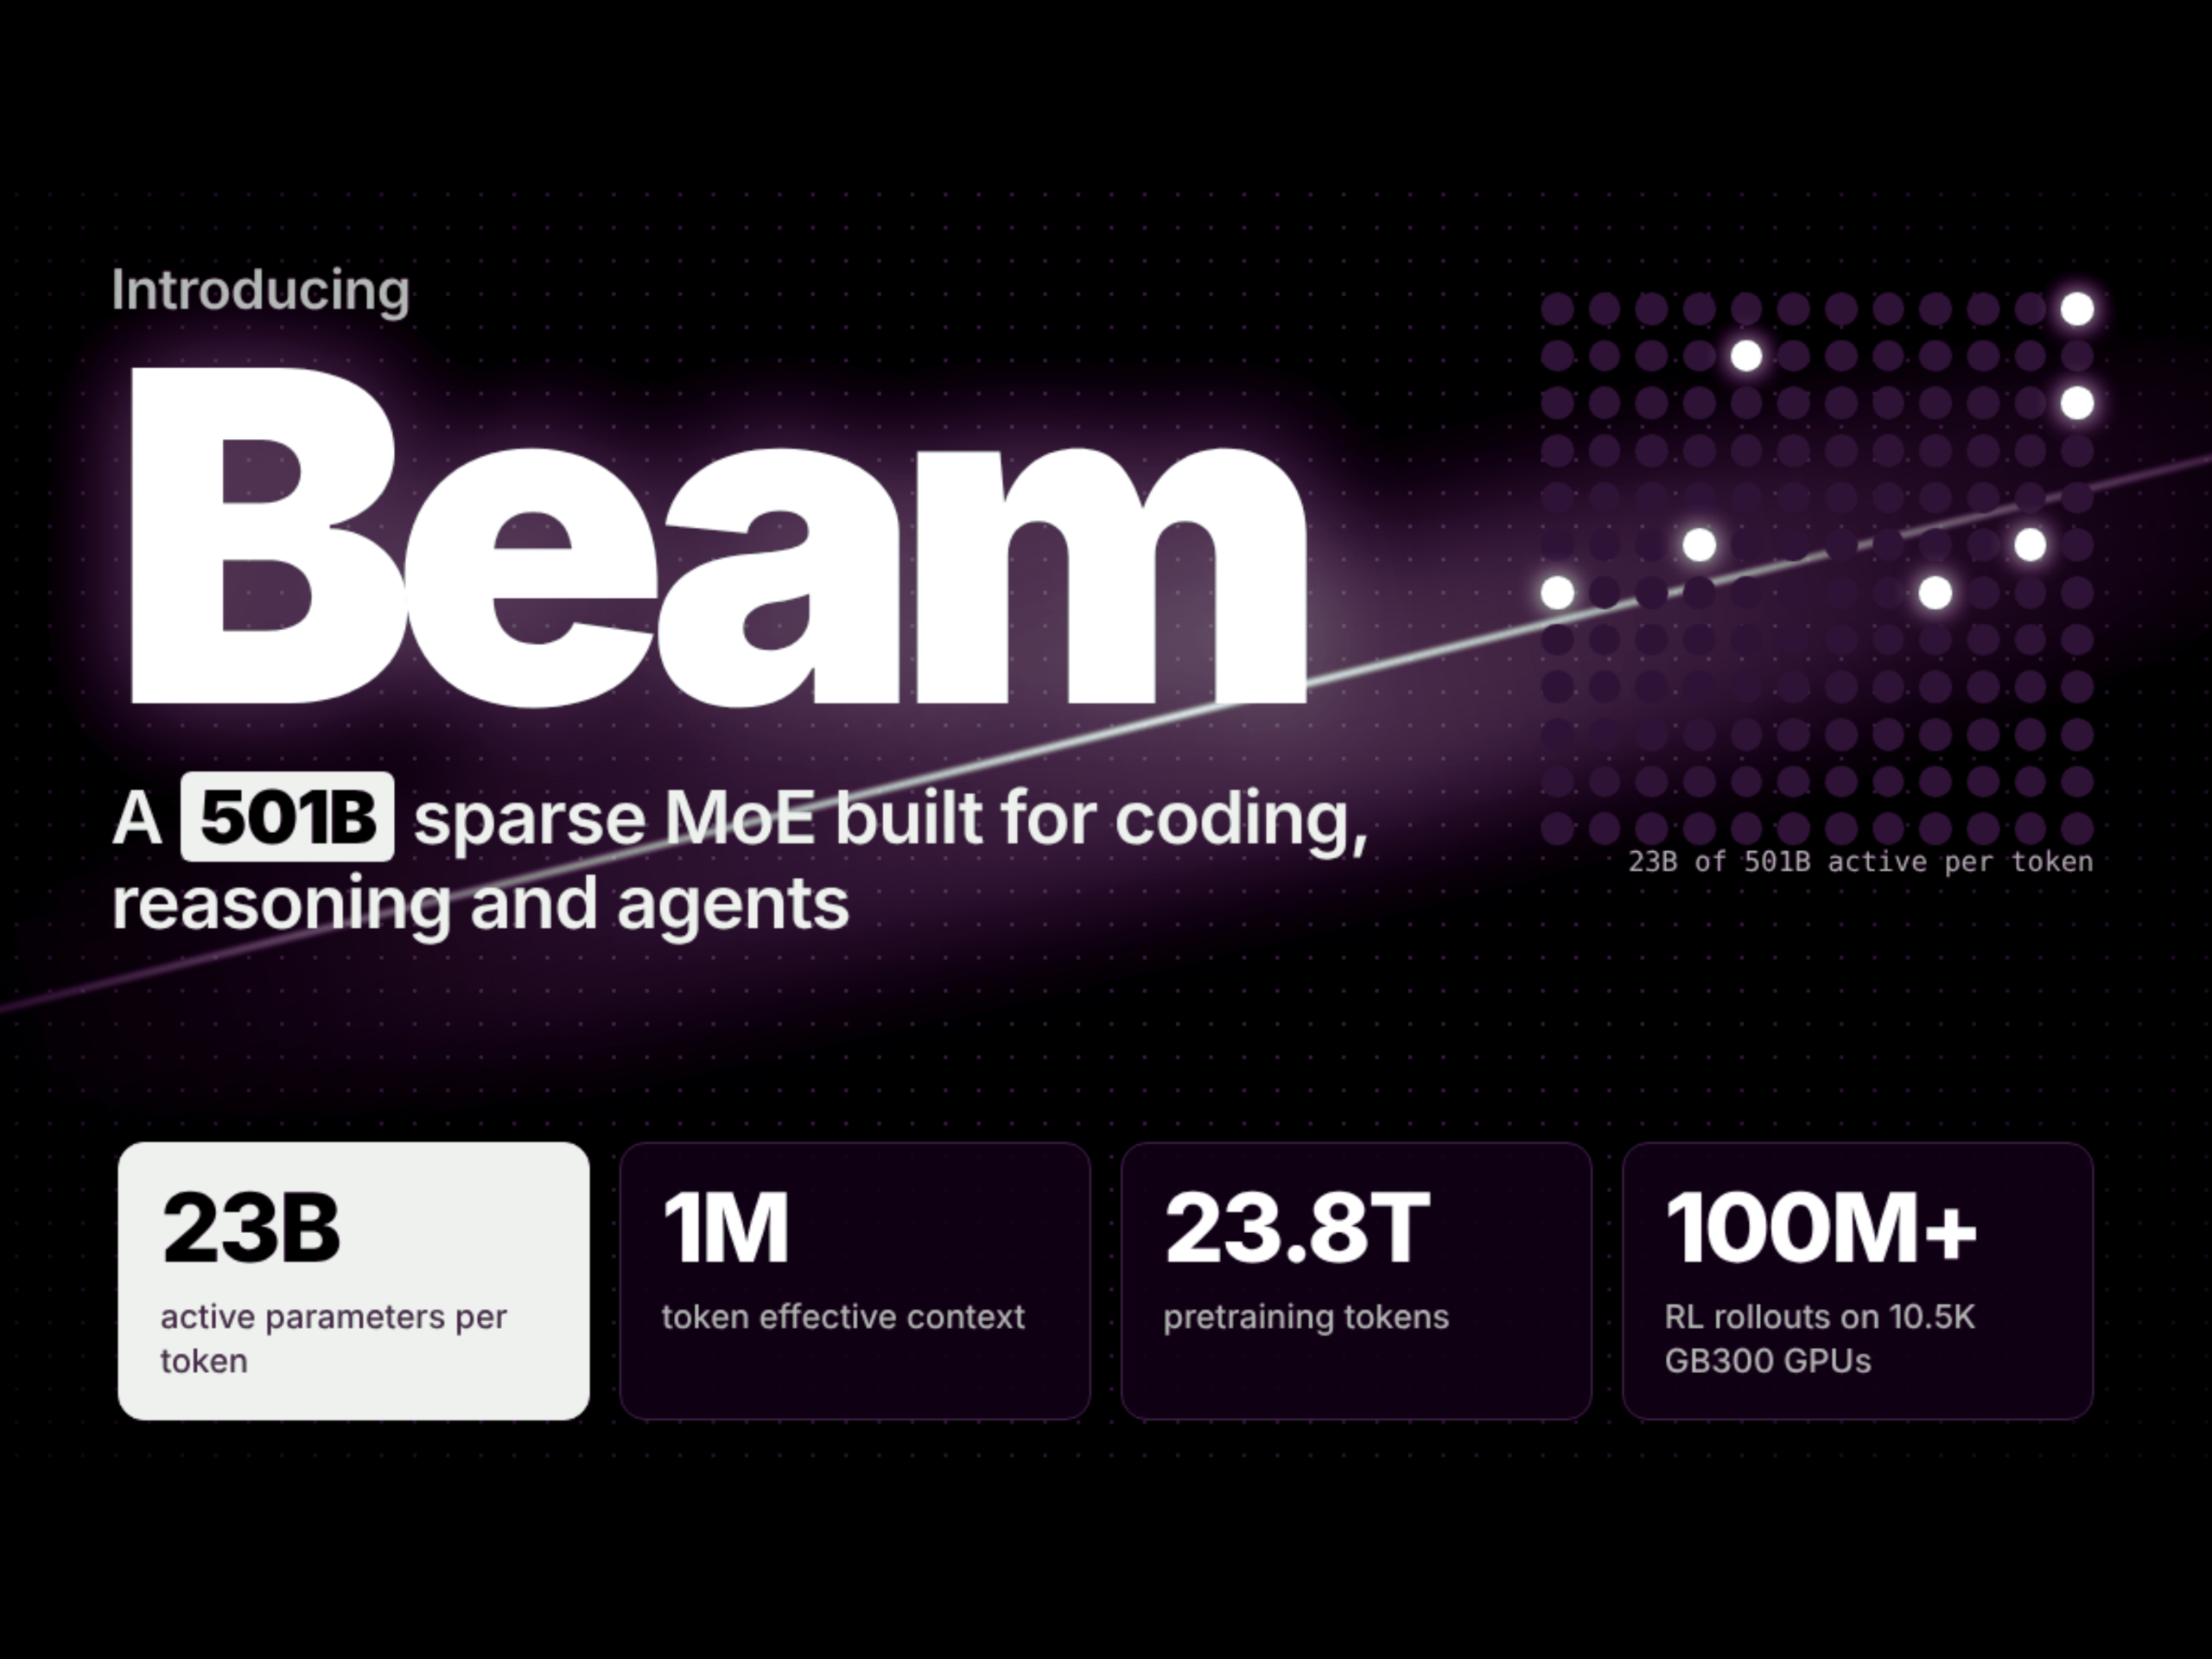
Según un reporte de MarkTechPost del 5 de octubre de 2026, Reflection AI anunció Beam, su primer modelo de pesos abiertos. Beam es un modelo de mezcla de expertos dispersa, con 501B de parámetros totales y 23B activos por token, orientado a cargas de trabajo de programación, razonamiento y agentes, solo entrada de texto y contexto efectivo de 1 millón de tokens. El equipo de Reflection afirma que Beam compite directamente con modelos abiertos más grandes como GLM 5.2, y que necesita entre 3 y 4 veces menos cómputo de inferencia en benchmarks de razonamiento, a la vez que reconoce que Kimi K3 sigue liderando en capacidad bruta. El modelo ofrece un parámetro de intensidad de razonamiento ajustable según la dificultad de la tarea y el presupuesto de cómputo. El preentrenamiento usó 23,8 billones de tokens y se completó en menos de 4 semanas en 6.144 GPU NVIDIA GB300 NVL72; la fase de aprendizaje por refuerzo usó 10,5K GPU GB300 durante 4 semanas, generó más de 100 millones de rollouts y un contexto máximo de rollout de 256K tokens. Los resultados publicados por Reflection son SWE-bench Verified 80,9 y Terminal Bench v2.1 80,1. Según la información, Beam sigue en pruebas finales de red team, el autohospedaje no está disponible por ahora, el acceso temprano se ofrece mediante lista de espera en la plataforma de Reflection y los pesos Apache 2.0 se publicarían a finales de octubre de 2026.
Impacto para desarrolladores
A juzgar por las especificaciones divulgadas, Beam no se posiciona solo como un intento de igualar al modelo abierto más potente, sino que reduce los parámetros activos por token a 23B y mantiene los totales en 501B, cambiando eficiencia por menor barrera de despliegue. Para los desarrolladores, esto afecta directamente la estructura de costos de inferencia: si la afirmación de ahorro de cómputo de 3 a 4 veces se sostiene, las mismas tareas de programación o agentes podrían alcanzar un rendimiento cercano con menos GPU, pero es una afirmación del equipo de Reflection, no una conclusión reproducida de forma independiente. El segundo nivel de impacto está en la licencia: el reporte indica que Beam planea usar Apache 2.0, mientras que Kimi K3, incluido en la tabla comparativa, usa una licencia personalizada con requisitos adicionales de atribución para productos de gran escala, GLM-5.2 y DeepSeek V4.1 Flash usan MIT y Nemotron 3 Ultra usa OpenMDW-1.1. Cabe subrayar que la próxima apertura de los pesos y la concreción de los términos de la licencia son dos cosas distintas: Apache 2.0 seguía siendo un plan en el momento del reporte y, hasta que los pesos se publiquen realmente con su licencia, no debe darse por vigente ningún derecho de uso. El tercer nivel de impacto es el límite de capacidades: Beam solo admite texto, a diferencia de DeepSeek V4.1 Flash y Kimi K3, que en la tabla admiten texto e imágenes, por lo que las cargas multimodales aún requieren otro modelo. En benchmarks, DeepSeek V4.1 Flash y Kimi K3 siguen liderando en Terminal Bench v2.1, lo que indica que la ventaja de eficiencia no equivale a una superación global de capacidades.
Integración y evaluación
Lo siguiente son recomendaciones y análisis de condiciones, no hechos reportados. Decisión uno: si incluir Beam en el grupo de candidatos para agentes de programación. El reporte indica SWE-bench Verified 80,9 y Terminal Bench v2.1 80,1, ambos autodeclarados por Reflection; la premisa es que los pesos y la licencia se publiquen realmente, pues de lo contrario hoy solo se puede evaluar mediante lista de espera. Criterio de evaluación ejecutable: en tareas de generación de parches sobre repositorios propios, comparar la tasa de éxito y el consumo de tokens por tarea frente al modelo actual; solo si la tasa de éxito es cercana y el consumo de tokens baja de forma significativa habría valor para cambiar. Decisión dos: cómo manejar el compromiso entre costo y calidad que introduce el parámetro de intensidad de razonamiento. El reporte indica que el nivel bajo tiende a respuestas breves y el alto permite razonamiento más largo, un punto de control explícito exclusivo de Beam; es útil en flujos con distribución de dificultad muy variable. Principio de elección: fijar primero las demás variables, ejecutar el mismo lote de problemas difíciles en los niveles bajo, medio y alto, registrar la precisión y los tokens totales de salida, encontrar el punto de inflexión de la curva de costo y decidir entonces qué nivel usar por defecto, en lugar de usar un único nivel global. Decisión tres: verificación previa de licencia y cumplimiento. Antes de la publicación de los pesos, debe establecerse como condición previa al lanzamiento si realmente se publican bajo Apache 2.0 y si el archivo de licencia acompaña a los pesos; si los términos publicados difieren de lo esperado en el reporte, la decisión de cambio debe rehacerse. Criterio de evaluación: que el archivo de licencia se entregue junto con los pesos y que sus términos coincidan con lo esperado.
Límites y cuestiones pendientes
En el momento del reporte, Beam seguía en pruebas finales de red team, el autohospedaje no estaba disponible y el acceso temprano solo se ofrecía por lista de espera en la plataforma de Reflection, por lo que actualmente no es posible probar los pesos localmente. Todas las puntuaciones de benchmarks provienen de la tabla publicada por Reflection; las de competidores se citan de Artificial Analysis y DataCurve y no cuentan con reproducción independiente de terceros, por lo que SWE-bench Verified 80,9 y Terminal Bench v2.1 80,1 deben considerarse datos autodeclarados por el fabricante. Apache 2.0 se describe como un plan y los pesos se publicarían a finales de octubre de 2026; en el momento de la verificación actual del catálogo, esta versión de Beam no figura en KimiSeek, y la disponibilidad de API y plataforma mencionada en el reporte se refiere a Reflection AI, sin relación con el catálogo de este sitio. El reporte indica que los resultados de evaluación de seguridad se publicarán en el informe técnico y aún no hay datos concretos. La afirmación de ahorro de cómputo de inferencia de 3 a 4 veces proviene del equipo de Reflection, y el reporte no detalla condiciones de prueba, elección de línea base ni método de medición. Sigue siendo incierto si la mejora de eficiencia puede reproducirse en entornos autohospedados.
Ilustraciones de la noticia original