Reflection Beam 发布开放权重 501B 模型:Apache 2.0 权重与 AWS 两条部署路径
Según un blog de AWS publicado el 16 de octubre de 2026, Reflection AI lanzó Beam, un modelo de pesos abiertos orientado a codificación con agentes y tareas de ciclo largo, con 501B de parámetros totales y 23B activos, una longitud de contexto efectiva reportada de 1 millón de tokens, pesos publicados bajo licencia Apache 2.0 a través de Hugging Face, puntos de control BF16/FP8/NVFP4 y dos rutas de despliegue: SageMaker JumpStart y HyperPod.
Qué ha cambiado
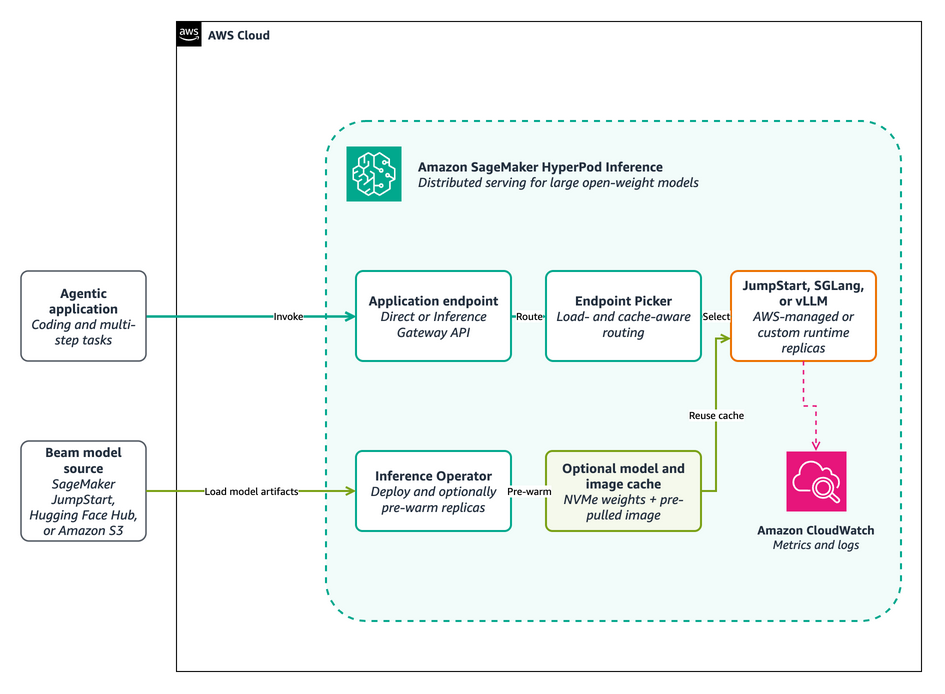
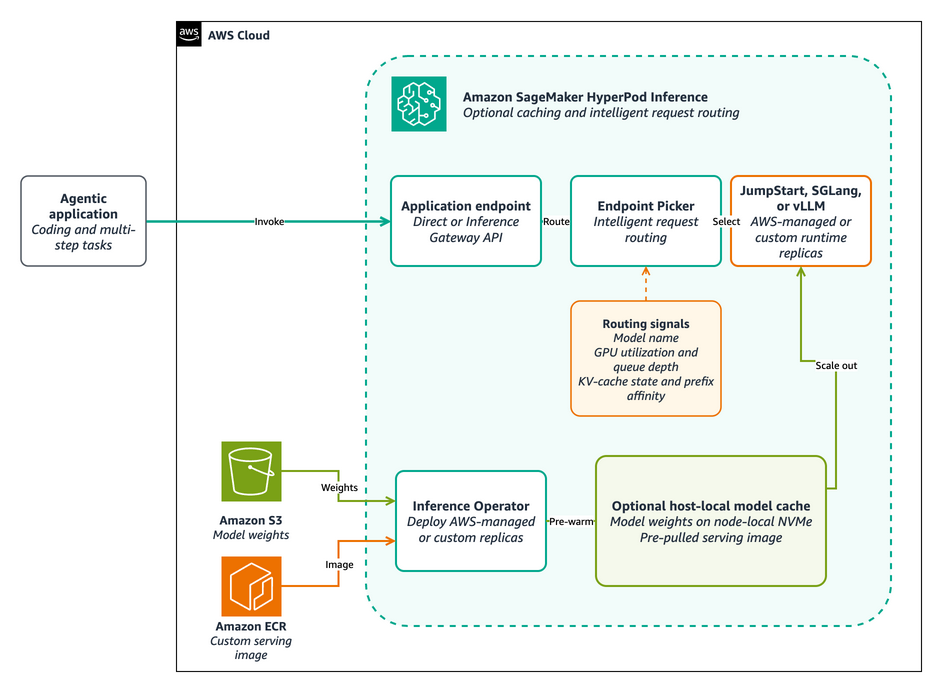
Según un blog oficial de AWS del 16 de octubre de 2026, Reflection AI publicó Beam, un modelo de pesos abiertos orientado a codificación con agentes y tareas de largo plazo, como mantener código, invocar herramientas, interpretar resultados y completar flujos de trabajo de varios pasos. El modelo es una mezcla dispersa de expertos (MoE) con 501.000 millones de parámetros totales y 23.000 millones de parámetros activos; Reflection reporta una longitud de contexto efectiva de 1 millón de tokens. Reflection publicó los pesos de Beam a través de Hugging Face bajo licencia Apache 2.0; Beam 1.0 ofrece tres variantes de puntos de control: BF16, FP8 y NVFP4, para adaptarse a distintos consumos de memoria y hardware. En el momento del lanzamiento, el modelo está disponible en Amazon SageMaker JumpStart en dos regiones de EE. UU. oriental (Virginia del Norte y Ohio). El blog también presenta dos rutas de despliegue: endpoints en tiempo real de SageMaker JumpStart (totalmente gestionado) e inferencia de SageMaker HyperPod (con contenedores gestionados de JumpStart o SGLang y vLLM personalizados). El texto incluye además guías para elegir instancias según la precisión: FP8 usa ml.p5.48xlarge con H100 o ml.p5e/ml.p5en.48xlarge con H200; NVFP4 usa ml.p6-b200.48xlarge con B200, y se enfatiza que los pesos BF16 tienen la mayor demanda de memoria y requieren planificación multinodo. Hay que señalar que esta es la descripción reportada por el blog; KimiSeek no verificó de forma independiente las capacidades del modelo, el soporte de instancias ni la disponibilidad regional.
Impacto para desarrolladores
La consecuencia directa para los desarrolladores es que se trata de un lanzamiento de pesos abiertos y declarado bajo licencia Apache 2.0, lo que en el plano de licencias es más explícito que solo «pesos descargables», pero los derechos de licencia deben regirse por el repositorio de Hugging Face y el texto de los términos; no se puede inferir del hecho de que los pesos estén disponibles el alcance de autorización para uso comercial, redistribución o entrenamiento derivado. En ingeniería, la estructura dispersa de 501B/A23B implica que la memoria de GPU y el costo de despliegue vienen determinados por los parámetros totales, mientras que el cómputo por token se acerca más a la escala de 23B activos; por ello, la memoria de pesos, el particionado y la disposición de paralelismo son la restricción principal: BF16 requiere memoria agregada de varios nodos, mientras que FP8 y NVFP4 reducen el hardware viable a instancias específicas con H100/H200 y B200. Existen compensaciones reales entre formas de despliegue: los endpoints en tiempo real de JumpStart encapsulan el modelo, el contenedor y el endpoint en un flujo gestionado, adecuado para validación rápida; HyperPod expone el clúster y el entorno de ejecución, permite fijar el digest de la imagen, el commit SHA de Beam y los parámetros de paralelismo, y es adecuado para equipos que necesitan reproducir resultados de rendimiento o personalizar cuantización y analizadores. El contexto efectivo de 1 millón de tokens mencionado en el blog afecta el presupuesto de caché KV y las estrategias de batching; el consumo de memoria en contextos largos debe medirse, no estimarse. Para la evaluación, el modelo está orientado a invocaciones de herramientas de varios pasos, por lo que los benchmarks de preguntas y respuestas de un solo turno no bastan para describir su comportamiento en bucles de agentes reales; se deben construir cargas con solicitudes representativas de codificación y uso de herramientas.
Integración y evaluación
Las siguientes son sugerencias de evaluación basadas en ese blog, no conclusiones ya verificadas. Primero, decidir entre «gestionado o autogestionado»: si el objetivo es poner en marcha la integración lo antes posible y el equipo no tiene capacidad de operar Kubernetes, usar los endpoints en tiempo real de JumpStart con un ciclo de vida acotado (desplegar, una solicitud, limpiar), fijando como condición de éxito que el endpoint, una vez listo, devuelva respuestas que cumplan el esquema de solicitud publicado; solo cuando se necesiten parámetros de ejecución fijos, cuantización o analizadores personalizados conviene pasar a SGLang o vLLM sobre HyperPod, con la condición de aprobación de que el digest de la imagen, la revisión del modelo y la configuración de paralelismo sean reproducibles. Segundo, tomar una decisión de capacidad según la precisión: estimar la memoria agregada a partir de los pesos de una réplica, la caché KV y la sobrecarga del entorno de ejecución, y corregirla con pruebas de carga; si el contexto objetivo se acerca al límite efectivo reportado, verificar primero si el tiempo hasta el primer token p95 y el tiempo por token de salida en contextos largos cumplen el presupuesto de latencia; si se usa NVFP4 o FP8, hay que volver a comprobar si la calidad de salida se degrada. Tercero, definir una línea de aceptación medible para escenarios de agentes: someter a presión con solicitudes reales de corrección de código e invocación de herramientas de varios pasos, a la concurrencia esperada, y registrar tasa de éxito, tiempo hasta el primer token p50/p95, latencia de extremo a extremo y rendimiento agregado de salida, documentando junto con ello la versión del modelo, el digest de la imagen, la precisión, la longitud de contexto y el estado de caché; de lo contrario, las comparaciones entre configuraciones no son comparables. Cuarto, validar a pequeña escala antes de escalar: confirmar las cuotas de servicio y la capacidad regional del tipo de instancia elegido, teniendo en cuenta que la transferencia de imágenes, la descarga de pesos y la carga particionada consumen un tiempo de arranque en frío considerable; las estrategias de caché y autoescalado deben basarse en mediciones reales, no en supuestos. Quinto, tras las pruebas, limpiar endpoints, clústeres, pesos en caché y recursos IAM temporales según los ejemplos oficiales, para evitar facturación continua.
Límites y cuestiones pendientes
Beam 1.0 (501B/A23B), correspondiente a este lanzamiento, no está actualmente disponible en KimiSeek, por lo que las rutas de despliegue, formas de invocación y cualquier disponibilidad descritas en este artículo se refieren a los canales de lanzamiento de Reflection AI y AWS, no a los servicios de este sitio; Kimi K3, GLM, Qwen, DeepSeek y otros en KimiSeek son modelos distintos y no constituyen evidencia de disponibilidad de esta versión. Este informe se basa en una única fuente, el blog de AWS; KimiSeek no verificó de forma independiente la cantidad de parámetros, la longitud de contexto efectiva, el alcance real de la licencia Apache 2.0, la compatibilidad de hardware de cada variante de punto de control, el estado de disponibilidad en las dos regiones de EE. UU. oriental ni el rendimiento del modelo en benchmarks; el blog no ofrece puntuaciones públicas de benchmarks de codificación o agentes, por lo que las afirmaciones de capacidad no deben tomarse como hechos verificados. Pesos abiertos no equivale a código abierto completo: los términos de licencia, los datos de entrenamiento y los materiales de reproducción deben regirse por el repositorio de Hugging Face y las declaraciones oficiales de Reflection. Las capacidades de caché, enrutamiento y puerta de enlace de HyperPod mencionadas pertenecen al ámbito funcional de SageMaker en 2026, su comportamiento cambia con las versiones y debe consultarse la documentación correspondiente; los tipos de instancia y las regiones también pueden ajustarse con el tiempo. Sobre costos, deben regirse por las páginas de precios o facturación de Reflection AI, Hugging Face y AWS respectivamente; los precios y las cuotas cambian. Además, los parámetros de muestreo del blog (como temperature y top-p) son solo valores iniciales de ejemplo y no representan una configuración recomendada.
Ilustraciones de la noticia original