Reflection Beam y Mistral Large 4 coinciden en su presentación: más opciones de pesos abiertos, pero los pesos y la licencia aún no están disponibles
Según informó InfoQ en chino en octubre de 2026, entre el 5 y el 6 de octubre la estadounidense Reflection presentó Beam, su primer modelo MoE de pesos abiertos, y la francesa Mistral lanzó Mistral Large 4, el mayor hasta la fecha. El informe señala que la eficiencia de inferencia es el argumento de venta de Beam y que algunos benchmarks se acercan a GLM-5.2 pero quedan por detrás de la última generación china; Large 4 ya tiene vista previa de API y el plan es publicar los pesos completos a finales de octubre. Ninguna de las dos versiones está listada actualmente en KimiSeek.
Qué ha cambiado
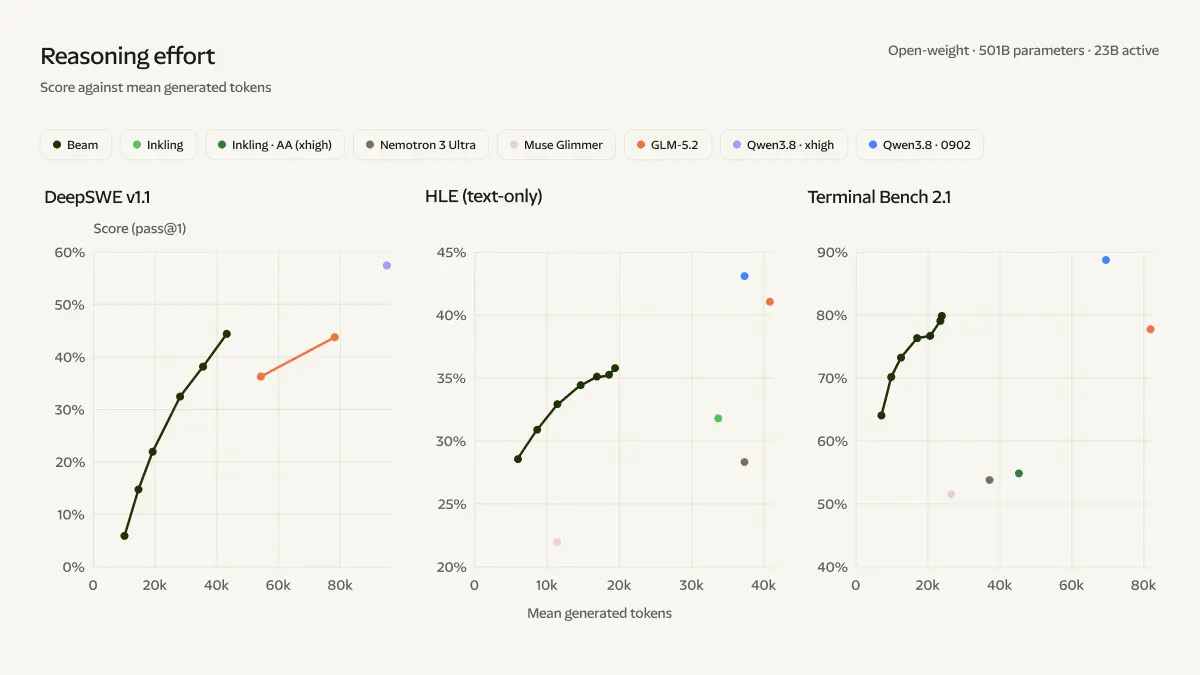
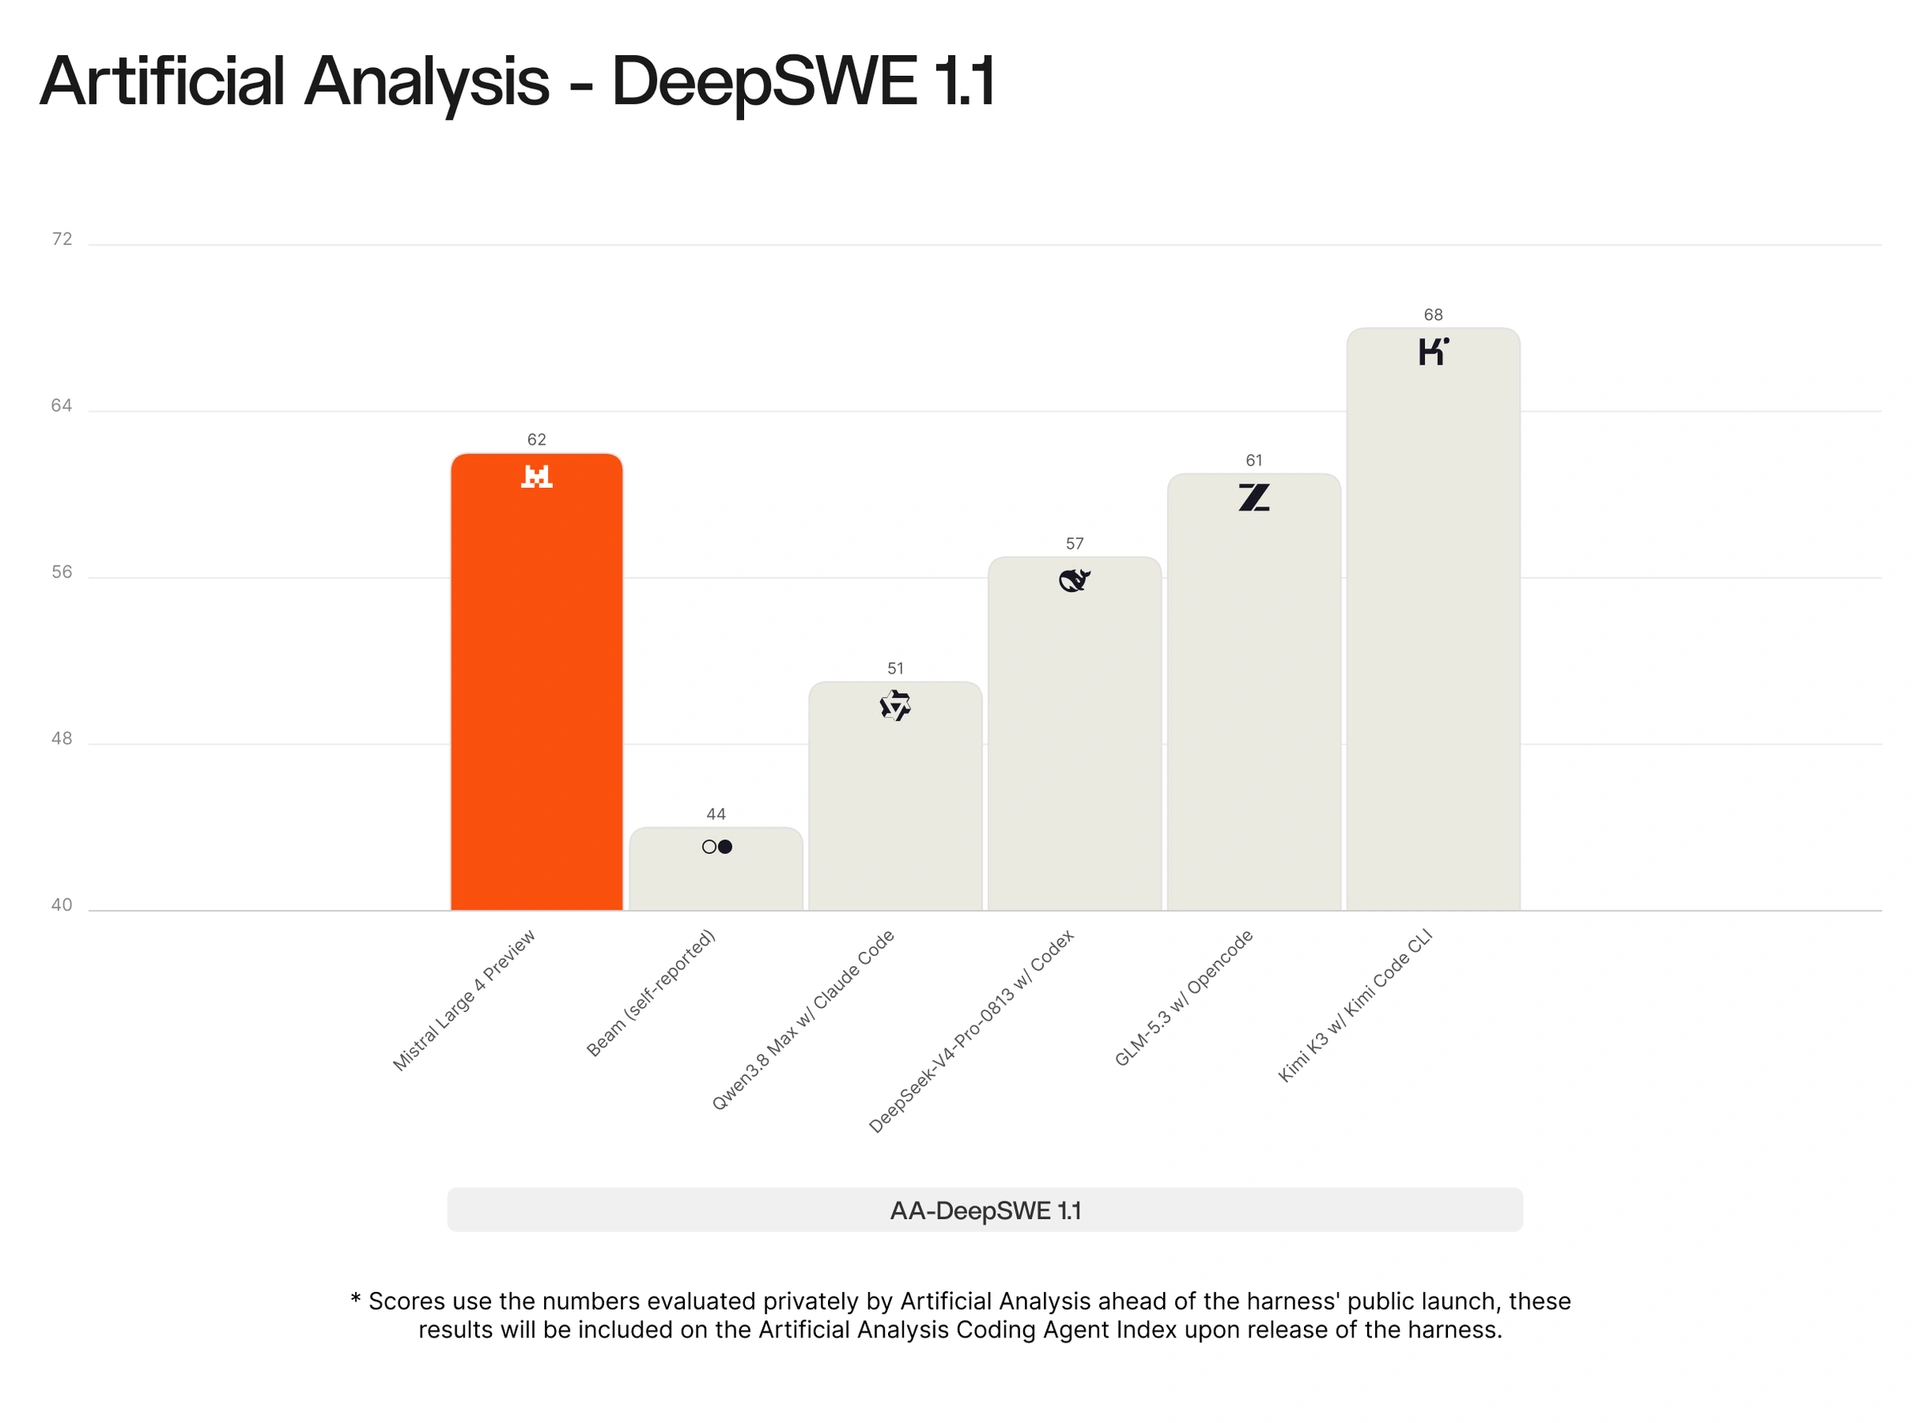
Según informó InfoQ en chino (el texto original señala los días 5 y 6 de octubre, hora local), la startup estadounidense Reflection presentó Beam, su primer modelo de pesos abiertos, y un día después la francesa Mistral lanzó Mistral Large 4. El informe indica que Beam es un modelo MoE con 501.000 millones de parámetros totales y 23.000 millones activados por token, orientado a cargas de trabajo de programación, razonamiento y agentes, preentrenado con 23,8 billones de tokens y con aprendizaje por refuerzo de alta intensidad computacional durante cuatro semanas consecutivas usando 10.500 GPU Nvidia GB300, generando más de 100 millones de rollouts; en el momento del lanzamiento seguía en la fase final de red teaming, y el informe señala que Reflection planea publicar los pesos, el informe técnico y las herramientas de desarrollo en octubre. Mistral Large 4, según el informe, tiene 52.000 millones de parámetros activados y 1,05 billones totales, incluye un codificador visual de 1.600 millones de parámetros, es nativamente multimodal, admite más de 160 idiomas y tiene una ventana de contexto de 1 millón de tokens; se afirma que fue entrenado desde cero en un centro de datos europeo con aproximadamente 3.800 GPU Nvidia Grace Blackwell, y en el momento del informe ya tenía vista previa de API, con el plan de publicar los pesos completos a finales de octubre. Entre los datos de benchmark que retoma el informe, Beam obtiene 44,4 en DeepSWE v1.1 y 80,1 en Terminal Bench v2.1, ambos por debajo de los resultados de GLM-5.3, Kimi K3 y DeepSeek V4.1 Flash que el informe enumera; en Humanity's Last Exam Beam obtiene 36,2, por debajo del 42,3 de GLM-5.3 y el 46,9 de Kimi K3 que el texto original también enumera (el texto original no da la puntuación de DeepSeek V4.1 Flash en esa prueba). En el lado de Mistral, el informe señala que Large 4 supera a DeepSeek V4 Pro y Qwen 3.8 Max en el Coding Agent Index oficial, pero queda por debajo de Kimi K3, y que en AutomationBench supera a Kimi K3, MiMo-V2.6-Pro y DeepSeek V4 Pro, pero queda por debajo de GLM-5.3. Estas puntuaciones proceden respectivamente de afirmaciones de los fabricantes o de pruebas de terceros citadas por ellos, son retomadas por el informe y no han sido reproducidas de forma independiente.
Impacto para desarrolladores
Este conjunto de lanzamientos cambia el conjunto de candidatos y las coordenadas de comparación del bando de los pesos abiertos, no la disponibilidad inmediata de los modelos chinos. El punto con más implicaciones de ingeniería es que Reflection desplaza el argumento de venta de Beam de la capacidad absoluta a "cuánta inteligencia se obtiene por unidad de cómputo de inferencia"; el informe señala que algunas tareas de razonamiento avanzado pueden alcanzar un rendimiento cercano al de GLM-5.2 con aproximadamente un cuarto o un tercio de su cómputo. Si esa afirmación se sostiene en cargas de trabajo propias, lo que cambia es la estructura de coste por tarea de los agentes de cadena larga y la inferencia por lotes. Pero según los benchmarks retomados por el informe, Beam iguala principalmente a la generación anterior de modelos chinos: en DeepSWE v1.1 y Terminal Bench v2.1 queda por debajo de GLM-5.3, Kimi K3 y DeepSeek V4.1 Flash enumerados en el texto original, y en HLE por debajo de GLM-5.3 y Kimi K3 allí enumerados. Por tanto, "menos cómputo por una capacidad cercana" y "igual cómputo por mayor calidad" son dos rutas de sustitución distintas que no pueden sustituirse entre sí. Mistral Large 4 tiene un enfoque diferente: contexto de orden millonario, multimodalidad nativa y multilingüismo, junto con el despliegue en nube privada o local y las políticas de seguridad personalizadas que destaca el informe, apuntan a flujos de trabajo empresariales entre aplicaciones y escenarios que requieren control sobre los límites de los datos, más que a una competición pura de benchmarks de programación. Hay que distinguir conceptos: a ambas se las describe como de pesos abiertos, pero los momentos de disponibilidad de los pesos difieren en el informe, y en el lanzamiento ninguna de las dos había abierto realmente los pesos; pesos abiertos significa archivos de modelo descargables, lo cual es una cuestión distinta de si los datos de entrenamiento, el código de entrenamiento y los términos de licencia son abiertos. El informe no ofrece detalles de licencia, por lo que no pueden inferirse derechos de uso comercial, redistribución o ajuste fino. Además, según la verificación del catálogo actual, ni Beam ni Mistral Large 4 tienen entrada correspondiente en KimiSeek; la vista previa de API y la disponibilidad descritas en el informe se refieren a los canales propios de los fabricantes.
Integración y evaluación
Lo siguiente es análisis o recomendación condicional, no hechos del informe. Primero, si la carga principal es programación con agentes de cadena larga y el coste es sensible: el informe señala que Beam puede acercarse al rendimiento de GLM-5.2 con aproximadamente un cuarto o un tercio de su cómputo de inferencia, y que entre las opciones similares disponibles actualmente están GLM-5.2 y DeepSeek V4.1 Flash; puede hacerse primero una comparación de muestra pequeña con trayectorias propias de llamadas a herramientas en múltiples turnos, midiendo "tokens totales y latencia de extremo a extremo por tarea completada", siempre que se acepte que en los benchmarks del informe está por debajo de la última generación china; si el aumento de la tasa de fallos provoca reintentos, el ahorro de cómputo se anula, y en ese caso no conviene sustituir; puede fijarse como criterio de evaluación que la caída de la tasa de éxito de extremo a extremo en el mismo conjunto de tareas no supere un umbral predefinido. Segundo, si la carga requiere contexto de orden millonario, entrada multimodal o multilingüe: se informa que Mistral Large 4 admite un contexto de 1 millón de tokens y más de 160 idiomas, pero los pesos y los términos finales no están definidos; conviene verificar primero, durante la fase de vista previa de la API, la precisión de recuperación en contexto largo y el comportamiento del codificador visual con documentos propios, midiendo la precisión de preguntas y respuestas en contexto largo y el coste por solicitud, sin equiparar el comportamiento de la versión preliminar al de futuros pesos abiertos, y manteniendo el modelo principal actual como respaldo. Ambas reglas deberían revisarse una vez más cuando los pesos se publiquen oficialmente y la licencia quede clara.
Límites y cuestiones pendientes
El contenido del informe procede principalmente de afirmaciones de los fabricantes y de pruebas de terceros citadas por ellos; las puntuaciones de benchmark no han sido reproducidas de forma independiente y no deben tomarse como conclusiones verificadas. Cabe señalar en particular que el texto original, en Humanity's Last Exam, solo ofrece Beam 36,2, GLM-5.3 42,3 y Kimi K3 46,9, y no enumera la puntuación HLE de DeepSeek V4.1 Flash; por tanto, la comparación en HLE debe limitarse a GLM-5.3 y Kimi K3, que son los que el texto original enumera realmente. Combinar los tres benchmarks como "por debajo de los tres en todos" es una comparación entre benchmarks que el texto original no respalda. Además, ni Beam ni Mistral Large 4 tienen entrada correspondiente entre los modelos actuales de KimiSeek, es decir, estas dos versiones no están listadas actualmente en KimiSeek; la vista previa de API y el plan de publicación de pesos descritos en el informe se refieren a la disponibilidad en los canales propios de los fabricantes y no guardan relación con que KimiSeek los ofrezca o no. La disponibilidad de los pesos no equivale a una licencia de código abierto; el informe no da términos de licencia, y los derechos de uso comercial y redistribución deben atenerse a la licencia que los fabricantes publiquen realmente. El informe señala que los pesos de Beam se publicarían en octubre y que los pesos completos de Large 4 se publicarían a finales de octubre; en el lanzamiento ninguna de las dos había abierto realmente los pesos, y sigue siendo incierto si se cumplirán los plazos y cómo cambiarán los términos. La afirmación de "aproximadamente un cuarto o un tercio del cómputo" es una declaración de Reflection y carece de una metodología de medición independiente; el efecto real de la sustitución debe verificarse en cargas de trabajo propias. Este resumen no juzga si se cumplirán las hojas de ruta futuras ni los compromisos de modelo de negocio de ambas empresas.
Ilustraciones de la noticia original