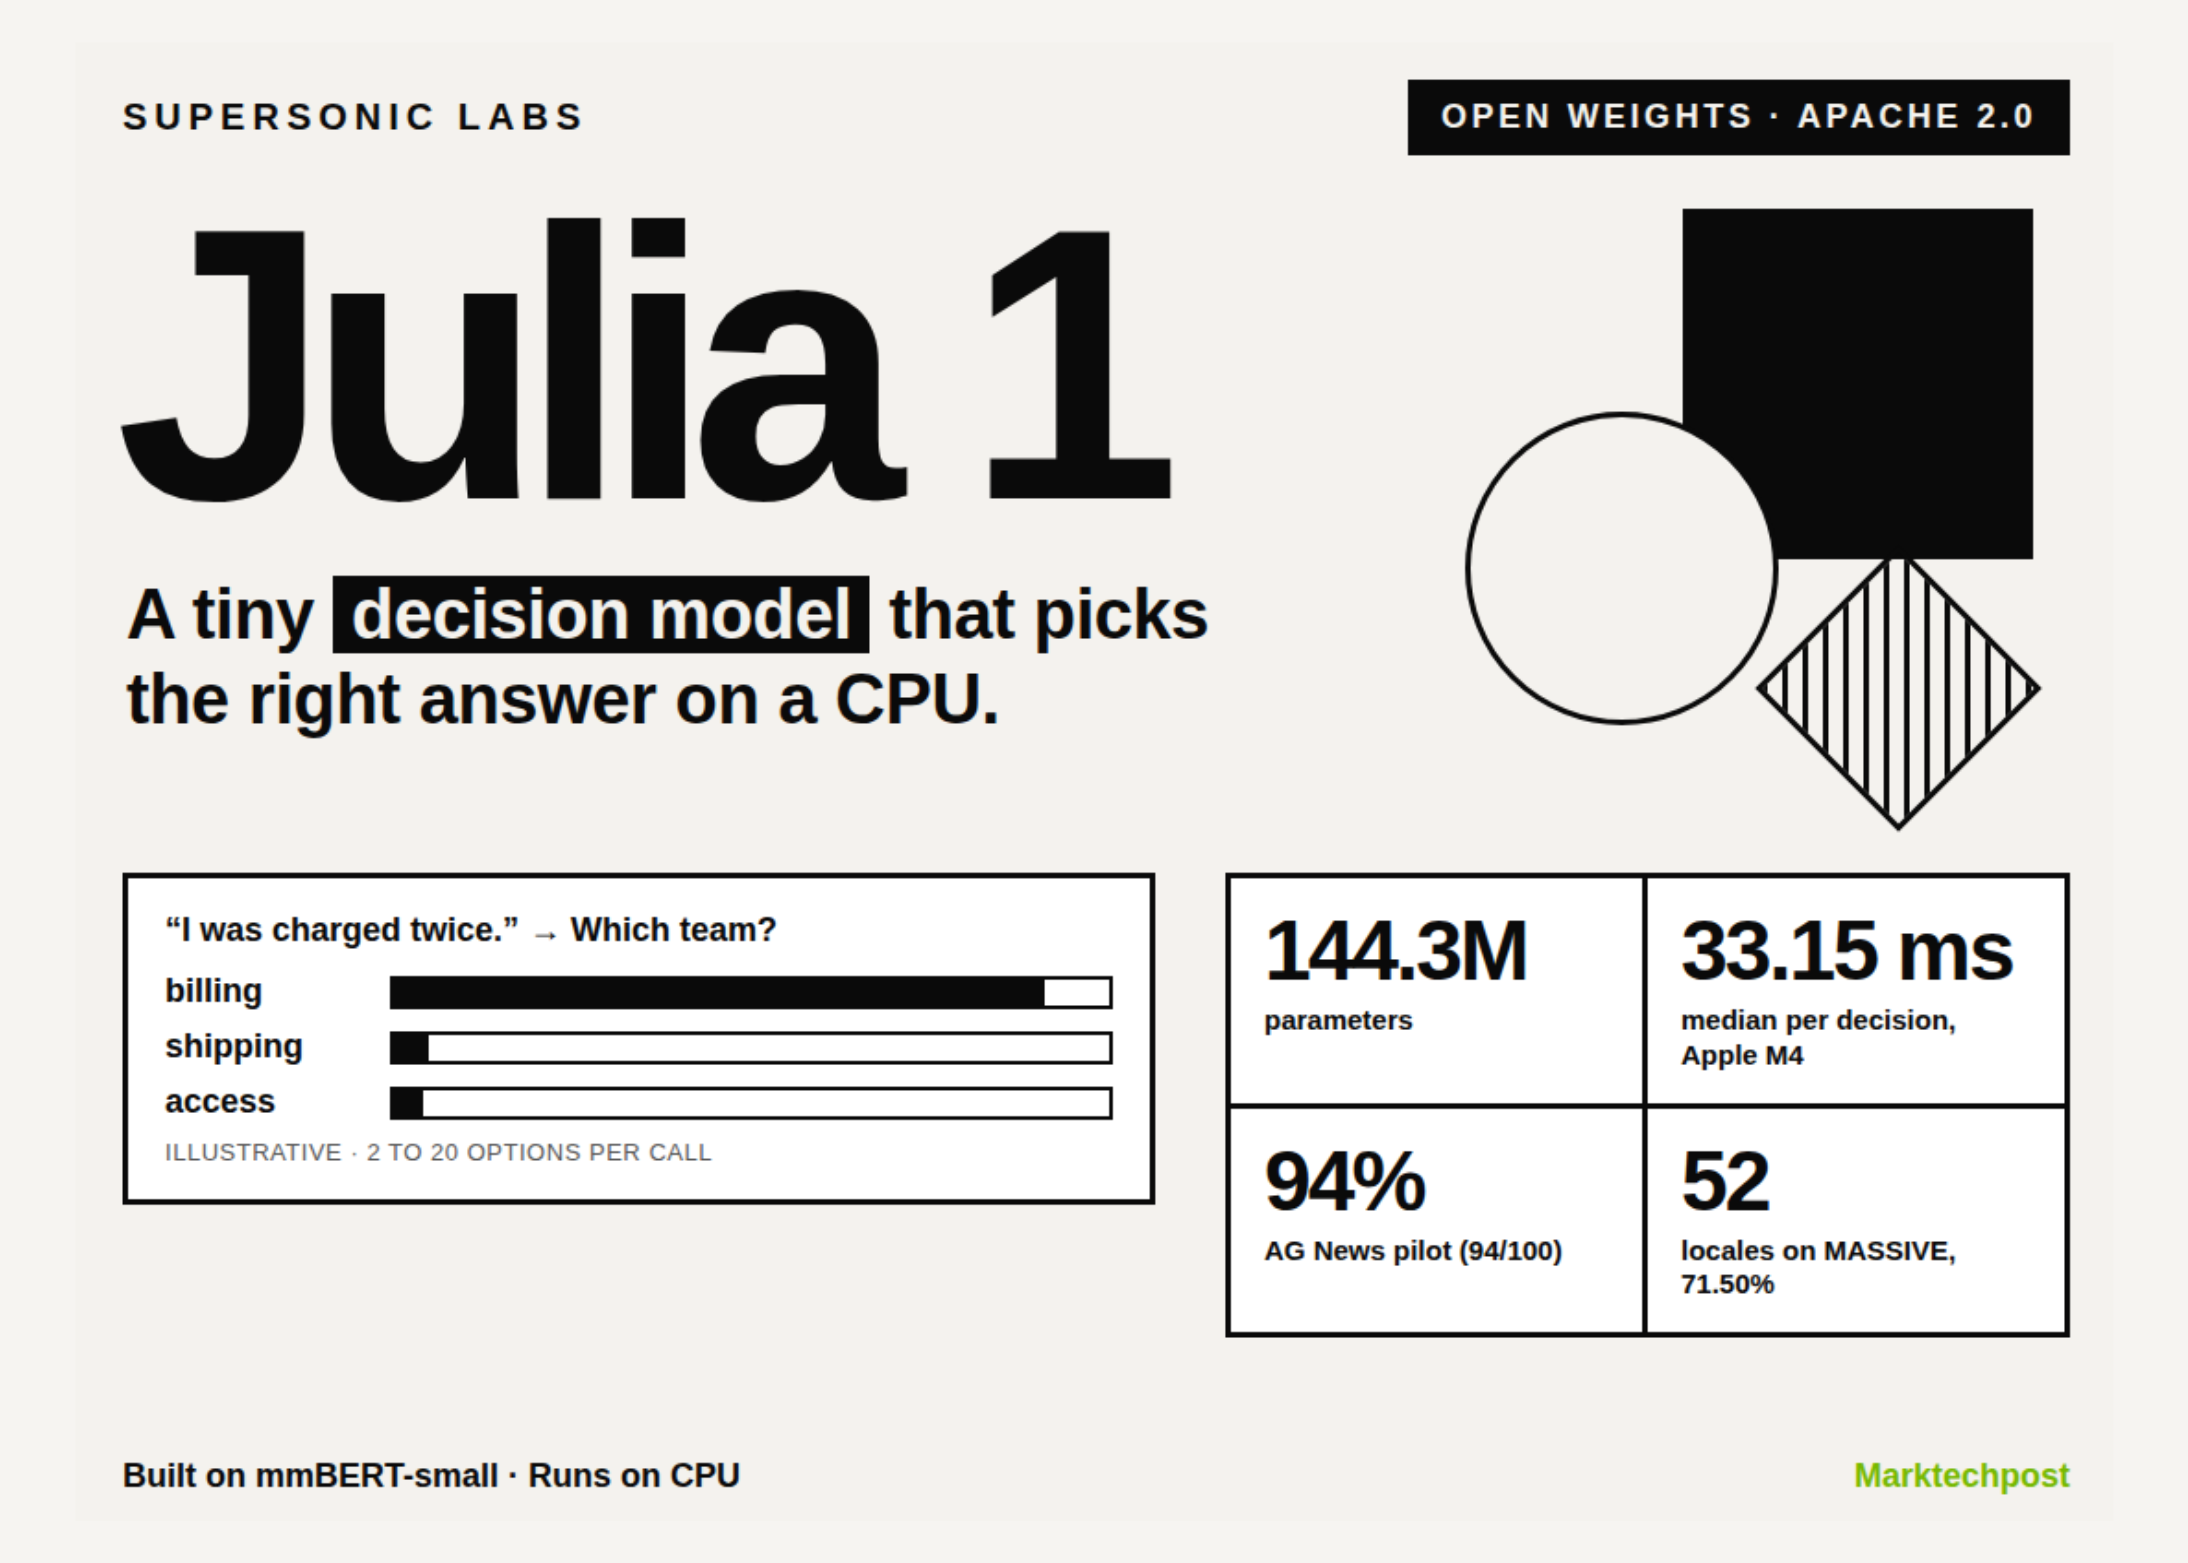
Supersonic Labs lanza Julia 1: un modelo de decisión de 144,3 millones de parámetros bajo Apache 2.0 que se ejecuta en CPU
Según MarkTechPost del 26 de septiembre de 2026, el laboratorio brasileño Supersonic Labs publicó Julia 1, un modelo de decisión de 144,3 millones de parámetros basado en mmBERT-small, con pesos liberados bajo Apache 2.0, que admite tres tipos de llamada: choice, score y noul, y puede ejecutarse localmente en CPU. En sus pruebas supera los valores de referencia de Jev en Typed Decisions, AG News y DAIR Emotion, pero queda claramente por detrás en Banking77 con 72 etiquetas; la API alojada ha sido anunciada pero aún no está disponible.

Qué ha cambiado
Según MarkTechPost del 26 de septiembre de 2026, el pequeño laboratorio brasileño Supersonic Labs publicó Julia 1 (nota: esta versión no figura actualmente en el catálogo de KimiSeek; la disponibilidad de API mencionada en el reporte se refiere al lado del proveedor). Es un modelo de decisión, no un modelo de chat: quien llama pasa un contexto, una pregunta y entre 2 y 20 respuestas candidatas con descripciones, y el modelo devuelve el elemento seleccionado en el orden dado junto con la probabilidad softmax completa; el ID del llamante se devuelve tal cual y no se genera texto libre. Los pesos se publicaron bajo Apache 2.0 en Hugging Face (la disponibilidad de pesos no equivale a tener una licencia de código abierto; aquí la fuente indica explícitamente Apache 2.0), y en entornos Python 3.11+ pueden ejecutarse en CPU o en GPU con soporte BF16; además hay una compilación ONNX que puede correr en el navegador vía WebGPU. La API alojada ha sido anunciada pero aún no está disponible. El modelo se basa en el codificador mmBERT-small de JHU CLSP más una cabeza de decisión, y el laboratorio afirma explícitamente que no es un ajuste fino de Qwen. En tiempo de ejecución, el límite de tokens combinados es 8.192, y los benchmarks públicos usan 1.024. Los tres tipos de llamada son choice (clasificación, enrutamiento), score (puntuación ordenada que devuelve el índice esperado) y noul (probabilidad de que sea verdadero/falso). La evaluación reportada del 24 de septiembre de 2026 se ejecutó en H200 BF16 con codificación estricta, comparando contra los valores de referencia del protocolo de benchmark TypeSafe Jev en lugar de reejecutar Jev: Typed Decisions 73,15 % (referencia 72,70 %), AG News 94/100 (referencia 91 %), DAIR Emotion 86/100 (referencia 48 %), Banking77 solo 64/100 (referencia 87 %), MASSIVE con macro-promedio de 71,50 % en 52 regiones lingüísticas, pt-PT 86,25 % y en-US 86,75 %. Cada prueba de clasificación usó solo 100 muestras. Una ejecución en CPU del 25 de septiembre reprodujo Typed Decisions 72,55 %, Banking77 60/100 y 3 abstenciones. En cuanto a latencia, el reporte indica una mediana de 33,15 ms por decisión en Apple M4; en la tableta Samsung SM-X510, mediana de 203 ms y RSS máximo de 393,1 MB con ONNX Runtime; en Intel Core i5-1235U, mediana de 107,83 ms para AG News, mientras que Banking77, al requerir primero reducir 72 etiquetas, tarda 3.713,54 ms.
Impacto para desarrolladores
El efecto directo para los desarrolladores es la aparición de una vía opcional para separar la "clasificación/enrutamiento/puntuación" de los modelos grandes y llevarla a un modelo pequeño en el borde. Con 144,3 millones de parámetros y pesos FP32 de unos 550,5 MiB, puede caber en un teléfono, tableta, portátil o incluso el navegador, sin pagar por cada llamada de clasificación ni necesitar conexión; el precio previsto de la API mencionado en el reporte es de 0,025 USD por millón de tokens de entrada, pero esa API aún no está disponible y la fecha del reporte de ese precio es septiembre de 2026, por lo que el lector debe confirmar el precio actual en la página más reciente del proveedor y no en este texto. Al mismo tiempo, hay que ver con claridad sus límites: solo compara entre los candidatos que se le dan, no puede completar hechos faltantes ni hacer álgebra o cálculos de varios pasos, el Router puede descartar la etiqueta correcta durante la reducción, y no es un componente que reemplace directamente una pipeline existente de Transformers; según el reporte, ningún proveedor de inferencia de Hugging Face lo aloja. En el plano de los benchmarks, la señal más importante no es "supera a Jev en tres pruebas", sino la fuerte degradación cuando el espacio de etiquetas pasa de 4 o 6 a 72: AG News 94/100 frente a Banking77 64/100, y la reproducción en CPU solo 60/100, lo que indica que es más adecuado para decisiones de grano grueso con pocas etiquetas que para clasificación fina con muchas clases. Además, la afirmación del reporte de ser "5 veces más rápido que Jev" proviene de una publicación en X del fabricante, mientras que la prueba de Jev se midió llamando a Jev como servicio alojado desde Francia, de modo que las latencias no se comparan en condiciones equivalentes y no conviene tomarlas directamente como válidas.
Integración y evaluación
Lo siguiente es análisis y recomendaciones condicionales basados en el reporte, no hechos ya verificados. Primera decisión: si usar directamente la salida de este modelo como enrutamiento automático en producción. En el reporte, "cuantas más etiquetas, peor" (Banking77 64/100, CPU 60/100) y "el Router puede perder etiquetas" son dos variaciones distintas y deben tratarse por separado; si tu escenario tiene más de unas veinte etiquetas y un error puede desencadenar acciones irreversibles como cobros, permisos o reembolsos, conviene no ejecutar directamente la salida del modelo, sino añadir una segunda comprobación o revisión humana; si las etiquetas son muy pocas (por ejemplo, una clasificación gruesa de hasta 4 clases) y la acción es reversible, se puede empezar con un despliegue gradual. Criterio de evaluación medible: sobre al menos 200 solicitudes reales muestreadas por ti, comparar la coincidencia entre el elemento seleccionado por el modelo y la anotación humana, y contar por separado la proporción de "respuestas correctas excluidas en la fase de reducción del Router". Segunda decisión: si sustituir las llamadas actuales de clasificación alojada por un despliegue en el borde. Las mediciones de dispositivos del reporte son M4 mediana 33,15 ms, SM-X510 mediana 203 ms, i5-1235U mediana 107,83 ms para AG News, y Banking77 hasta 3.713,54 ms, lo que implica que el número de candidatos o el tamaño del conjunto de etiquetas es una condición previa para la viabilidad; cuando tus solicitudes sean principalmente de pocas etiquetas y texto corto y puedas aceptar inferencia local sin red del orden de cientos de milisegundos, el borde sale más a cuenta; cuando el número de etiquetas sea grande o se requiera baja latencia y alta concurrencia, la vía de CPU en el borde puede no ser viable. Criterio de evaluación medible: en tus dispositivos objetivo y con longitud de entrada fija, medir por separado la latencia P50 y P95 y el pico de memoria de cada tipo de decisión (valor de referencia del reporte: RSS 393,1 MB), y compararlo en la misma máquina con tu solución actual. Tercera decisión: si migrar ahora el negocio a la API alojada. El reporte dice claramente que la API ha sido anunciada pero aún no está disponible, así que por ahora solo cabe el autoalojamiento; se recomienda validar primero a pequeña escala con los pesos locales, confirmar bien la disponibilidad, los límites de tasa y la facturación del lado de la API antes de decidir el cambio, y no planificar capacidad basándose en el precio previsto del reporte. En cuanto a los pasos de evaluación, se sugiere fijar primero entradas de hasta 1.024 tokens y construir candidatos según los criterios del informe, hacer una prueba de coincidencia offline, luego una prueba de carga en dispositivo, y solo si ambas cumplen, pasar a un despliegue gradual.
Límites y cuestiones pendientes
La limitación central de este reporte son las muestras y los criterios de comparación. Cada prueba de clasificación usa solo 100 muestras; aunque Typed Decisions tiene 2.000, los demás ítems tienen intervalos de confianza amplios, insuficientes para conclusiones fuertes; la línea base usa los valores de referencia del protocolo Jev en lugar de reejecutar Jev en el mismo entorno, y la latencia de Jev se midió con el servicio alojado llamado a través de fronteras, por lo que no es comparable con la ejecución local de este modelo; la afirmación del fabricante de ser "5 veces más rápido" necesita por tanto verificación independiente. La canalización de entrenamiento privada del modelo no se ha hecho pública, por lo que no se puede comprobar la composición de los datos ni posibles sesgos. La reproducción en CPU del 25 de septiembre produjo 3 abstenciones, lo que indica que el comportamiento puede degradarse en entornos de bajos recursos. La API alojada que menciona el reporte aún no estaba disponible cuando se escribió este texto; el precio previsto de 0,025 USD por millón de tokens de entrada proviene de un reporte de septiembre de 2026, los precios cambian, así que guíate por la página de precios del proveedor. Hay que señalar en particular que esta versión Julia 1 no figura actualmente en el catálogo de KimiSeek; la disponibilidad de API mencionada en el reporte se refiere a los planes del lado del proveedor y no tiene relación con la plataforma KimiSeek. Además, el reporte no ofrece detalles como la redacción de las respuestas candidatas, la sensibilidad al orden o la estabilidad multilingüe (en MASSIVE solo se reportan el macro-promedio y dos regiones lingüísticas), factores que pueden afectar el rendimiento real y que el lector deberá comprobar por su cuenta.
Ilustraciones de la noticia original