Underdog lanza Saluki 27B: un Qwen3.8-27B en 2 bits de 7,89 GB que supera al original en llamadas a herramientas
Según MarkTechPost, el 9 de octubre de 2026, Underdog, de Conway Research, publicó Saluki 27B bajo Apache 2.0, comprimiendo el Qwen3.8-27B de 54 GB a un GGUF mixto de 2 bits y 7,89 GB que se ejecuta en llama.cpp original; su puntuación en llamadas a herramientas supera al original, pero en matemáticas de competición y razonamiento de varios pasos baja entre 12 y 18 puntos.
Qué ha cambiado
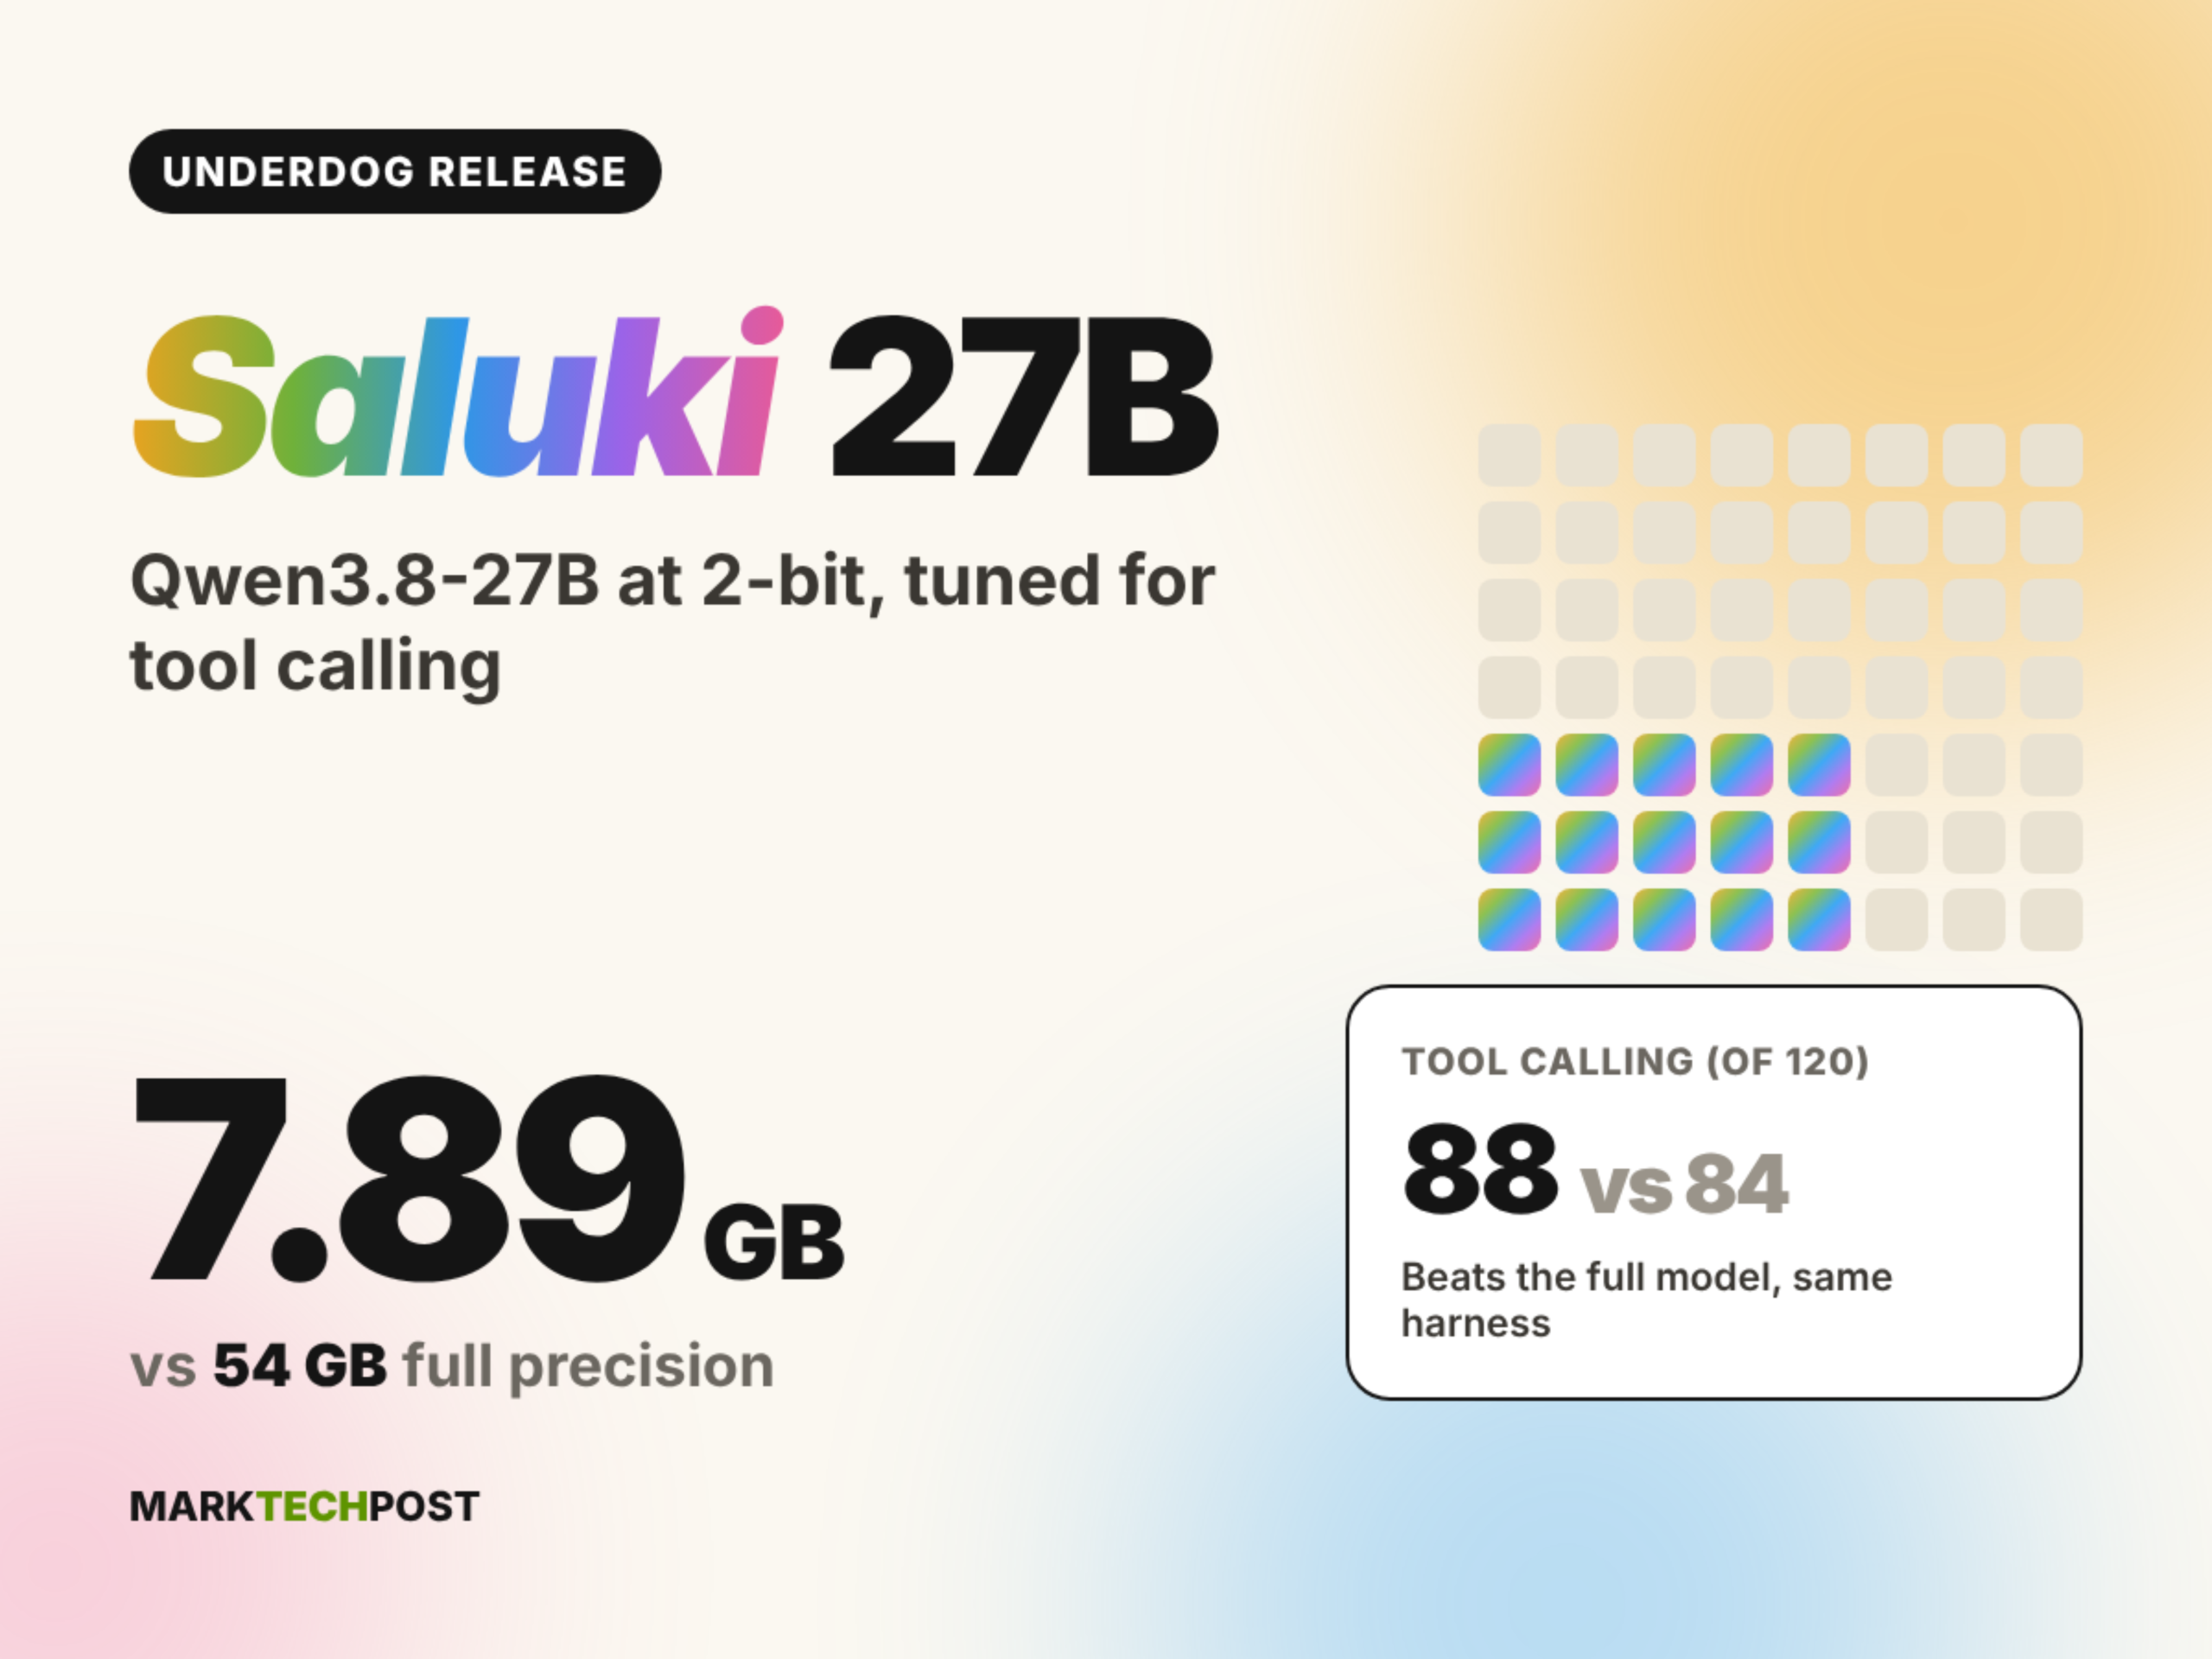
Según MarkTechPost, el 9 de octubre de 2026, Underdog, el proyecto de asistente en dispositivo de Conway Research, publicó Saluki 27B bajo licencia Apache 2.0. Este modelo es una versión GGUF de precisión mixta de 2 bits de Qwen3.8-27B, con un archivo de 7,89 GB, frente a los 54 GB del modelo BF16 completo. El informe afirma que su construcción superpone tres capas de trabajo: la base es el modelo denso 27B del equipo Qwen, Qwen3.8-27B (64 capas, atención lineal híbrida Gated DeltaNet y atención con compuertas, 262.144 tokens nativos); sobre ella, el GGUF GSQ-RCO de ISTA-DASLab, cuyo archivo mínimo IQ2_XS es de 8,4 GB y un promedio de 2,50 bits por peso; y Underdog aplica su propia compresión y optimización de llamadas a herramientas, produciendo archivos denominados IQ2-mix con marca imatrix, aunque el informe señala que Underdog aún no ha publicado la receta completa de este paso. En cuanto a la ejecución, el informe indica que el modelo puede ejecutarse directamente en llama.cpp original y en aplicaciones basadas en él, con soporte completo de offload a GPU, además de un módulo visual opcional de 629 MB o 928 MB. En benchmarks, el informe presenta dos conjuntos de resultados autodeclarados por Underdog: en una comparación con el modelo completo bajo el mismo marco, Underdog Bench (120 tareas de BFCL v4, modo de pensamiento desactivado, temperature 0) Saluki obtiene 88 puntos frente a 84 del modelo completo; llamadas a herramientas en paralelo 42 frente a 35; en SWE-bench Verified, 30 de 50 issues reparados frente a 33. En la comparación con puntuaciones públicas de modelos completos, IFEval 93,5 frente a 91,5, IFBench 72,7 frente a 71,0, MBPP+ 78,0 frente a 83,9, MuSR 67,5 frente a 79,6, AIME 2025 79,2 frente a 96,7, AIME 2026 80,0 frente a 94,6. El informe también incluye como referencia ISTA GSQ-RCO IQ2_XS y PrismML Bonsai 2 27B, y subraya que cada fabricante utiliza su propio marco de pruebas y que las puntuaciones entre fabricantes no son directamente comparables; Bonsai 2 es más pequeño pero requiere la rama de llama.cpp de PrismML.
Impacto para desarrolladores
Para los desarrolladores que necesitan agentes locales, el cambio sustantivo de esta noticia es que un modelo de llamadas a herramientas de nivel 27B tiene sus pesos cuantizados a menos de 8 GB y no requiere una rama de llama.cpp de terceros para cargarse. Esto altera directamente el juicio sobre los requisitos de VRAM y el umbral de despliegue: el offload completo en una GPU de consumo de una sola tarjeta o incluso en una máquina con mucha memoria se vuelve realista, y también hace más calculable en coste la arquitectura híbrida de «bucle de agente local + modelo remoto de respaldo». Pero hay que distinguir entre pesos abiertos y derechos de licencia: el informe afirma que el archivo se publica bajo Apache 2.0, lo que es una declaración a nivel de licencia; si es comercializable o no debe verificarse volviendo a la model card y al texto original de la licencia, y que los pesos sean descargables no equivale por sí mismo al alcance de la autorización de la licencia. Además, hay que tener en cuenta que la distribución de capacidades no es uniforme: el informe afirma que las métricas de llamadas a herramientas y seguimiento de instrucciones se acercan o superan ligeramente al original, mientras que las de matemáticas y razonamiento de varios pasos, como AIME y MuSR, caen entre 12 y 18 puntos. Esto significa que esta versión cuantizada es adecuada para cargas de orquestación de herramientas, selección de funciones y restricciones de formato, pero no para usarla como motor principal de razonamiento. Por otro lado, todas las puntuaciones provienen de autoevaluaciones de Underdog o de fabricantes citados por él, y los marcos de prueba de distintos fabricantes son diferentes, por lo que son declaraciones reproducidas, no reproducciones independientes, y las clasificaciones entre modelos deben considerarse no comparables. El informe no publica el número de bits por peso, la longitud de contexto ni la receta de compresión; estas incógnitas afectarán el rendimiento real en contextos largos y en concurrencia por lotes.
Integración y evaluación
Recomendación uno (enrutamiento de llamadas a herramientas): si usar Saluki 27B como capa local de selección de funciones y generación de parámetros para agentes depende de si tu carga se basa principalmente en llamadas a herramientas paralelas y salida estructurada. Si tu escenario es de un solo turno o pocas llamadas paralelas y requiere un formato de respuesta estricto, el informe afirma que sus métricas de llamadas a herramientas paralelas y seguimiento de instrucciones se acercan o superan al original, por lo que puede ejecutarse localmente con prioridad; si tu carga depende de planificación de varios pasos de cadena larga, el informe afirma que MuSR y AIME caen claramente, por lo que deberías conservar el original o un modelo más fuerte como respaldo. Criterio de evaluación medible: ejecuta el mismo conjunto de tareas congeladas sobre tu propio esquema de herramientas y compara la precisión de selección del nombre de herramienta y la tasa de validez del JSON de parámetros entre Saluki y el original (o el modelo en línea actual), así como la tasa de finalización de tareas en escenarios de llamadas paralelas. Recomendación dos (selección de esquema de compresión): elegir entre candidatos en el mismo rango de 2 bits depende de si estás dispuesto a mantener un runtime no original. El informe afirma que Saluki puede ejecutarse en llama.cpp original, mientras que PrismML Bonsai 2 requiere su rama de llama.cpp, lo que afecta directamente la complejidad de compilación, actualización y CI; además, el informe afirma que Saluki no publica bits por peso ni contexto, mientras que la alternativa de referencia sí publica 2,50 bits por peso y el tamaño del archivo. Si tu equipo no quiere bifurcar el marco de inferencia, puedes tomar «cargable en llama.cpp original» como requisito previo obligatorio y luego comparar tamaño y precisión; si el tamaño es la restricción principal, deberás aceptar el coste de mantenimiento de la rama. Criterio de evaluación medible: registra en la misma máquina objetivo la latencia del primer token, el pico de VRAM y la estabilidad en contextos largos (cercanos a tu longitud de entrada máxima real), y verifica los requisitos de versión de llama.cpp necesarios para cargar el archivo. Recomendación tres (aceptación tras cuantización): independientemente de la opción elegida, usa como umbral de puesta en producción «si tras la cuantización aún puede completar tareas de extremo a extremo» en lugar de las puntuaciones de benchmark. Criterio de evaluación medible: con muestras de tu tráfico real en producción, compara el número de tareas de reparación superadas, las rondas de llamadas a herramientas y la tasa de reintentos fallidos, y establece un umbral de reversión claro, por ejemplo, revertir automáticamente cuando la tasa de finalización de tareas de extremo a extremo sea inferior a una proporción aceptable respecto al original. Lo anterior es análisis y recomendaciones condicionales, no afirmaciones factuales del informe.
Límites y cuestiones pendientes
Primero, hay que dejar claro: el Saluki 27B del informe (una versión derivada GGUF de 2 bits de Qwen3.8-27B) no aparece actualmente en el catálogo de modelos de KimiSeek; la forma de distribución descrita en el informe consiste en obtener los pesos GGUF en canales como Hugging Face y ejecutarlos localmente en llama.cpp original, sin implicar disponibilidad de API en la plataforma KimiSeek; cualquier afirmación sobre disponibilidad de API se refiere a los canales del propio publicador. Segundo, todas las cifras de benchmark del texto se reproducen de las autoevaluaciones de Underdog y de las puntuaciones públicas que cita, y son declaraciones del publicador; este artículo no las ha reproducido de forma independiente; el propio informe también advierte que cada fabricante usa su propio marco de pruebas y que las puntuaciones entre fabricantes no son directamente comparables. Tercero, el informe no publica el número de bits por peso del archivo, la longitud de contexto ni la receta completa de la tercera capa de compresión, por lo que el rendimiento en contextos largos, concurrencia por lotes y distintos hardware sigue siendo desconocido. Cuarto, que los pesos se publiquen bajo Apache 2.0 es una declaración de licencia del informe; si cumple condiciones comerciales concretas debe verificarse con la model card y el texto original de la licencia; que los pesos sean accesibles no equivale a un alcance de autorización claro. Por último, las afirmaciones sobre las capacidades de la base Qwen3.8-27B (64 capas, atención híbrida, 262.144 de contexto nativo) también provienen de ese informe y no han sido verificadas por este artículo.