Aleph Alpha, 오픈 웨이트 Kolibri 공개: 총 781억 파라미터 MoE, 토큰당 34.6억 활성화
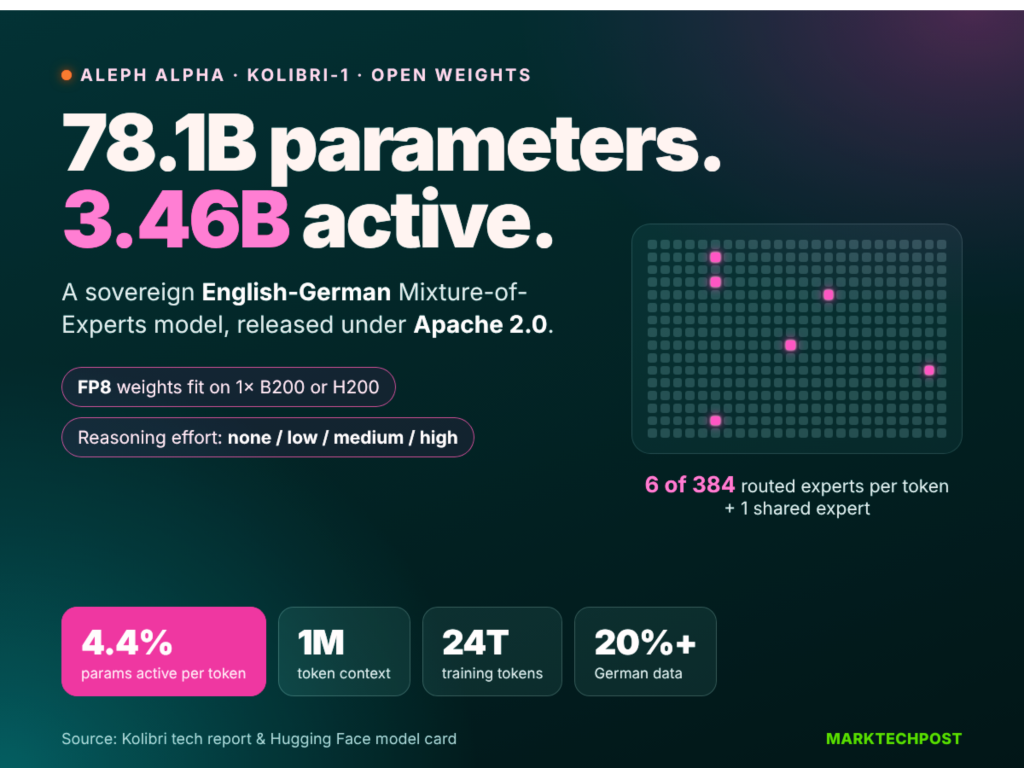
MarkTechPost가 2026년 10월 4일 보도한 바에 따르면, Aleph Alpha는 영어·독일어 이중 언어 오픈 웨이트 MoE 모델 Kolibri-1을 공개했다. 총 파라미터 781억 개, 토큰당 34.6억 개만 활성화되며, 최대 1,048,576 토큰 컨텍스트와 네 단계 추론 강도를 지원한다. Apache 2.0 라이선스로 Hugging Face에 공개되었고, FP8 체크포인트는 약 78GB이며 vLLM으로 단일 B200 또는 H200에서 서빙할 수 있다.
주요 변화
MarkTechPost가 2026년 10월 4일 보도한 바에 따르면, 독일 팀 Aleph Alpha는 오픈 웨이트 모델 Kolibri(Kolibri-1)를 공개했다. 영어와 독일어 이중 언어 혼합 전문가(MoE) 언어 모델로, 공공 행정·산업·항공우주 등 규제 분야의 주권적 배포를 목표로 한다. 보도에 따르면 총 파라미터는 781억 개이며 토큰당 34.6억 개(약 4.4%)만 활성화된다. 각 MoE 레이어는 시그모이드 라우터로 384개 라우팅 전문가 중 top 6을 선택하고, 여기에 공유 전문가 1개를 더한다. 로드 밸런싱은 Exact Quantile Balancing과 Load-Error Injection을 사용한다. 모델은 50개 Transformer 블록을 쌓았고 폭은 2560이며, 그룹 쿼리 어텐션은 48개 쿼리 헤드와 4개 KV 헤드를 사용한다. 다섯 번째 블록마다 위치 인코딩 없는 전체 어텐션이고, 나머지 40개 블록은 처음 512 토큰을 커버하는 슬라이딩 윈도우 어텐션에 RoPE를 결합해, KV 캐시는 10개 레이어만 컨텍스트에 따라 증가한다. 컨텍스트 상한은 1,048,576 토큰으로 보도되었고, 추론 강도는 요청별로 없음·낮음·중간·높음으로 설정할 수 있다. 학습 측면에서 보도에 따르면 사전 학습은 768개 NVIDIA B200에서 20T 토큰을 커버했고, 중간 학습은 3.44T 토큰(시퀀스 길이 65,536), 장문 컨텍스트 단계는 201B 토큰(시퀀스 길이 262,144)이며, 추가로 2T 이상의 독일어 토큰을 포함했다. 후속 학습은 지도 미세 조정과 120만 개 이상의 내부 태스크에 대한 강화 학습을 결합했다. 라이선스는 Apache 2.0이며 가중치는 Hugging Face에 공개되었다. FP8 체크포인트는 약 78GB로, 단일 B200, B300 또는 H200, 혹은 H100 SXM5 두 장에서 vLLM과 전용 추론 파서 및 도구 호출 파서를 통해 서비스할 수 있다. 보도된 벤치마크 비교에서 영어 종합 75.5, 독일어 종합 70.8을 기록했고, BFCL v4는 61.4로 비교 대상인 Qwen3.5보다 낮았다. 위 파라미터, 벤치마크, 배포 세부 사항은 모두 원 보도와 기술 보고서를 전한 것이며 아직 독립적으로 재현되지 않았다.
개발자에게 미치는 영향
개발자 관점에서 이 소식의 가치는 세 가지에 집중된다. 첫째는 라이선스와 자체 호스팅의 조합이다. 보도에 따르면 가중치는 Apache 2.0 라이선스로 공개되어, '오픈 웨이트지만 상업적 사용을 제한하는' 흔한 관행보다 더 명확한 권한 공간을 제공한다. 다만 라이선스 조항은 Hugging Face 모델 카드와 저장소 라이선스 원문에서 확인해야 하며, 보도 전달만으로 권리를 추론해서는 안 된다. 또한 가중치 사용 가능이 학습 데이터, 토크나이저, 추론 패키지에도 같은 라이선스가 적용된다는 뜻은 아니다. 둘째는 희소성이 만드는 비용 구조다. 총 파라미터 781억, 활성화 34.6억은 VRAM 점유가 총 파라미터 기준, 연산 비용이 활성화 파라미터 기준이라는 의미다. 보도에 따르면 FP8 체크포인트 약 78GB는 단일 B200/H200에서 실행 가능해, 이미 단일 카드 고용량 노드를 보유한 팀에게는 실현 가능한 자체 호스팅 출발점이다. 그러나 실제 처리량과 동시성은 VRAM 대역폭, KV 캐시 정밀도, 배치 크기에 달려 있으므로 자체 측정이 필요하다. 셋째는 혼합 어텐션과 백만 컨텍스트다. 슬라이딩 윈도우 레이어는 KV 캐시를 고정으로 유지하고 10개 레이어만 컨텍스트에 따라 증가하며, 팀은 동일 연산량에서 전체 어텐션 방식보다 4배 긴 시퀀스 길이를 지원할 수 있다고 주장한다. 사실이라면 장문 문서와 산업용 RAG의 컨텍스트 경제성이 같은 규모의 밀집 모델보다 확실히 우수해진다. 다만 이는 벤더 주장이므로 상한 숫자만 보지 말고 자체 문서 분포에서 유효 컨텍스트를 검증해야 한다. 또한 영어·독일어 이중 언어 포지셔닝과 독일어에 최적화된 토크나이저(보도에 따르면 독일어 토큰당 4.90바이트, 비교 토크나이저보다 약 11.2% 토큰을 적게 사용)는 강점 영역이 독일어임을 보여준다. 중국어 중심 업무라면 이를 근거로 중국어 능력을 추론해서는 안 되며, 보도에는 중국어 평가가 없다. 분명히 해둘 점은 다음과 같다. 이번 카탈로그 확인 시점 기준으로 Kolibri-1 버전은 KimiSeek의 실시간 모델 카탈로그에 없으므로, 보도된 가중치와 추론 서비스 가용성은 Aleph Alpha 및 Hugging Face 측 공개를 가리키며 이 사이트에 이미 올라왔다는 뜻이 아니다.
연동 및 평가 제안
다음은 권고와 조건부 분석이며 입증된 사실이 아니다. 권고 1: 먼저 라이선스와 컴플라이언스 전제로 결정하고, 그다음 성능을 결정하라. 실제 선택은 Hugging Face 저장소의 LICENSE 파일, 모델 카드의 용도 제한, aleph-alpha-inference 추론 패키지 자체의 라이선스를 확인한 뒤 프로덕션 의존성에 포함할지 결정하는 것이다. 업무 부하가 규제 데이터의 로컬 처리를 포함하고 팀이 단일 B200/H200급 VRAM 노드를 보유한 경우, 자체 호스팅이 외부 API 호출보다 가치 있다. 이 전제를 충족하지 못하면(예: 소비자용 카드나 중소 VRAM 카드 여러 장만 있는 경우) 정량적 기준으로 포기하라. 목표 하드웨어에서 FP8 체크포인트를 성공적으로 로드하고 안정적으로 출력하는 것을 통과 기준으로 삼고, 로드 실패나 예산 초과 VRAM 확장이 필요하면 다음 라운드로 가지 않는다. 권고 2: 전환 또는 도입 전에 자체 독일어 또는 영독 혼합 코퍼스로 기존 모델과 비교 평가를 하라. 선택할 수 있는 핵심 변수는 추론 강도 단계(없음/낮음/중간/높음)와 KV 캐시 정밀도이며, 이는 단일 요청 비용과 지연을 직접 바꾼다. 장문 문서 추출 작업이고 답변 지연 허용도가 높다면 추론 강도를 높여 품질 이득을 볼 수 있고, 고동시성 단문 질의응답이라면 낮은 강도와 긴 배치 처리가 더 유리하다. 평가 기준은 측정 가능해야 한다. 고정된 200~500개 독일어 장문 문서 질의응답 세트에서 각 단계의 정확도와 1,000 토큰당 종단 간 지연을 비교하고, 정확도 향상 폭이 지연과 비용 증가 폭을 넘을 때만 더 높은 단계를 채택하라. 권고 3: 장문 컨텍스트 능력은 상한이 아니라 '유효 창'으로 검증해야 한다. 실제 선택은 기본 262,144 컨텍스트로 먼저 출시하고, max-model-len 설정과 max_position_embeddings 재정의를 통해 점진적으로 더 큰 창으로 여는 것이다. 전제는 태스크가 실제로 백만 토큰을 넘는 연속 의존성을 필요로 하는 경우다. 검색 결과가 이미 10만 토큰보다 짧다면 상한을 여는 것은 KV 캐시 비용만 높인다. 정량적 기준은 길이 그라디언트(예: 32k, 128k, 512k)에서 핵심 정보 재현율을 측정하고, 특정 길이에서 뚜렷한 하락이 나타나면 그 길이 이하를 실질 상한으로 사용하는 것이다. 권고 4: 도구 호출과 에이전트 시나리오는 별도로 부하 테스트해야 한다. 보도에 따르면 BFCL v4 점수는 비교 대상 Qwen 모델보다 낮았고 에이전트 평균 점수는 경쟁 모델과 비슷해, 에이전트 하위 태스크별 격차가 클 수 있음을 시사한다. 실제 선택은 기존 모델을 도구 호출 주 경로로 유지하고 Kolibri를 독일어 검색과 생성에 쓰거나 그 반대로 하는 것이다. 전제는 팀이 회귀 가능한 도구 호출 테스트 세트를 이미 보유한 경우다. 정량적 기준은 자체 도구 스키마에서 호출 성공률과 파라미터 정확도이며, 현용 모델보다 현저히 낮으면 주 경로를 이전하지 말라.
제한과 확인할 사항
먼저 분명히 해야 한다. 이번 카탈로그 확인 시점 기준으로 Kolibri-1은 KimiSeek의 실시간 모델 카탈로그에 없다. 본문의 가중치, 추론 패키지, 배포 방식은 모두 Aleph Alpha 및 Hugging Face 공개를 가리키며 이 사이트가 해당 모델을 제공한다는 뜻이 아니다. 보도의 API 가용성 표현도 벤더 측에만 해당하며 본 사이트 서비스로 이해해서는 안 된다. 둘째, 본문의 모든 아키텍처, 학습, 벤치마크, 배포 수치는 MarkTechPost 2026년 10월 4일 보도와 그것이 전한 기술 보고서 및 모델 카드에서 나온 것이며 독립적으로 재현되지 않았다. 벤치마크 비교는 벤더가 자체 구축한 평가 구성이므로 모델 간 횡적 비교의 비교 가능성은 제한적이며, 선정의 유일한 근거가 되어서는 안 된다. 셋째, 보도는 중국어, 코드, 장문 컨텍스트 시나리오의 독립 검증 세부 사항을 제공하지 않았고 영독 이중 언어 포지셔닝 외의 언어 능력은 알 수 없다. '동일 연산량에서 4배 시퀀스 길이'라는 주장은 팀 진술이므로 직접 검증해야 한다. 넷째, Apache 2.0은 공개된 가중치에 대한 라이선스 선언이며, 구체적 적용 범위(가중치, 토크나이저, 추론 패키지, 학습 데이터)는 원 라이선스와 모델 카드를 항목별로 확인해야 한다. '오픈 웨이트'에서 모든 구성 요소의 권한 범위를 곧바로 추론할 수 없다. 다섯째, 단일 카드 실행 가능과 프로덕션 사용 가능은 다른 문제다. 최고 동시성, VRAM 여유, 추론 강도 단계가 비용에 미치는 영향은 목표 하드웨어에서 실측해야 한다. 여섯째, 보도의 가격, 상한, 권장 샘플링 파라미터는 모두 발표 시점 정보이며 이후 버전에서 바뀔 수 있으므로 벤더와 Hugging Face 페이지의 최신 내용을 기준으로 하라.