EmbeddingGemma 2 오픈 웨이트 공개: 7억 4천만 파라미터가 768차원 공간 공유, 코드·오디오 검색이 새 변수
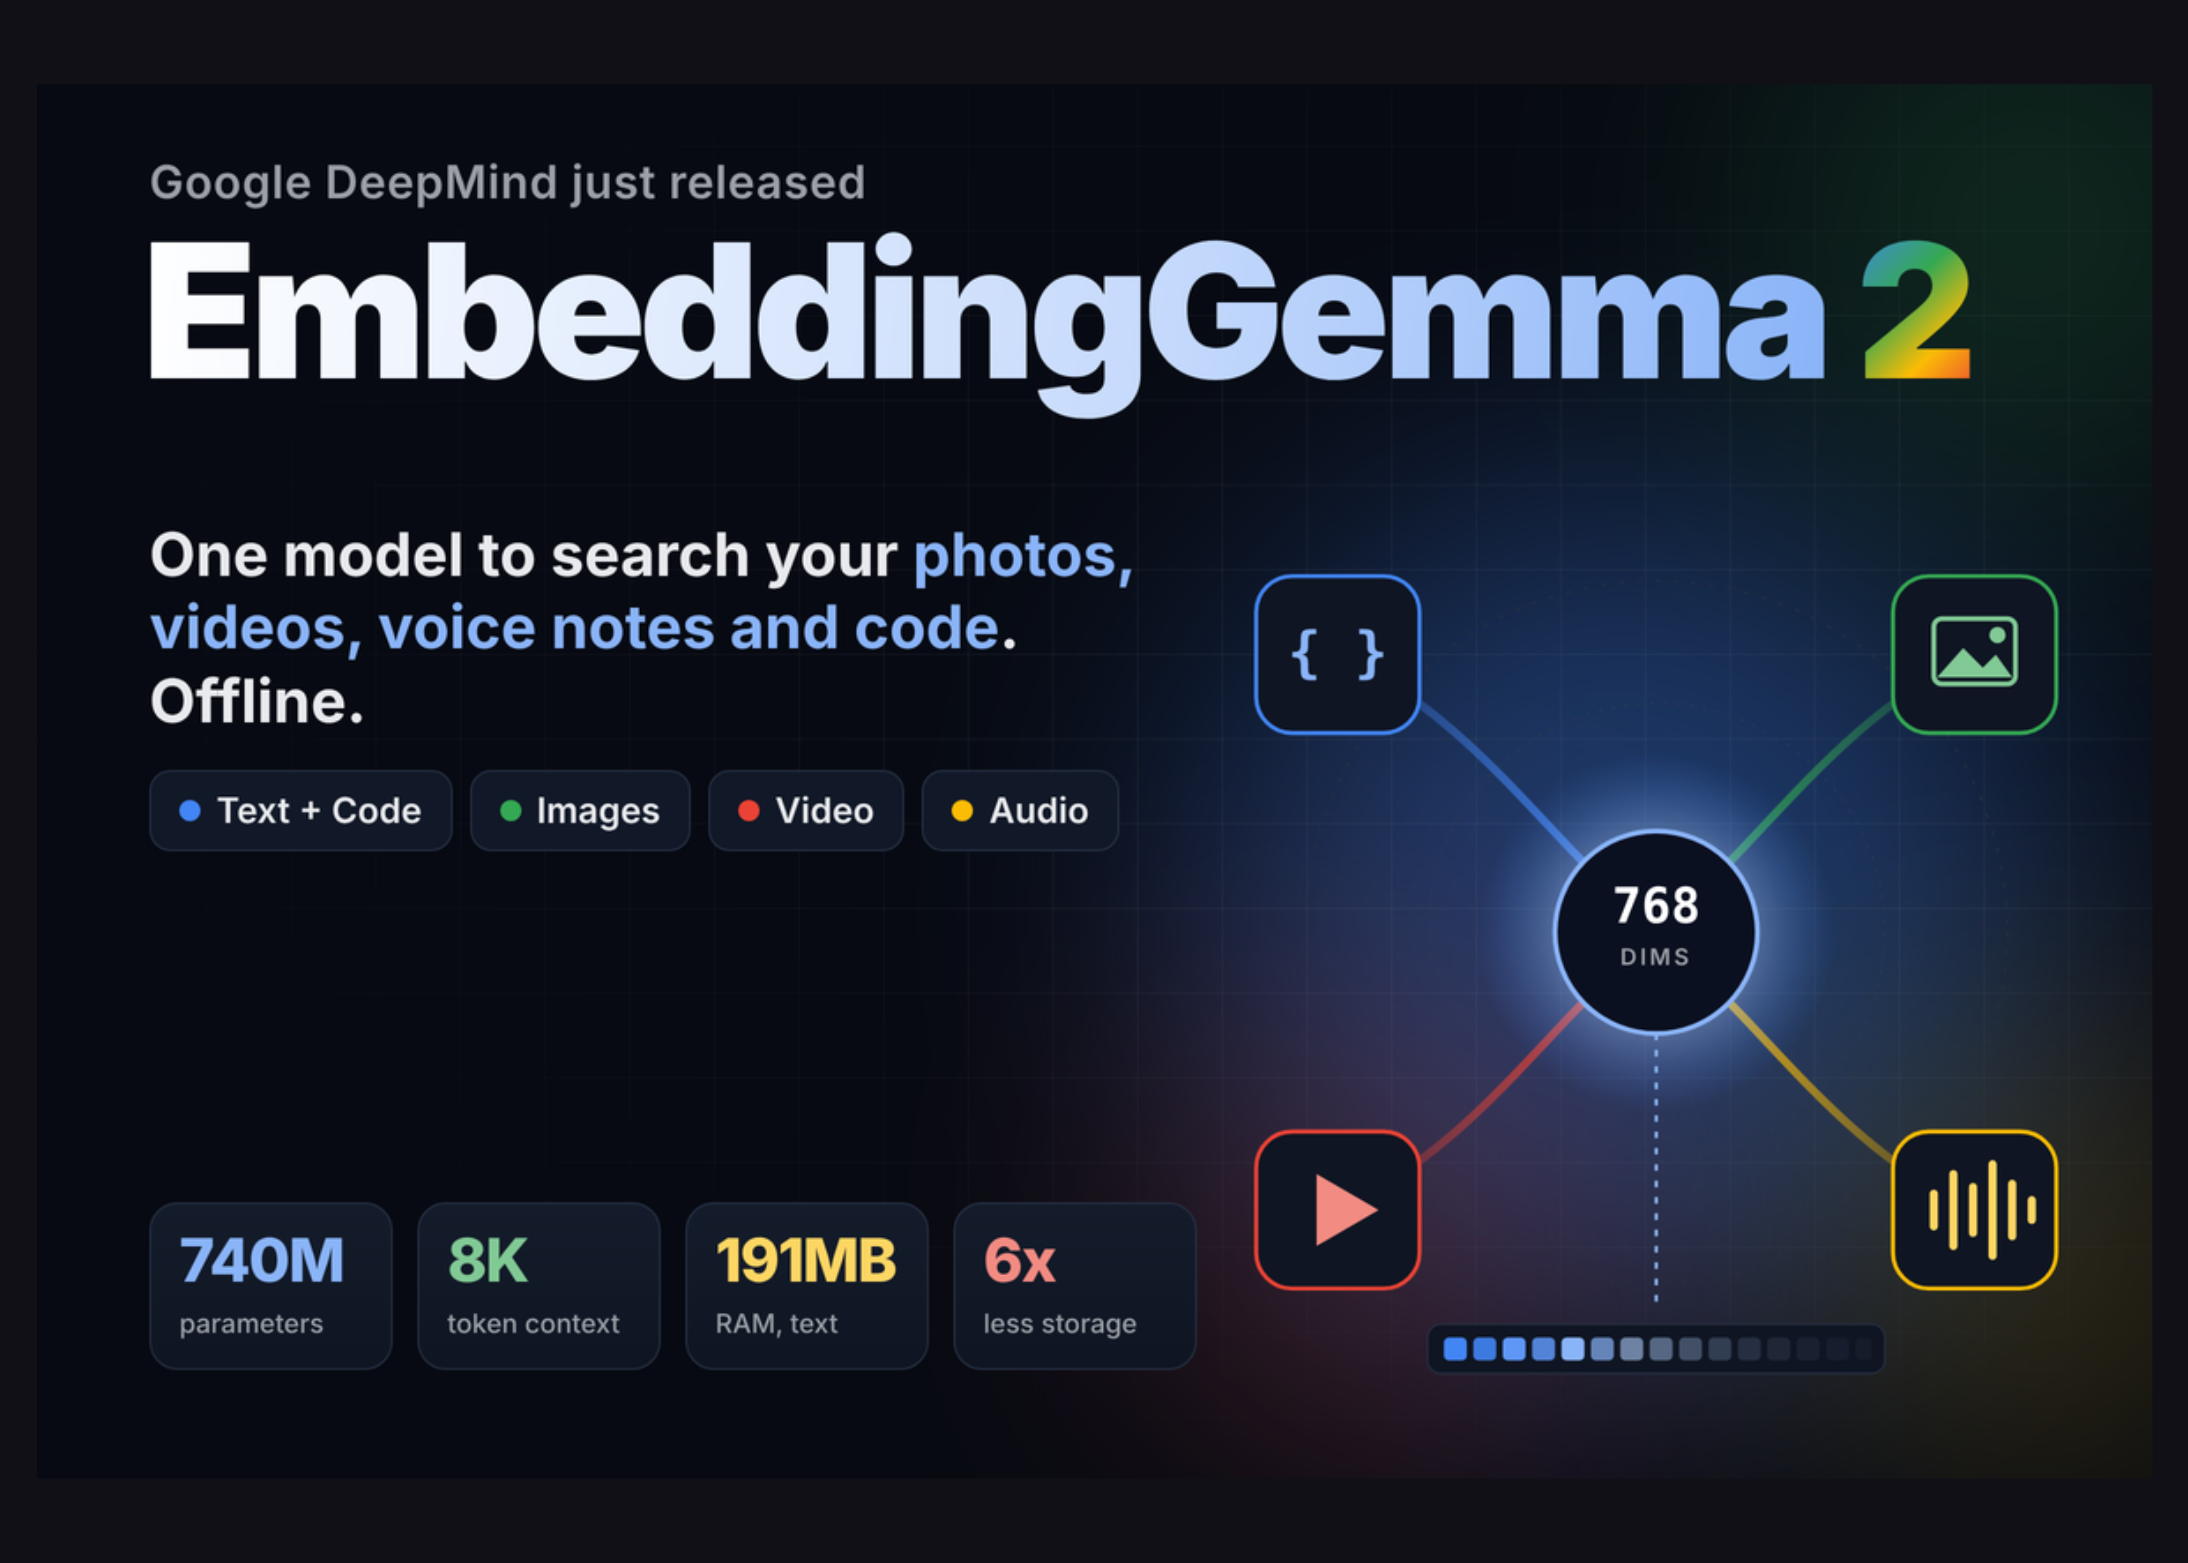
MarkTechPost가 2026년 10월 6일 보도한 바에 따르면, Google DeepMind는 7억 4천만 파라미터, 8K 컨텍스트, Apache 2.0 라이선스의 오픈 웨이트 멀티모달 임베딩 모델 EmbeddingGemma 2를 공개했으며, 텍스트, 코드, 이미지, 비디오, 오디오를 동일한 768차원 공간에 매핑한다. 텍스트 백본은 2억 7천만 파라미터로 단독 로드가 가능하다.
주요 변화
MarkTechPost가 2026년 10월 6일 보도한 바에 따르면, Google DeepMind는 Gemma 4 아키텍처 기반의 오픈 웨이트 멀티모달 임베딩 모델인 EmbeddingGemma 2를 Apache 2.0 라이선스로 공개했다. 이 모델은 모듈식 인코더로 서로 다른 모달리티를 동일한 768차원 벡터 공간에 매핑한다. 텍스트와 코드 백본은 약 2억 7천만 파라미터(1억 3천만 transformer + 1억 4천만 embedder), 비전 인코더는 1억 7천만 파라미터로 선택 사항, 오디오 인코더는 3억 파라미터로 선택 사항이며, 전부 로드하면 약 7억 4천만 파라미터가 되고 개발자는 필요한 부분만 로드할 수 있다. 컨텍스트 창은 8192 토큰으로, 보도에 따르면 1세대의 네 배이며 약 29장의 이미지, 58개 비디오 프레임 또는 5.5분 오디오를 담을 수 있다. 모델 카드에 따르면 MTEB Code v1은 이전 세대 68.76에서 78.68로, MTEB multilingual v2는 61.15에서 61.36으로 향상되었으며, MIEB lite 이미지 64.64, MMEB v2 총점 59.01, MAEB 오디오 49.39 등의 지표가 새로 추가되었다. 보도에 따르면 가중치는 Hugging Face와 Kaggle에 공개되었고 Ollama, llama.cpp GGUF, LiteRT, sentence-transformers v6.1.0+, vLLM, SGLang, MLX, LM Studio, MediaPipe 등 다양한 실행 방식을 제공하며, 벡터 저장은 Qdrant, 미세조정은 Unsloth가 지원한다. MRL은 벡터를 512, 256, 128차원으로 절단하는 것을 지원한다.
개발자에게 미치는 영향
개발자에게 이번 공개의 핵심 변화는 파라미터 수가 아니라 동일한 벡터 공간이 코드와 오디오를 동시에 포괄하고 텍스트 백본만 로드할 수 있다는 점이다. 이는 세 가지 선택 판단을 직접 바꾼다. 첫째, 멀티모달 RAG의 검색 계층은 과거에 텍스트와 이미지용 임베딩 모델 두 세트, 두 인덱스, 점수 정규화 로직이 필요한 경우가 많았다. 보도에 따르면 텍스트 전용 구성이 생성한 쿼리 벡터가 전체 모델이 생성한 문서 벡터와 매칭될 수 있으며, 이를 재현할 수 있다면 2억 7천만 파라미터 백본으로 먼저 인덱스를 구축하고 필요에 따라 비전이나 오디오 인코더를 추가하면서도 벡터 저장소를 재구축하지 않아도 된다는 의미다. 둘째, 코드 검색 벤치마크의 향상 폭(보도 기준 약 9.92점, 약 14%)으로 코드베이스 시맨틱 검색 시나리오의 후보 목록에 들어가지만, 이는 벤더 모델 카드 수치이지 자체 저장소에서의 성능과 같지 않다. 셋째, 알리의 Qwen3-VL-Embedding-2B와 서로 다른 트레이드오프를 형성한다. 보도에 따르면 후자는 자체 MMEB v2 테스트에서 73.2점을 보고했고 파라미터 수는 약 2.7배이며 오디오를 지원하지 않는 반면, EmbeddingGemma 2는 8K 컨텍스트, 온디바이스 메모리, 오디오 지원을 강조한다. 오픈 웨이트가 제약 없는 오픈 소스 라이선스와 같지 않다는 점에 유의해야 한다. Apache 2.0은 관대한 라이선스이지만 모델 보고서의 학습 데이터 출처와 다운스트림 컴플라이언스 요건은 직접 확인해야 한다. 또한 KimiSeek의 현재 모델 카탈로그에는 EmbeddingGemma 2라는 항목이 없으며, 이 버전은 현재 KimiSeek에 등록되어 있지 않다. 보도에서 언급된 가용성은 Hugging Face, Kaggle, Ollama 등 외부 채널을 가리키며, 향후 API 형태로 제공되더라도 해당 공급자 페이지를 기준으로 삼아야 한다.
연동 및 평가 제안
다음은 권장 사항과 조건 분석이며 보도된 사실이 아니다. 권장 1: 먼저 크로스모달 검색이 필요한지 판단하라. 중국어 텍스트와 코드만 있고 이미 성숙한 텍스트 임베딩 모델을 사용 중이라면 EmbeddingGemma 2를 즉시 교체 대상이 아니라 A/B 후보로 두고, 동일한 자체 쿼리와 문서 세트로 검색 실험을 먼저 수행하며 평가 지표는 MTEB 점수만 보지 말고 Recall@10과 nDCG@10을 사용하라. 워크로드에 실제로 이미지-텍스트 혼합이나 음성 메모 검색이 포함된다면 공유 벡터 공간 가설을 우선 검증할 가치가 있다. 2억 7천만 텍스트 백본으로 벡터 저장소를 구축한 뒤 전체 모델로 동일한 이미지-텍스트 문서를 임베딩하여 구성 간 유사도 일관성을 측정하고, 관련성 순위가 뚜렷하게 흔들리면 구성별로 인덱스를 따로 구축해야 한다. 권장 2: 차원과 저장의 트레이드오프. 보도에 따르면 256차원에서 MTEB multilingual은 61.36에서 60.41로만 소폭 하락했지만, 128차원에서는 MMEB가 45.65로 떨어지며 공식 권장은 128차원을 주로 순수 텍스트에 사용하는 것이다. 병목이 벡터 저장소 비용이고 시나리오가 순수 텍스트라면 먼저 256차원으로 전환해 검증하고, 이미지나 비디오 검색이 포함된다면 768차원을 유지하며 자체 데이터에서 256차원과 768차원의 리콜 차이를 비교해 허용 가능한 리콜 손실 임계값을 정한 뒤 결정하라. 권장 3: 배포 스택의 종속 위험. 실행 가능한 스택이 많으므로 선택 시 서버 측인지 온디바이스 측 목표인지를 기준으로 하고, 벡터 차원, 프롬프트 템플릿(보도의 SearchQuery와 Document 프롬프트 이름) 및 양자화 방식을 함께 설정에 기록하며 고정 회귀 세트로 양자화 전후에 각각 한 번씩 실행해 리콜 차이를 비교하라. 평가에는 반드시 기업 자체 데이터를 사용하고 공개 리더보드를 쓰지 말아야 한다. 보도에서 다국어 품질은 기본적으로 비슷한 수준이며 향상은 코드와 새로 추가된 모달리티에 집중되어 있기 때문이다.
제한과 확인할 사항
위 벤치마크, 메모리 사용량 및 지연 수치는 모두 Google 모델 카드나 연구팀 자체 보고에서 나온 것으로 벤더 보고이며 독립적인 제3자 재현은 없다. 온디바이스 191MB와 567MB는 특정 기기(Pixel 11 Pro)에서 양자화 후의 활성 메모리로, 다른 하드웨어에 그대로 외삽할 수 없다. 보도에서는 학습 데이터 구성과 언어 분포 세부 사항을 공개하지 않았으므로 중국어 시나리오의 실제 성능은 직접 검증해야 한다. 크로스 모델 비교에서 Qwen3-VL-Embedding-2B의 73.2점은 자체 MMEB v2 자체 보고 기준이며, 일부 비교와 서로 다른 리더보드의 점수는 직접적으로 가로 비교할 수 없다. 또한 EmbeddingGemma 2 버전은 현재 KimiSeek의 모델 카탈로그에 나타나지 않으므로 이 글은 이를 KimiSeek에서 사용 가능한 모델로 간주하지 않는다. 보도에서 언급된 가중치 공개, Ollama 풀 및 각종 런타임 지원은 모두 외부 채널의 공급자 또는 커뮤니티 배포를 가리키며, 관련 가용성과 향후 가격은 해당 플랫폼의 공식 페이지를 기준으로 확인해야 한다. 보도는 Android용 ML Kit 지원이 몇 주 내 출시될 것이라고 언급했는데, 이는 계획이지 기정사실이 아니므로 이에 근거해 일정을 잡아서는 안 된다.
원문 보도의 이미지