JetBrains, Apache 2.0 기반 Mellum2.1 공개: 12B MoE 코딩 에이전트 모델과 양자화 버전 제공
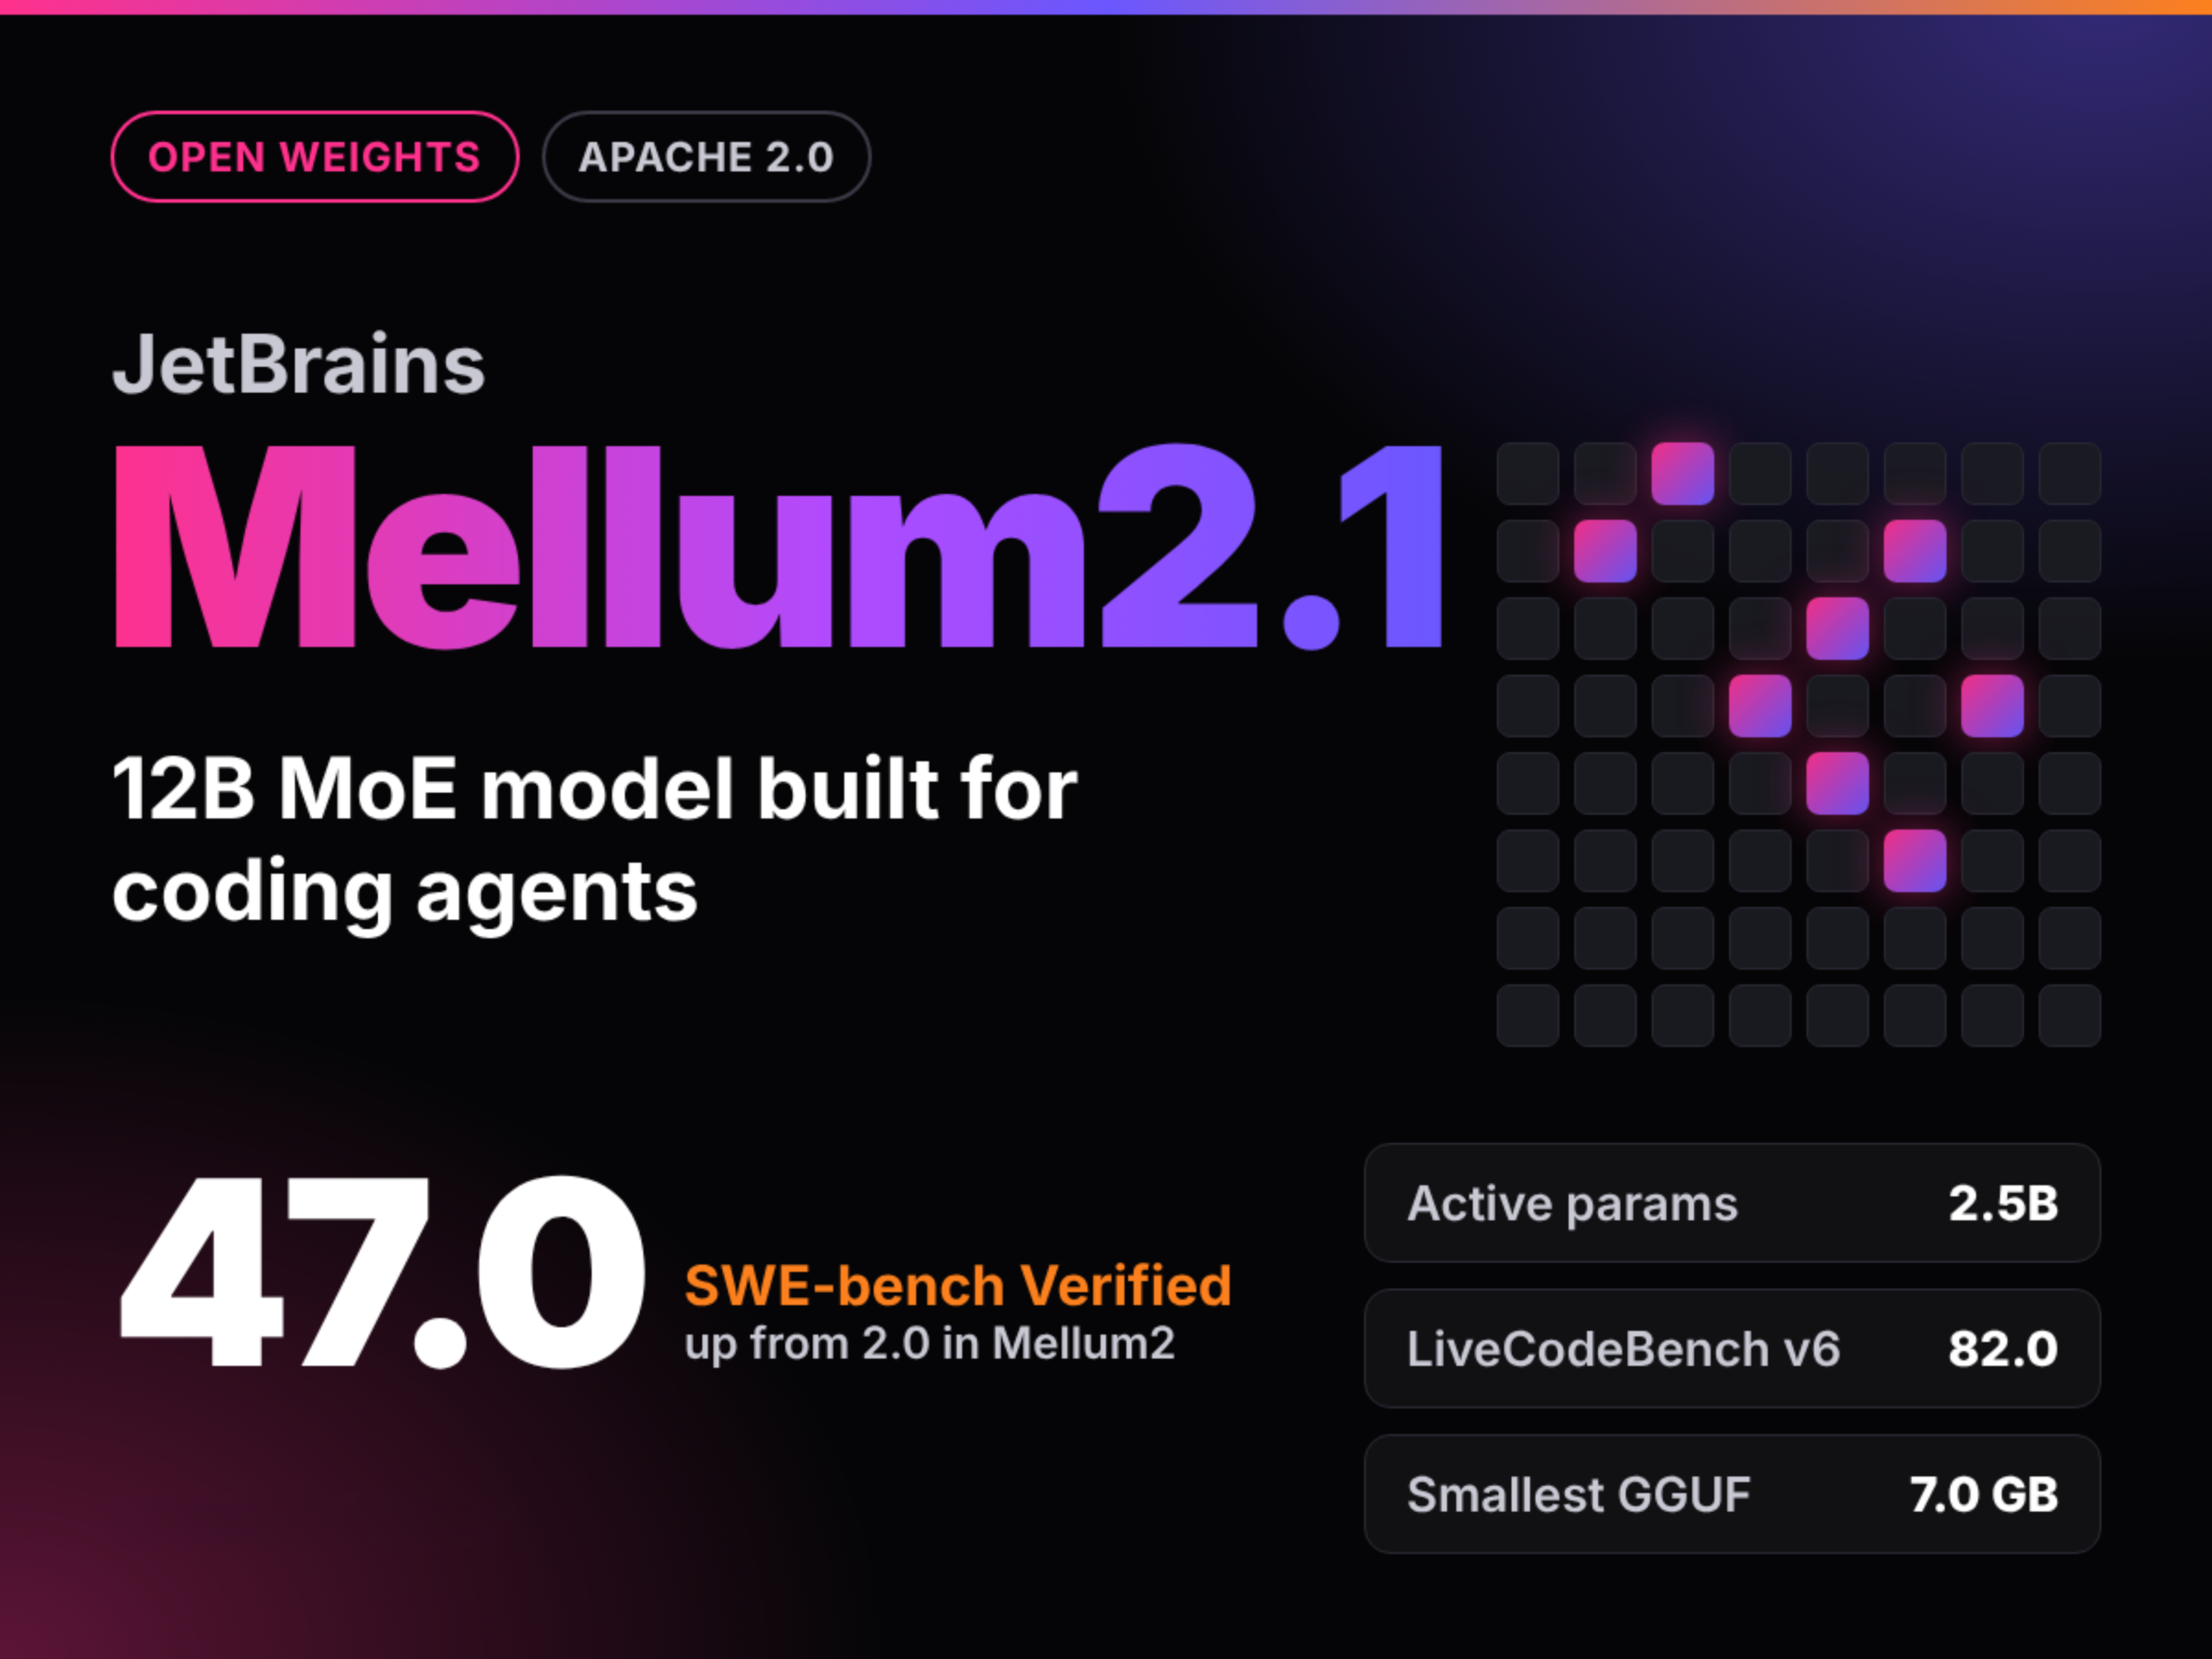
MarkTechPost가 2026년 10월 8일 보도한 바에 따르면, JetBrains는 Apache 2.0 라이선스로 Mellum2.1, 즉 Mellum2.1-12B-A2.5B-Thinking을 공개했다. 이는 총 12B 파라미터, 토큰당 2.5B 활성화의 MoE 사고형 모델로, 아키텍처는 이전 세대와 동일하며 개선은 주로 실제 코드 저장소에서의 강화학습에서 비롯되었다. 보도에 따르면 SWE-bench Verified는 2.0에서 47.0으로 상승했다.
주요 변화
MarkTechPost가 2026년 10월 8일 보도한 바에 따르면, JetBrains는 Mellum2.1을 공개했으며 체크포인트 이름은 Mellum2.1-12B-A2.5B-Thinking이고 Apache 2.0 라이선스로 Hugging Face에 가중치를 배포했다. 이는 총 12B 파라미터, 토큰당 2.5B 파라미터가 활성화되는 전문가 혼합(MoE) 추론 모델로, 28개 층, 64개 전문가, 토큰당 8개 전문가 활성화, GQA(32개 쿼리 헤드, 4개 KV 헤드)를 채택했으며, 4개 층 중 3개 층이 1024 토큰 슬라이딩 윈도우를 사용하고, 컨텍스트는 131072 토큰, 어휘는 98304개, 가중치는 bfloat16이다. 보도에 따르면 아키텍처는 2026년 6월 오픈소스로 공개된 Mellum2 Thinking과 비교해 변하지 않았고, 업그레이드는 거의 전부 후속 학습에서 비롯되었다: RL이 학습의 주된 방식이 되었고 수학, 경쟁 프로그래밍, 과학, 도구 호출 및 소프트웨어 엔지니어링 작업이 추가되었으며, 실제 코드 저장소에서 셸 및 파일 편집 도구로 학습하고 테스트 통과 시 보상을 주었다. 보도에 따르면 JetBrains 자체 테스트에서 SWE-bench Verified는 2.0에서 47.0으로, SWE-bench Pro는 0.0에서 28.0으로, Terminal-Bench 2.1은 0.6에서 17.4로 상승했고, LiveCodeBench v6는 82.0, BFCL v4는 62.3이었으며, HarmBench는 21.5에서 8.5로 하락했다. Qwen3.5-9B는 SWE-bench Verified(50.0), SWE-bench Pro(38.0), GPQA Diamond(77.8), AIME 25/26(86.7)에서 여전히 앞선다.
개발자에게 미치는 영향
이번 발표가 자체 호스팅 코딩 에이전트에 갖는 의미는 세 가지로 집약되며, 모두 독립적 재현이 아닌 보도 내용에 근거한다. 첫째, 모델은 Apache 2.0 라이선스로 가중치를 공개한, 라이선스가 명확한 오픈 웨이트 배포이며 단순히 다운로드 가능한 가중치가 아니다. 그러나 보도에 나온 모든 벤치마크 점수는 JetBrains가 자체 보고한 것이며, Qwen 공식 모델 카드는 동일 모델에 대해 LiveCodeBench v6와 GPQA Diamond 수치가 JetBrains의 평가 절차와 뚜렷하게 다르다고 제시한다. 이는 점수가 평가 프레임워크에 민감하다는 뜻으로, 제조사 간 비교 가능한 결론으로 곧바로 받아들일 수 없다. 둘째, 2.5B 활성화 파라미터에 131072 토큰 컨텍스트와 GGUF 양자화를 더하면 소비자용 또는 단일 GPU 환경에서 로컬 하위 에이전트의 실행 가능성이 생긴다. 보도는 BF16 24.3 GB, Q8_0 12.9 GB, Q4_K_M 8.1 GB(첫 토큰 일치율 88.0%), MXFP4_MOE 7.0 GB(85.6%) 등의 버전을 나열한다. 개발자가 주목할 점은 단일 파일 크기가 아니라 양자화 후 능력 저하가 자신의 작업 허용 범위 안에 드는지 여부다. 셋째, 보도에 따르면 단일 H200 고부하에서 처리량이 Qwen3.5-9B의 약 두 배에 근접하고, MTP는 단일 요청 시나리오에서 약 1.6배 가속을 제공하지만, vLLM 추측 디코딩에 사용되는 MTP 헤드는 출시 예정으로 표시되어 있어 현재 배포에서는 이 가속을 직접 활용할 수 없다. 코딩 에이전트를 사용하는 팀에게 이것은 범용 추론 주력 대체품이라기보다 저비용 실행 단위의 후보에 가깝다. 보고서는 Terminal-Bench 2.1과 지식형 벤치마크에서 뒤처진다고 보여주기 때문이다.
연동 및 평가 제안
전체 스택 교체보다 작업별 계층 검증을 권한다. 결정 1: 워크로드가 고동시성, 짧은 단계의 코드 완성이나 하위 에이전트 실행 단위라면 12B/2.5B 활성화 MoE 배포를 우선 평가할 수 있다. 전제는 단일 GPU 이상의 VRAM과 vLLM 또는 SGLang 환경이며, 보도가 제시한 기동 방식은 vLLM에 --reasoning-parser qwen3를 붙이고 도구 호출에는 --enable-auto-tool-choice --tool-call-parser hermes를 추가하는 것이다. 샘플링 파라미터는 temperature 0.6, top_p 0.95, top_k 20을 권장한다. 측정 지표는 동일 하드웨어에서 토큰당 처리량과 단위 작업 비용이어야 하며 벤치마크 점수만 볼 것이 아니다. 결정 2: 워크로드가 긴 체인의 저장소 수준 수정이라면 먼저 자체 저장소로 소규모 대조 실험을 하고 Qwen3.5-9B 같은 모델과 작업 통과율 및 실패 모드를 비교할 것을 권한다. 보도가 자체 보고한 SWE-bench Verified 47.0은 Qwen3.5-9B의 50.0보다 낮고 Terminal-Bench 2.1 격차는 더 뚜렷하기 때문이다. 여기서 조건은 기업이 자동 판정 가능한 테스트 세트를 이미 보유한 경우다. 측정 지표는 엔드투엔드 작업 통과율과 평균 단계 수다. 결정 3: 로컬 또는 오프라인 시나리오에서는 Q4_K_M과 MXFP4_MOE 양자화 버전을 먼저 시험할 수 있다. 전제는 작업이 첫 토큰 동작 편차에 민감하지 않은 경우다. 측정 지표는 양자화 버전과 BF16 참조 버전이 자체 프롬프트 세트에서 보이는 첫 토큰 일치율과 실제 정확도 격차다. 또한 보도가 설명하는 사용 가능성은 공급자가 배포한 가중치와 추론 프레임워크 지원을 뜻하며, 연동 방식은 각 프레임워크 문서를 기준으로 해야 한다.
제한과 확인할 사항
핵심 제한을 명확히 해야 한다: Mellum2.1은 KimiSeek의 실시간 모델 카탈로그에 나타나지 않으며, 해당 버전은 현재 KimiSeek에 등록되어 있지 않다. 보도에서 언급된 가중치, GGUF, vLLM/SGLang 배포 방식은 모두 JetBrains 측 발표를 가리키며 이 사이트에서의 사용 가능성을 의미하지 않는다. 모든 성능 수치는 JetBrains의 자체 보고 또는 그 통일된 평가 절차에서 나온 것으로, SWE-bench, Terminal-Bench, LiveCodeBench, BFCL을 포함하며 독립적으로 재현되지 않았다. 보도 자체가 Qwen 공식 모델 카드와 JetBrains 평가가 동일 모델에 대해 서로 다른 수치를 제시한다고 지적하므로, 횡적 비교 결론은 신중해야 한다. 양자화 버전의 첫 토큰 일치율이 작업 정확도와 같지는 않으며, 보도에 나온 GGUF 목록과 "GGUF가 아직 제작 중"이라는 설명 사이에는 차이가 있어 실제 사용 가능한 파일과 품질은 직접 확인해야 한다. MTP 헤드는 출시 예정으로 표시되어 있어 vLLM 추측 디코딩 가속은 현재 사용할 수 없다. 또한 구체적 호출 가격과 과금 방식은 공급자 가격 페이지를 기준으로 해야 하며, 이 글은 구체적 수치를 인용하지 않는다.