지장윈지, GLM-5.3용 추측 디코딩 기법 Alaya-DFlash2 공개...32k 컨텍스트 디코딩 3.41배 향상 주장
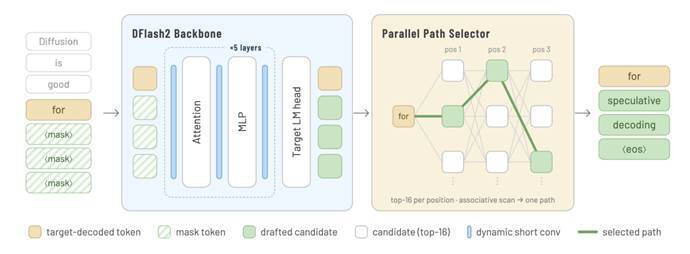
InfoQ가 2026년 10월 20일 보도한 바에 따르면, 지장윈지는 GLM-5.3을 대상으로 한 추측 디코딩 가속 기법 Alaya-DFlash2를 발표했다. 이 기법은 병렬 초안 작성이 가능한 드래프트 모델과 경로 선택 메커니즘으로 구성되며, 가중치가 공개되었다. 제조사 자체 평가에 따르면 8×H200, TP=8 환경에서 단일 동시성 디코딩 속도가 네이티브 자기회귀 방식의 3.41배에 달하며, 1k부터 32k까지의 저엔트로피 컨텍스트에서 수용 길이가 두 비교 기법보다 모두 높았다. 이러한 수치와 비교는 모두 제조사 자체 평가 결과로, 제3자 재현이 아직 이루어지지 않았다.
주요 변화
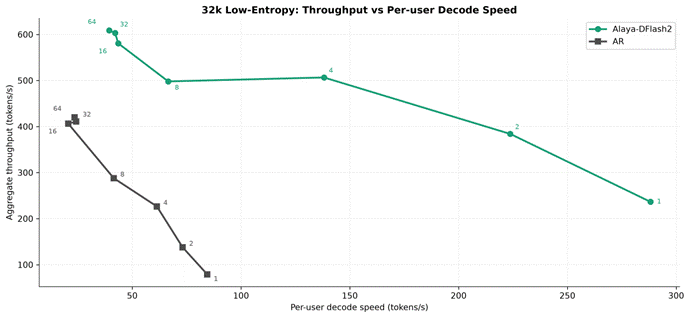
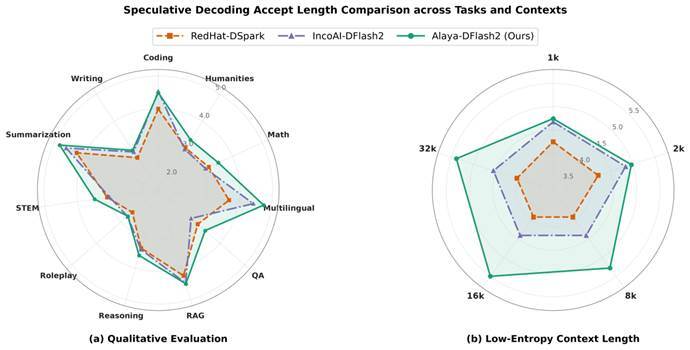
InfoQ가 2026년 10월 20일 보도한 바에 따르면, 지장윈지는 GLM-5.3을 대상으로 한 추측 디코딩 가속 기법 Alaya-DFlash2를 출시했다. 이 기법은 병렬 초안 작성이 가능한 드래프트 모델과 경로 선택 메커니즘으로 구성되며, 가중치는 AlayaNeW/GLM-5.3-DFlash2라는 이름으로 공개되었다. 보도에서는 구체적인 오픈소스 라이선스 조항을 밝히지 않았다. 보도에 따르면 이 기법은 지장윈지의 AlayaNeW 지능형 컴퓨팅 엔진을 기반으로 GLM-5.3에 맞춰 드래프트 모델을 훈련한 것이다. 평가 측면에서 보도는 8×H200, TP=8 환경의 데이터를 제시했다. 단일 동시성 디코딩 속도는 약 288.2 tokens/s로, 네이티브 자기회귀 방식의 약 84.5 tokens/s 대비 3.41배였다. 이에 대응하는 총 출력 처리량은 78.95에서 236.47 tokens/s로 증가했다. 동시성이 높아지면 우위는 좁아져, 4 동시성 처리량은 네이티브 자기회귀 방식의 2.24배였고, 64 동시성 처리량은 608.71 tokens/s로 네이티브 자기회귀 방식의 420.13 tokens/s 대비 44.9% 향상되었다. 보도는 또한 저엔트로피 컨텍스트 수용 길이도 제시했는데, 1k, 2k, 8k, 16k, 32k에서 각각 4.74, 4.97, 5.28, 5.50, 5.39로, 평가에 참여한 IncoAI-DFlash2와 RedHat-DSpark보다 모두 높았다. 또한 11개 작업 유형 중 9개 유형에서 수용 길이가 앞섰으며, 코드와 역할극 두 유형에서는 IncoAI-DFlash2와 비슷한 수준이라고 밝혔다.
개발자에게 미치는 영향
추측 디코딩이 개발자에게 실질적으로 중요한 이유는 모델 자체의 능력이 아니라 동일한 하드웨어에서 생성 비용 구조를 바꾼다는 점이다. 보도 기준으로 장문 컨텍스트 시나리오에서 드래프트 수용 길이가 약 5 수준을 유지한다는 것은, 메인 모델의 한 번의 전방 패스로 약 5개의 후보 토큰을 검증하고 통과시킬 수 있음을 의미한다. 이는 메인 모델이 반복적으로 디코딩하는 횟수를 줄여, 첫 토큰 이후의 지속 출력 대기 시간을 직접 압축한다. GLM-5.3 추론 서비스를 직접 구축한 팀에게 이는 메인 모델을 교체하지 않고 출력 분포를 바꾸지 않으면서 디코딩 처리량을 얻는 것과 같다. 대신 드래프트 모델 가중치를 추가로 로드해야 하고 이에 따른 VRAM과 스케줄링 오버헤드가 발생한다. 보도는 동시성에 따라 이득이 달라진다는 점도 보여준다. 단일 동시성에서 속도 향상이 가장 크고, 64 동시성에서는 총 처리량 향상이 44.9%로 좁아진다. 이는 이 기법의 이득이 주로 저동시성 대화형 시나리오에서 나타나며, 고동시성 서비스에서는 단위 처리량 증가가 상대적으로 제한적임을 시사한다. 모든 수치는 제조사 자체 측정에서 나온 것이며, 테스트 환경은 TP=8, 8×H200으로 고정되어 있고, 수용 길이는 구체적인 데이터 분포에 의존하므로 저엔트로피 컨텍스트 이외의 분포에서는 다르게 나타날 수 있다는 점에 유의해야 한다. 가중치 공개가 라이선스 조항의 명확성을 의미하지는 않으므로, 상업적 사용 전에는 저장소의 라이선스 정보를 확인해야 한다.
연동 및 평가 제안
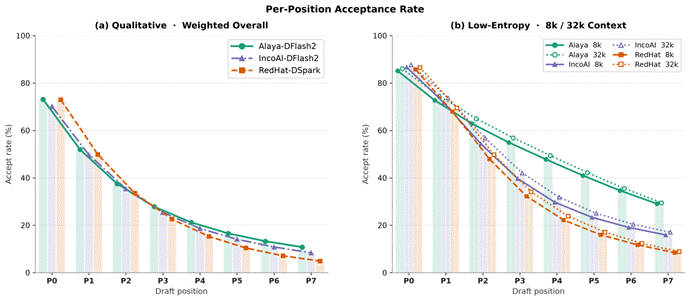
평가 결론을 그대로 따르기보다 다음 조건에 따라 판단할 것을 권한다. 첫 번째 결정은 이 드래프트 모델을 도입할지 여부다. 추론 부하가 장문 문서 질의응답, RAG 요약 등 장문 컨텍스트와 저~중간 동시성을 중심으로 한다면, 보도에서 제시한 16k~32k 수용 길이가 5를 넘는다는 데이터는 실제 트래픽과의 대조 테스트를 한 번 해볼 근거가 된다. 부하가 고동시성 단문 요청 중심이라면, 보도에서 64 동시성 처리량이 44.9%만 향상되었다는 점을 고려해 드래프트 모델이 초래하는 추가 VRAM 점유와 스케줄링 비용이 그만한 가치가 있는지 먼저 계산해야 한다. 평가 기준은 다음과 같이 설정할 수 있다. 자체 32k 길이 샘플에서 실측 수용 길이와 토큰 간 지연을 측정하고, 수용 길이가 보도 수준보다 현저히 낮거나 VRAM 증가로 인해 동시성 상한이 떨어진다면 도입하지 않는다. 두 번째 결정은 드래프트 위치 수와 검증 배치 구성이다. 보도에 따르면 드래프트 후반부의 수용률도 여전히 상당하다(32k에서 5번째 위치 49.43%, 8번째 위치 29.51%). 이는 검증 깊이를 기본값보다 더 깊게 설정할 근거가 된다. 그러나 이 이득이 성립하려면 백엔드 수용률이 자체 데이터에서도 유지되어야 한다. 코드, 역할극 등 보도에서 앞서지 못한 작업 유형에서 수용률이 빠르게 감소한다면, 드래프트 길이를 늘리는 것은 연산력만 낭비할 뿐이다. 평가 기준은 다음과 같이 설정할 수 있다. 위치별 통과율을 집계해 수용률이 설정한 임계값 아래로 떨어지는 위치를 찾아 그에 따라 드래프트 길이를 자른다. 위 내용은 모두 보도 데이터에 기반한 조건부 제안이며, 제조사가 제시한 배포 결론이 아니다.
제한과 확인할 사항
보도의 모든 성능 데이터는 지장윈지 자체 측정에서 나온 것으로, 제3자 재현이 제공되지 않았고 테스트 데이터셋, 프롬프트 템플릿, 디코딩 파라미터도 공개되지 않았다. 수용 길이는 데이터 분포에 크게 의존하므로 자체 트래픽에서는 재현되지 않을 수 있다. 평가 환경은 8×H200, TP=8로 고정되어 있으며, 다른 하드웨어와 병렬 구성에서의 성능은 알 수 없다. 보도에서 말하는 오픈소스는 가중치 주소만 제공할 뿐 라이선스 유형을 밝히지 않았다. 가중치 사용 가능이 임의의 상업적 사용이나 재배포를 허용하는 라이선스 조항을 의미하지는 않으며, 저장소 선언을 기준으로 해야 한다. 또한 Alaya-DFlash2는 GLM-5.3을 위한 독립적인 드래프트 모델 기법으로, 메인 모델 자체와는 별개다. GLM-5.3은 KimiSeek의 현재 카탈로그에 해당 항목이 있지만, Alaya-DFlash2라는 가속 기법 자체는 호출 가능한 모델로 KimiSeek에 등록되어 있지 않으며, 관련 가용성은 제조사와 가중치 저장소를 기준으로 해야 한다.
원문 보도의 이미지