Nemotron 3.5 Super VL, SageMaker JumpStart에 출시: 모델은 100만 컨텍스트 주장, 엔드포인트는 15,600까지만
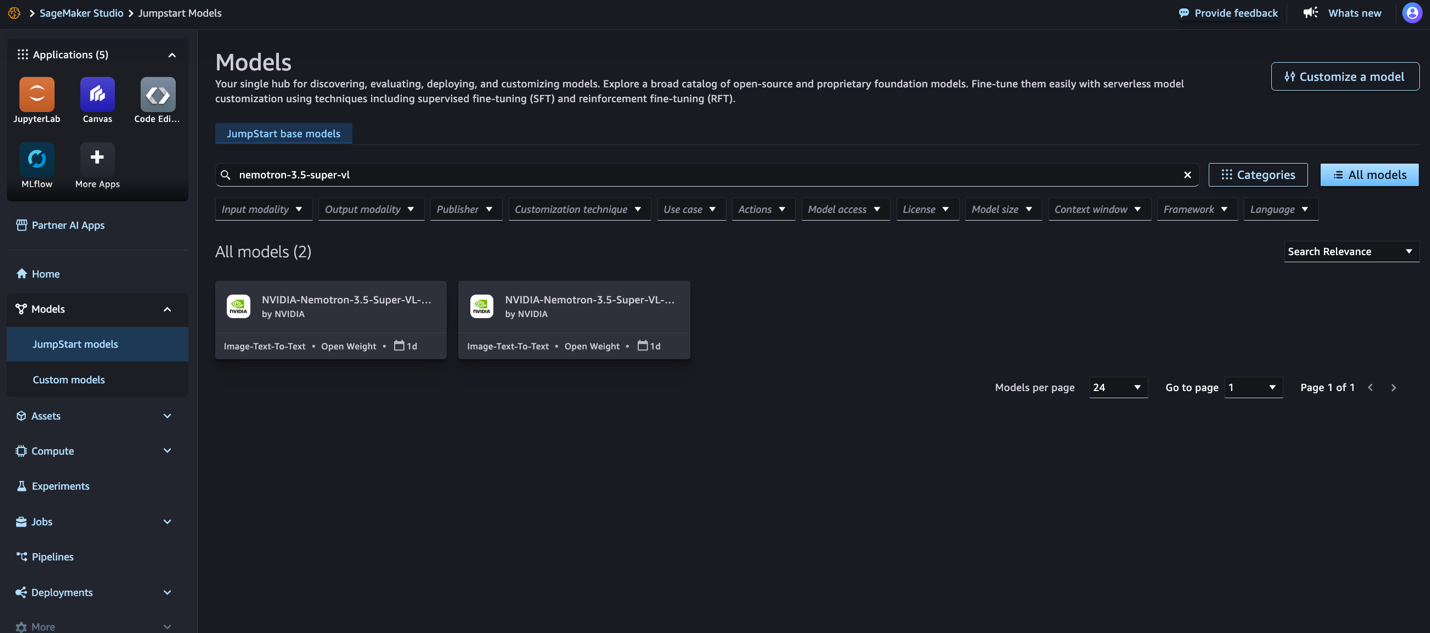
AWS는 11월 9일 블로그에서 엔비디아 Nemotron 3.5 Super VL이 SageMaker JumpStart에 출시되어 NVFP4와 BF16 두 가지 변형을 제공한다고 발표했습니다. 총 120B 파라미터, 12B 활성화이며 가중치는 OpenMDW 1.1 라이선스로 제공되지만, 호스팅 엔드포인트의 서비스 구성은 컨텍스트를 520~15,600토큰으로 제한합니다.
주요 변화
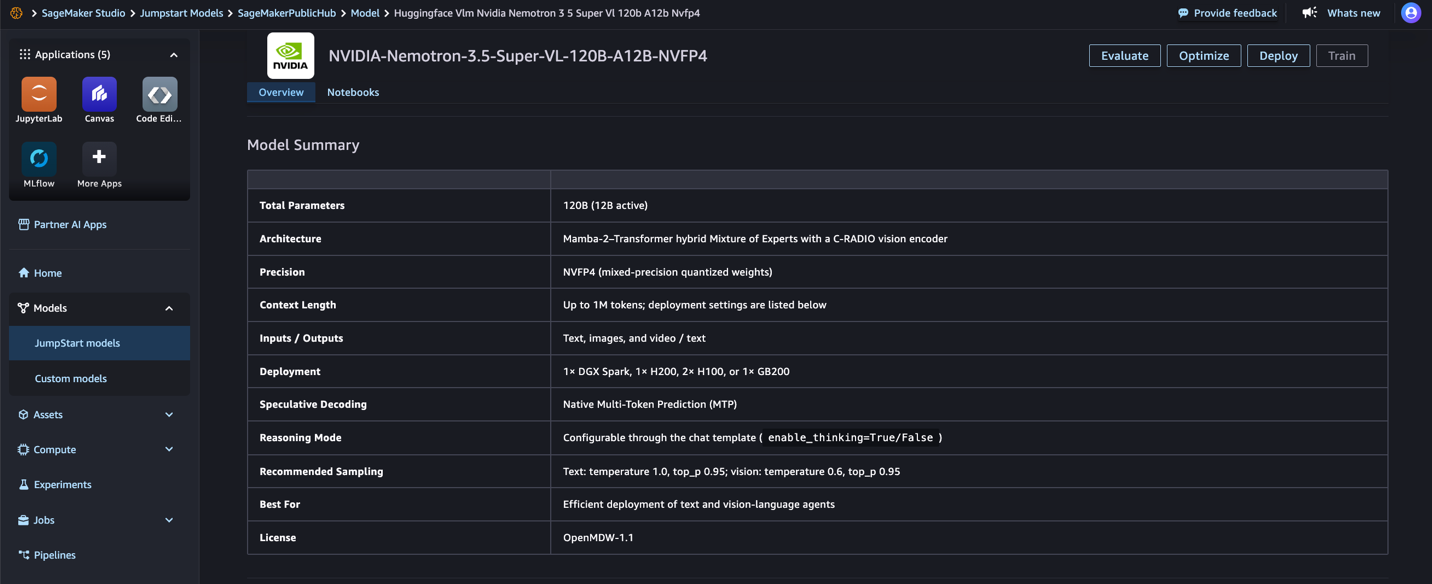
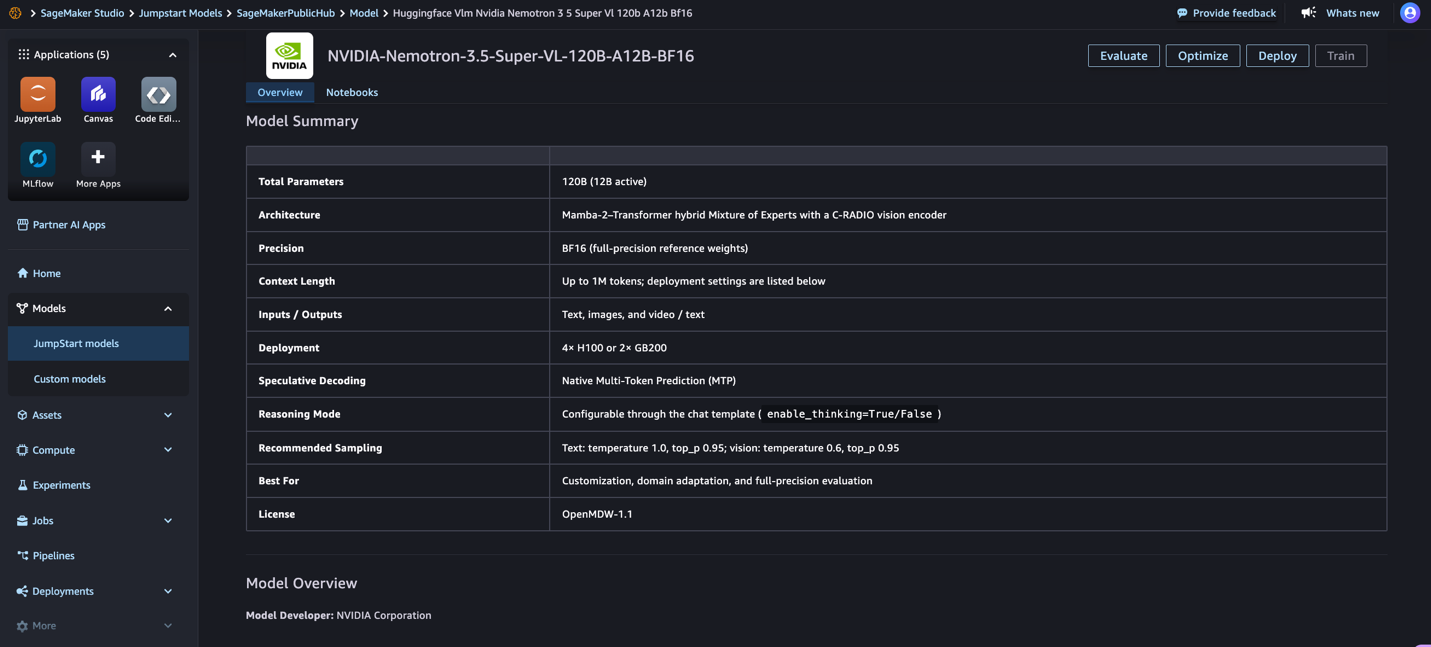
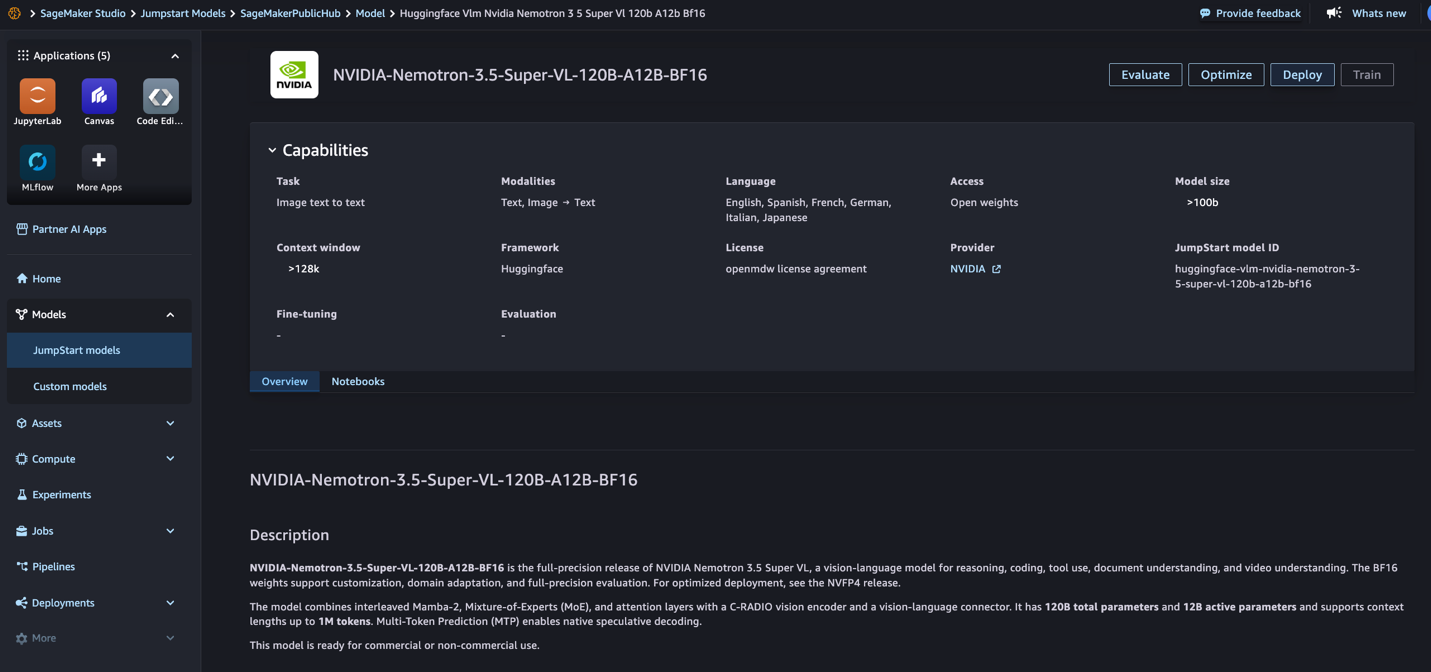
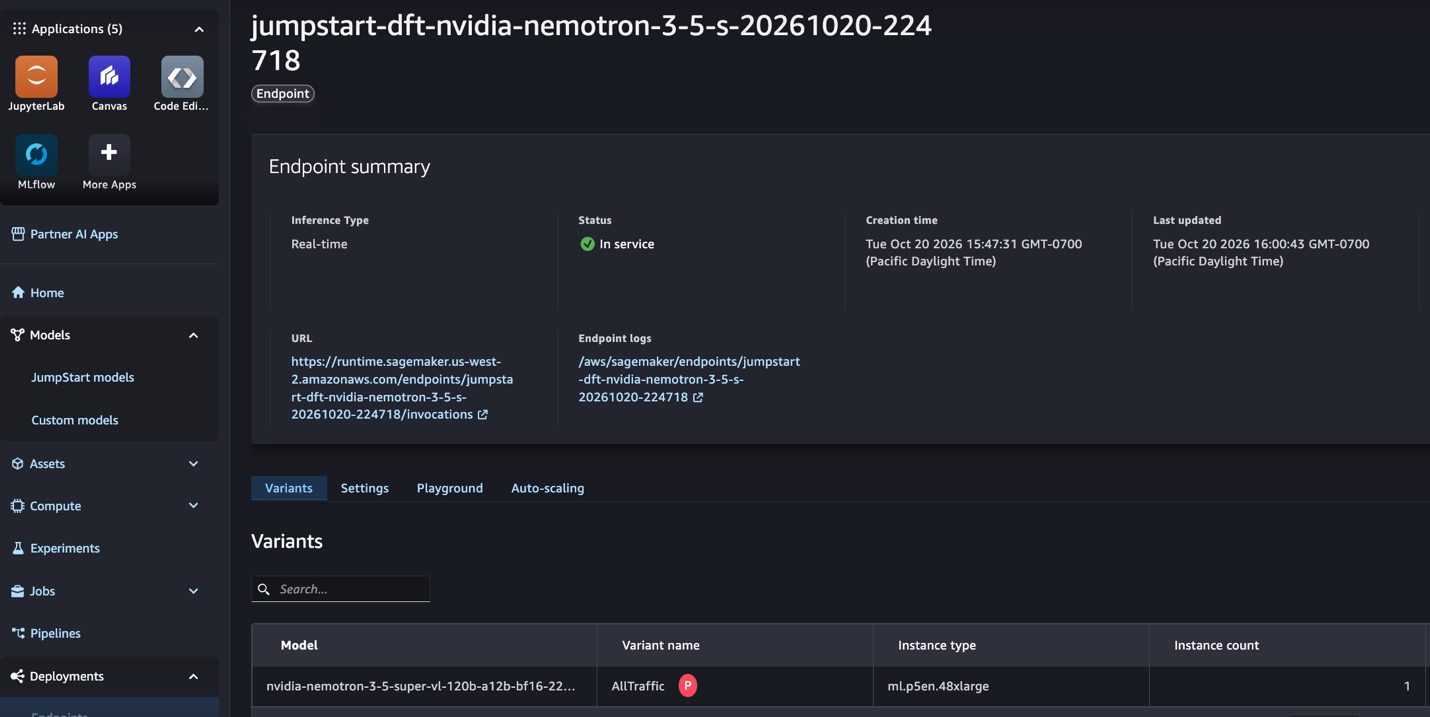
AWS가 2026년 11월 9일 게시한 블로그(Venu Kanamatareddy, Evan Kravitz, Naidile Murali 작성)에 따르면, 엔비디아 Nemotron 3.5 Super VL이 Amazon SageMaker JumpStart에 출시되었습니다. 블로그 설명에 따르면 이 모델은 Nemotron 3.5 시리즈의 비전 언어 모델로, 이미지, 비디오, 텍스트 입력을 받아 텍스트를 출력합니다. 언어 백본은 총 120B 파라미터에 토큰당 12B가 활성화됩니다. 88개 층에 Mamba-2와 MoE(512개 라우팅 전문가, 토큰당 22개 활성화)가 교차로 쌓이고 8개 어텐션 층이 끼어 있으며, 백본은 Nemotron 3 Super Base에서 초기화되고 Nemotron 3 Ultra Base에서 증류되었습니다. 비전 측은 C-RADIO 인코더를 사용합니다. JumpStart는 두 가지 변형을 제공합니다. NVFP4는 BF16에서 양자화 인식 증류로 얻어지며 약 75GB로, RTX PRO 4500 Blackwell이 탑재된 G7 인스턴스에서 4비트 가중치와 활성화로 실행됩니다. BF16은 전체 정밀도 참조 가중치로 약 249GB이며, ml.p5en.48xlarge의 H200 8장에서 실행됩니다. 가중치는 OpenMDW 라이선스 계약 1.1로 제공되며 영어, 프랑스어, 독일어, 이탈리아어, 일본어, 스페인어, 중국어를 지원합니다. 블로그는 모델이 최대 100만 토큰 컨텍스트를 지원한다고 밝히지만, JumpStart의 서비스 구성은 520~15,600토큰까지만 열려 있습니다. 체크포인트에는 다중 토큰 예측 헤드가 포함되어 있으나 JumpStart 서비스 구성에서는 투기적 디코딩이 활성화되지 않으며, 엔드포인트도 LoRA 어댑터를 로드하지 않습니다.
개발자에게 미치는 영향
개발자에게 미치는 첫 번째 영향은 인터페이스 형태입니다. 블로그 설명에 따르면 JumpStart 엔드포인트는 vLLM 기반 chat completions 인터페이스를 노출하며, 추론이 기본으로 켜져 있고 사고 내용은 메시지의 reasoning 필드에 담겨 content와 분리되어 반환됩니다. 따라서 content 필드 하나만 파싱하는 기존 클라이언트는 수정해야 하며, 그렇지 않으면 본문을 잃거나 추론 과정을 본문으로 착각하게 됩니다. 미디어는 base64 data URL로 인라인 전송해야 합니다. 엔드포인트가 네트워크 격리되어 URL을 가져올 수 없기 때문이며, 이는 요청 본문 크기를 크게 늘리고 “링크를 주면 모델이 직접 다운로드”하는 방식이 바로 무효화됩니다. 두 번째 영향은 용량 계획입니다. 모델 카드에는 최대 100만 토큰 컨텍스트가 적혀 있지만, 호스팅 엔드포인트의 서비스 구성은 실제로 520~15,600토큰만 제공하며 요청당 이미지 한 장과 비디오 한 개만 받습니다. 1,536×1,024 페이지 이미지는 약 1,536토큰을 소비하며, 블로그도 모델이 원본 PDF가 아닌 이미지를 받는다고 분명히 밝히므로 먼저 각 페이지를 이미지로 렌더링해야 합니다. 이에 비추어 보면 수십 페이지짜리 PDF는 이 호스팅 경로에서 한 번에 보낼 수 없고, 페이지별로 요청하거나 여러 페이지를 한 이미지로 합쳐 컨텍스트 예산을 압축해야 합니다. 세 번째 영향은 지연 예측입니다. 블로그의 측정에 따르면 generate 구성(입력 250토큰, 출력 1,500토큰, 동시 스트리밍 5개)에서 G7의 NVFP4는 요청당 약 63토큰/초, 첫 토큰 약 0.45초입니다. 그러나 같은 g7.24xlarge가 summarize 구성, 입력 10,000토큰에서는 첫 토큰이 12.62초가 됩니다. 이미지와 비디오 요청은 보통 긴 프롬프트 쪽에 속하므로, 대화형 GUI 에이전트로 쓰기 전에 이 첫 토큰 규모를 먼저 측정해 볼 가치가 있습니다. 품질 측면에서 블로그는 NVIDIA 모델 카드의 다중 모달 벤치마크 다섯 항목(추론 켜짐)을 인용합니다. MMLongBench-Doc 62.82 대 62.82, OCRBench v2 영어 68.12 대 68.34, CharXiv reasoning 80.82 대 79.88, Video-MME v2 32.85 대 32.54, OSWorld-Verified 51.14 대 52.30이며 앞쪽이 BF16, 뒤쪽이 NVFP4입니다. 블로그는 평가 설정이 동일하고 체크포인트만 다르다고 밝힙니다. 이는 제조사 자체 보고 수치이며 제3자 재현은 확인되지 않았습니다.
연동 및 평가 제안
다음 세 가지는 보도된 사실에 기반한 조건부 제안이며 검증된 결론이 아닙니다. 첫째, 변형을 먼저 정하십시오. 보도된 변화는 JumpStart가 NVFP4와 BF16 두 체크포인트를 동시에 제공하며, NVFP4가 기본이고 ml.g7.24xlarge에서 시작하며 BF16은 ml.p5en.48xlarge에서만 제공된다는 점입니다. 선택은 이렇습니다. 순수 추론 서비스는 NVFP4를 먼저 쓰고, SFT, 강화학습, 증류, 도메인 적응, 사용자 정의 양자화를 할 때만 BF16 참조 가중치를 내려받아 자체 구축하십시오. 이 선택을 바꾸는 핵심 전제는 미세조정 요구입니다. 블로그는 엔드포인트가 기본 가중치만 제공하고 LoRA 어댑터를 로드하지 않는다고 분명히 밝히므로, LoRA 핫스왑에 의존하는 방안이라면 호스팅 경로는 바로 성립하지 않습니다. 측정 가능한 판단 기준은 자체 문서 스크린샷과 비디오 클립을 같은 입력 배치로 두 체크포인트에서 돌려 작업 정확도와 JSON 출력 준수율의 차이를 비교하고, 허용 가능한 차이를 기존 수동 검수율에 대응하는 오류 수준 이내로 정하는 것입니다. 둘째, 컨텍스트보다 서비스 구성을 먼저 정하십시오. 보도된 변화는 inference_config_name이 모델 길이를 결정한다는 점입니다. generate 2,275, interact 520, summarize 13,650, modify 15,600토큰이며, 블로그의 이미지, 비디오, 추론 예시는 모두 modify를 씁니다. 선택은 이렇습니다. 이미지, 비디오 또는 다단계 추론이 포함된 요청에는 modify를, 짧은 텍스트 추출에는 generate를 쓰고, “페이지 한 장당 약 1,536토큰”으로 요청당 몇 페이지까지 처리할 수 있는지 추정하십시오. 전제는 다중 페이지 문서를 반드시 여러 요청으로 나누거나 한 이미지로 합쳐야 한다는 것입니다. 측정 가능한 판단 기준은 출시 전 길이 초과 거부율과 p95 첫 토큰 시간을 한 번 집계하고, 입력 10,000토큰에서 12.62초라는 참조값을 지연 예산의 하한 대조로 삼는 것입니다. 셋째, 추론 스위치를 먼저 정하십시오. 보도된 변화는 추론이 기본으로 켜져 있고 사고 내용이 별도로 반환되며, 추론을 쓰는 비디오 요청은 max_tokens를 최소 8,192로 설정하도록 권장된다는 점입니다. 선택은 이렇습니다. 티켓 필드 추출, 이미지 설명처럼 짧고 직접적인 응답이 필요한 작업은 enable_thinking=False로 끄고, 다단계 분석과 GUI 위치 지정은 유지하십시오. 선택을 바꾸는 전제는 작업이 실제로 중간 단계를 필요로 하는지입니다. 측정 가능한 판단 기준은 같은 샘플 배치에서 켜기와 끄기의 필드 추출 정확도, 출력 토큰 수, 종단 간 지연을 비교하여 절약한 토큰이 수용 가능한 정확도 손실을 상쇄하는지 보는 것입니다. 배포 전에는 ml.g7 쿼터(신규 계정은 초기 0)와 SageMaker Python SDK 3.25 이상을 확인하고 인스턴스 유형을 명시적으로 전달해야 합니다. 그렇지 않으면 SDK가 ml.m5.large로 폴백하여 빌드가 실패합니다.
제한과 확인할 사항
Nemotron 3.5 Super VL 이 버전은 현재 KimiSeek 모델 카탈로그에 없습니다. 보도된 가용성은 AWS SageMaker JumpStart, 즉 제조사 측 호스팅 서비스를 뜻하며 이 사이트에 출시된 모델이 아닙니다. 나머지 미지수도 남겨야 합니다. 위에 인용한 다섯 벤치마크는 NVIDIA 모델 카드에서 온 제조사 자체 보고 기준입니다. 블로그 자체가 NVFP4와 BF16의 성능 수치는 서로 다른 GPU 시스템과 구성에서 측정된 것이며 격리된 정밀도 비교가 아니라고 밝히므로, 63토큰/초와 140.85토큰/초로 양자화 손실을 직접 추론할 수 없습니다. 모델 카드가 주장하는 100만 토큰 컨텍스트는 호스팅 엔드포인트에서 노출되지 않으며 실제 상한은 서비스 구성에 달려 있습니다. 비디오 프레임 샘플링은 엔드포인트 시작 시 고정되고, 엔드포인트는 요청별 media_io_kwargs 전달도 거부하므로 요청별로 샘플링을 제어하려면 자체 구축해야 합니다. 가중치는 OpenMDW 라이선스 계약 1.1로 제공되며, 개방형 가중치는 오픈소스 라이선스와 같지 않으므로 상업적 사용, 재배포, 파생 모델 조항은 라이선스 원문을 읽어야 합니다. 원문에는 가격이 없으며 비용은 선택한 인스턴스에 따라 청구되므로 구체적인 내용은 AWS SageMaker 가격 페이지를 기준으로 하십시오. 중국어가 지원 언어 목록에 포함되어 있지만 원문에는 중국어 시나리오의 벤치마크 데이터가 없습니다.
원문 보도의 이미지