엔비디아 Nemotron 3.5 Bolt E4B 공개: 4GB VRAM 겨냥한 로컬 에이전트, 도구 호출 벤치마크서 Qwen3.5-4B에 뒤져
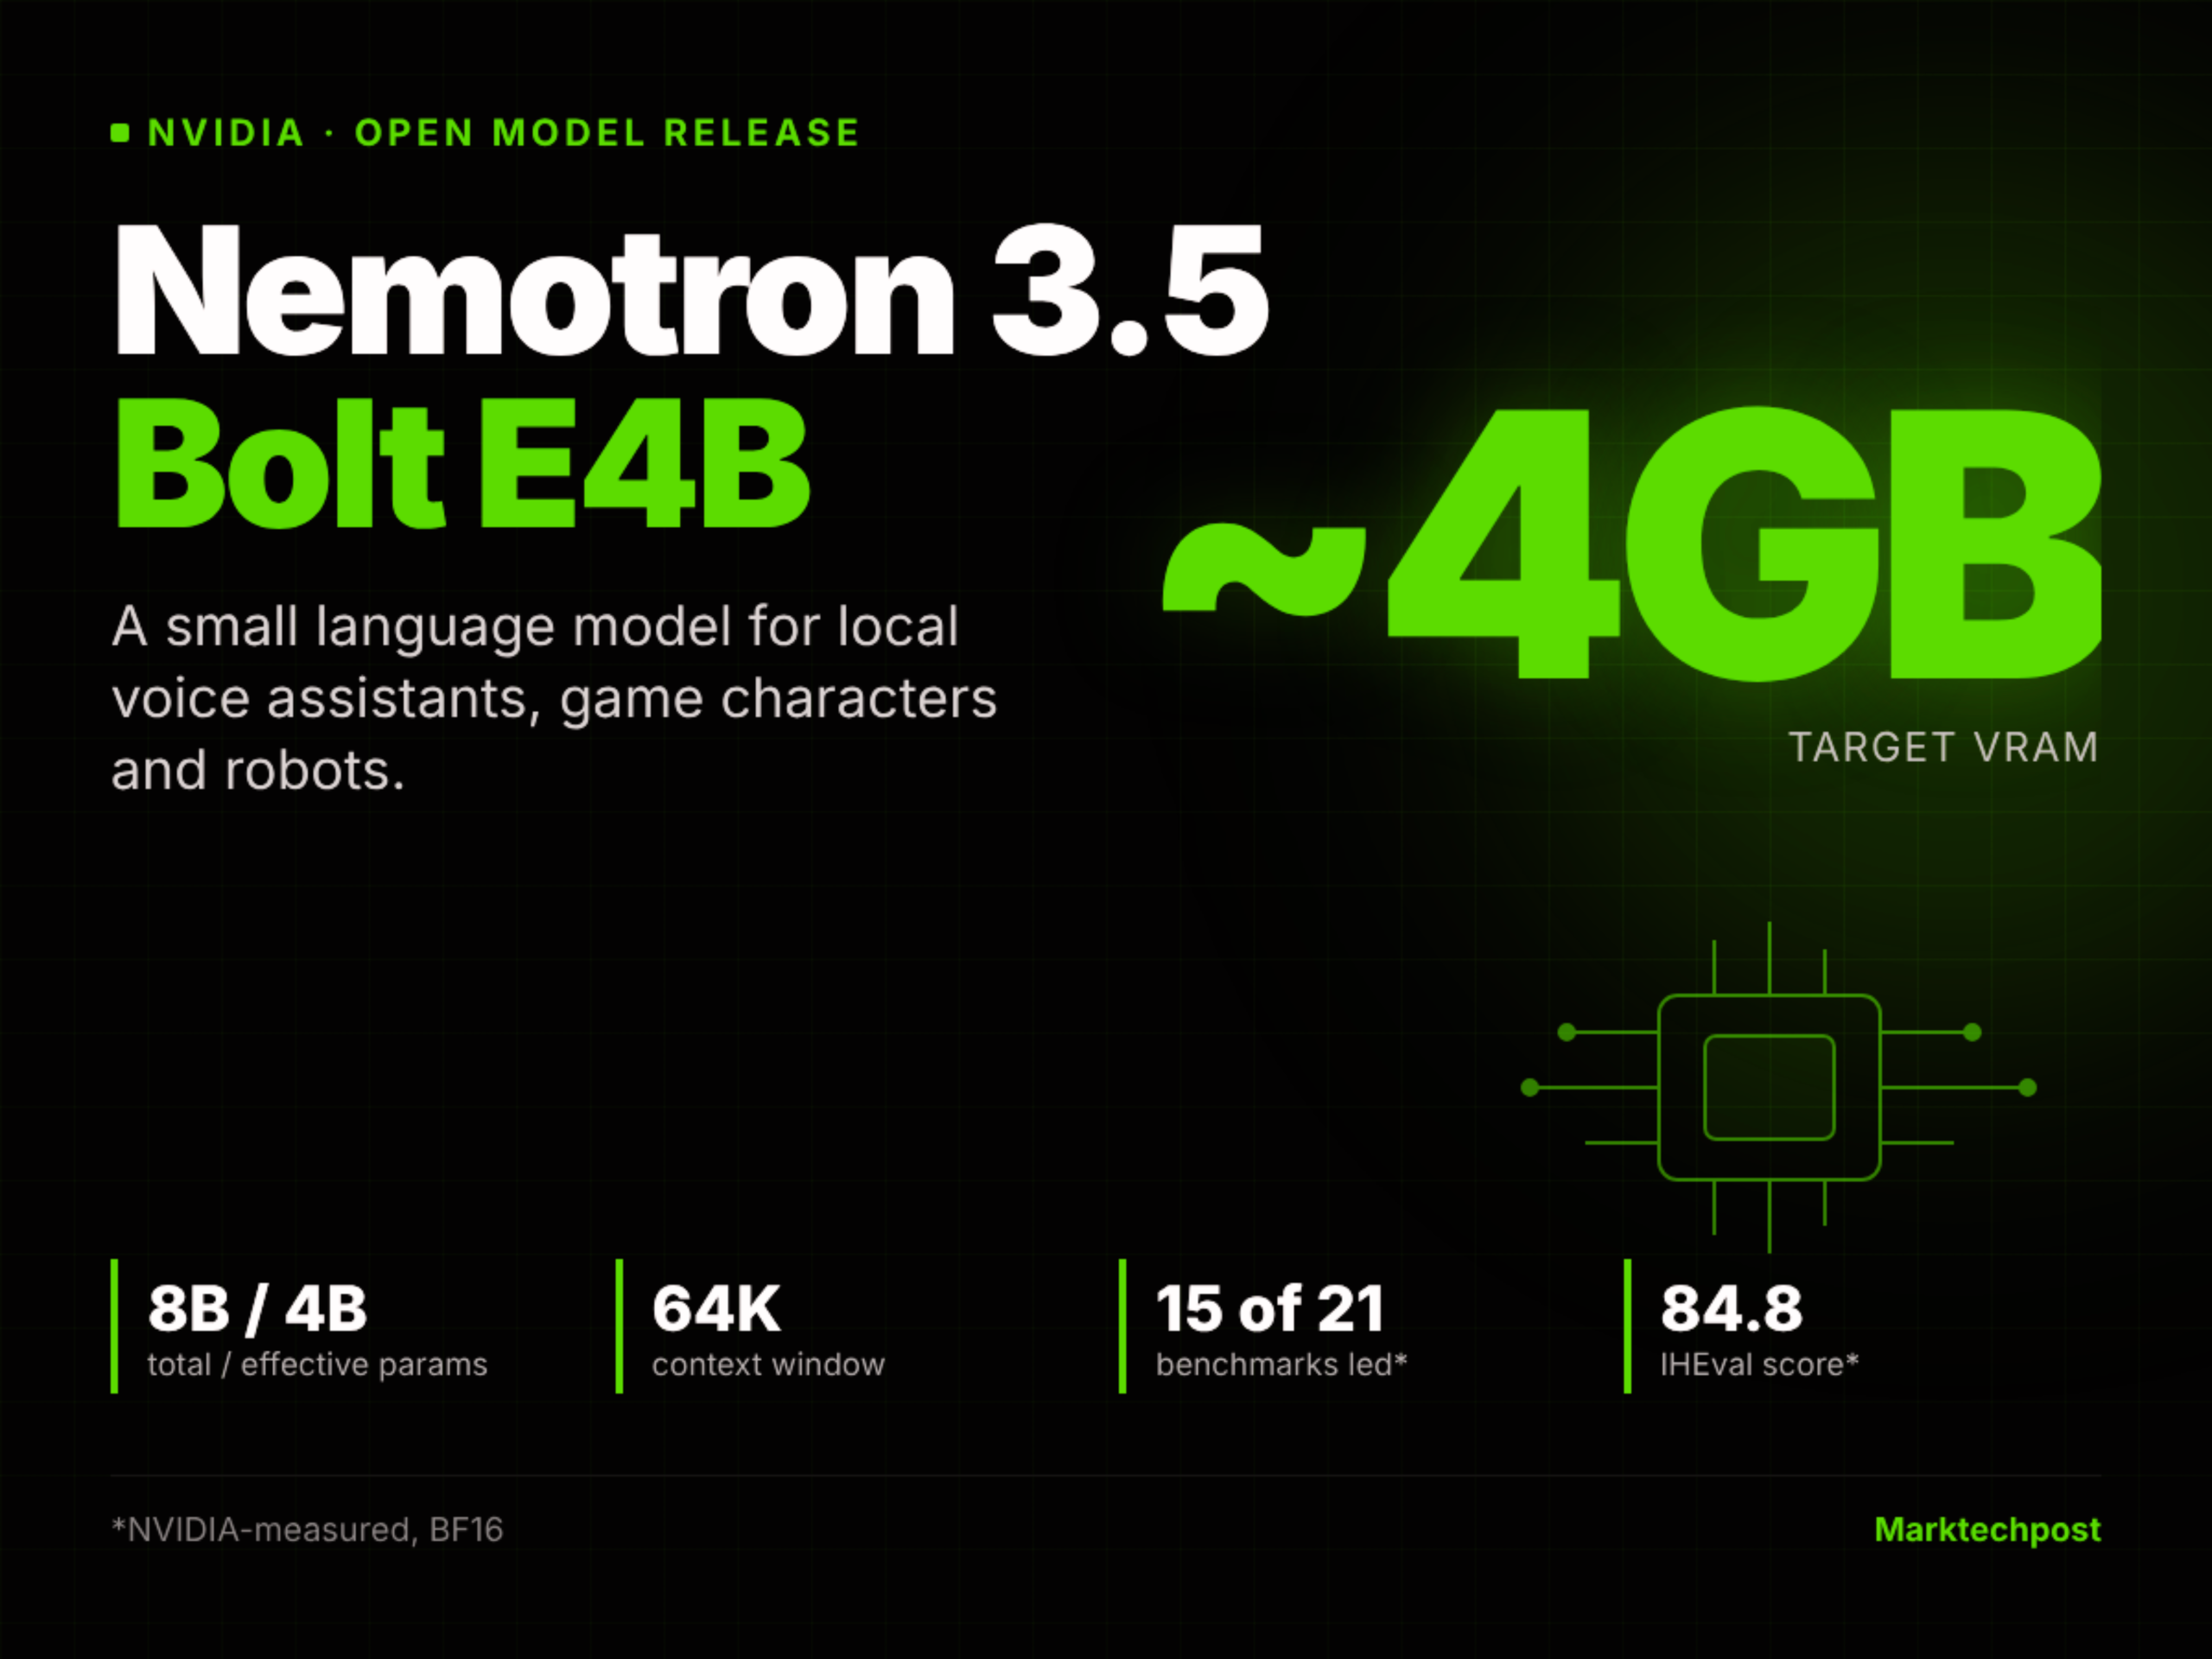
MarkTechPost가 2026년 10월 23일 보도한 바에 따르면, 엔비디아는 오픈 웨이트 모델 Nemotron 3.5 Bolt E4B를 공개했다. Gemma 4 E4B를 강화학습으로만 사후 학습한 모델로, 총 80억 파라미터·유효 40억 파라미터·64K 컨텍스트를 갖추고 로컬 음성 비서, 게임 NPC, 로봇을 겨냥한다. 자체 측정 벤치마크 21개 중 15개에서 우위를 보였으나, Tau2-Bench에서는 55.1로 Qwen3.5-4B의 75.1에 못 미쳤다.
주요 변화
MarkTechPost의 2026년 10월 23일 보도에 따르면, 엔비디아는 Google의 Gemma 4 E4B에서 출발해 지도 미세조정(SFT)을 완전히 건너뛰고 RLVR과 RLHF만으로 NeMo-RL, NeMo-Gym을 통해 사후 학습한 Nemotron 3.5 Bolt E4B를 공개했다. 각 학습 샘플은 추론 모드와 비추론 모드로 동시에 실행되며, 배치 내 비추론 대 추론 샘플 비율은 2:1로 유지되고, GenRM 환경의 길이 페널티가 답변 길이 증가를 억제한다. 데이터셋과 레시피는 공개되었다. 모델은 총 80억 파라미터, 유효 40억 파라미터, 64K 컨텍스트를 갖추고 다중 턴 도구 호출과 비동기 도구 호출 안내를 지원하며, conversational_mode 플래그로 음성에 적합한 짧은 응답을 생성하고 추론 능력과 런타임 사고 예산을 설정할 수 있다. 보도에 따르면 이는 NVIDIA ACE 게임 캐릭터를 위한 3세대 소형 모델이며, Jetson Orin Nano 8GB에서 구동되는 Reachy Mini 로봇이 시연되었는데, 여기서 Cosmos 3 Edge는 비전을, Bolt는 음성 응답과 도구 호출을 담당했다. 배포 측면에서 엔비디아는 BF16 체크포인트를 중요도 행렬로 캘리브레이션해 Q4_K_M으로 양자화했으며, 캘리브레이션에는 약 100만 토큰의 RL 롤아웃을 사용했다. 또한 투기적 디코딩용 DFlash drafter를 함께 제공한다. 보도에 따르면 RTX 5070에서 Bolt는 272.6 tokens/s를, Gemma 4 E4B는 자사의 MTP drafter와 함께 225.9 tokens/s를 기록했다. 하드웨어 실측(Q4_K_M, llama.cpp, batch size 1, 3K 입력 및 50 출력 토큰)에서는 RTX 5070이 3.5GB VRAM을 점유하고 첫 토큰 548ms, 133.4 tokens/s를 보였다. Jetson AGX Orin 32GB는 4.2GB 점유, 3687ms, 24.0 tokens/s였고, Jetson Orin Nano 8GB는 4.2GB 점유, 5785ms, 15.5 tokens/s였다. 보도는 "4GB"가 파일 크기가 아니라 목표 VRAM 구간임을 강조했으며, Hugging Face의 Q4_K_M GGUF는 6.18GB다. 모델은 OpenMDW-1.1 라이선스로 가중치를 공개하며 데이터와 레시피도 공개되었다. Hugging Face, Ollama, LM Studio, Unsloth, Jetson AI Lab에 올라갔고, NVIDIA NIM과 In-Game Inferencing SDK 형태로도 제공되며, 엔비디아 공식 호스팅 플랫폼에서는 무료 API도 제공된다. 벤치마크의 경우 보도된 점수는 모두 BF16 기준으로 엔비디아가 자사 NeMo-Gym 프레임워크에서 측정한 것이다. 21개 중 15개에서 최고점을 기록했으며, IHEval은 84.8(Gemma 4 E4B 67.0, Qwen3.5-4B 60.6)이었다. Tau2-Bench는 55.1로 Qwen3.5-4B의 75.1에 뒤졌고, RULER 64K는 87.0으로 Qwen3.5-4B의 95.1보다 낮았으며, LongBench v2(50.5 대 59.9)와 BFCL-v3(68.5 대 70.9)에서도 Qwen3.5-4B가 앞섰다. Gemma 4 E4B는 EQ-Bench v3에서 41.1 대 39.4로 근소하게 우위를 보였다. 보도는 또한 엔비디아의 주장을 전했다. 평균 점수가 Nemotron 3 Nano 4B보다 약 40% 높고, 추론을 켠 비교에서 출력 토큰이 최대 80% 감소한다는 것이다.
개발자에게 미치는 영향
개발자에게 직접적인 영향은 주로 VRAM 예산과 작업 분담 두 가지에 있다. 보도된 VRAM 수치는 모두 순수 모델 추론 기준이며 음성 인식, 음성 합성, 비전 모델은 포함하지 않는다. 보고서에 나온 Jetson Orin Nano 8GB 데모를 참조해 구성한다면 모델 자체가 이미 4.2GB를 차지하므로, 남은 여유가 어떤 크기의 인지 모델을 넣을 수 있는지, 이미지 해상도를 높일 수 있는지, 16GB 이상 기기로 바꿔야 하는지를 결정한다. 첫 토큰 시간의 격차도 중요하다. RTX 5070의 548ms와 Orin Nano의 5785ms는 전혀 다른 상호작용 경험이며, 후자는 자연스러운 끼어들기 대화보다 턴제에 가깝다. 능력 분포를 보면 이 모델은 범용 소형 모델보다 전용 부품으로 쓰는 것이 적합하다. 엔비디아는 5개 능력 영역의 21개 벤치마크 중 15개에서만 우위를 주장했고, 패한 항목은 장문 컨텍스트와 에이전트 도구 체인에 집중되어 있다. Tau2-Bench, RULER 64K, LongBench v2, BFCL-v3 모두 Qwen3.5-4B에 뒤졌다. 반대로 IHEval 84.8 같은 지시 따르기 점수는 강점이며, conversational_mode 역시 짧고 빠르며 바로 재생 가능한 응답을 의도한 설계임을 보여준다. 종합하면 이 모델은 "대화 더하기 경량 도구 호출"의 후보이지, 복잡한 다중 턴 계획이나 초장문 컨텍스트 검색의 기본 선택은 아니다. 측정 기준의 차이도 판단에 넣어야 한다. 위 점수는 모두 제조사가 자사 테스트 프레임워크에서 측정한 것으로, 제3자 재현과 차이가 있을 수 있다. 보도는 또한 Scale Labs가 MultiChallenge에서 56.03%를 제시해 엔비디아 자체 보고 53.1보다 높았다고 전했다. 같은 기사에 두 세트의 숫자가 공존한다는 것은 모델 선정 시 어떤 단일 점수도 정설로 삼아서는 안 된다는 뜻이며, 특히 비즈니스 분포가 벤치마크 분포와 다를 때 그렇다.
연동 및 평가 제안
다음은 보도에 기반한 조건부 제안과 조건 분석이며, 검증된 결론이 아니다. 결정 1: 대상 기기의 VRAM 여유에 따라 양자화 버전과 배포 형태를 정한다. 기기가 8GB급 Jetson이나 12GB 그래픽카드이고 음성과 비전 모델을 동시에 돌려야 한다면, Q4_K_M과 llama.cpp 경로를 우선 검증할 수 있다. 보도된 4.2GB 점유와 6.18GB 파일 크기는 가중치 파일 자체가 "4GB" 예산에 들어가지 않으며 양자화 실행 형태가 실제 사용 가능한 형태임을 보여준다. 측정 기준은 구체적이다. 자체 입력 길이에서(보도는 3K 입력, 50 출력 토큰 사용) 첫 토큰 지연과 tokens/s를 측정하고, 인지 모델을 중첩한 뒤에도 여유가 있는지 확인한다. 첫 토큰이 상호작용 설계에서 허용 가능한 상한을 넘으면 프롬프트를 계속 조정하기보다 더 작거나 더 공격적인 양자화 단계로 바꿔야 한다. 결정 2: 워크로드가 도구 호출 중심인지에 따라 Bolt를 투입할지 정한다. 제품이 음성 비서식 짧은 대화에 소량의 도구 호출을 더한 것이라면 conversational_mode와 64K 컨텍스트는 시험해 볼 가치가 있다. 핵심 경로가 다중 턴, 상태를 가진 긴 도구 궤적이라면 보도의 Tau2-Bench 55.1 대 75.1 격차는 Qwen3.5-4B로 먼저 베이스라인을 세우라는 신호다. 측정 기준은 자사 비즈니스의 다중 턴 도구 호출 궤적을 고정 평가 세트로 정리하고, 동일한 함수 정의 아래에서 작업 완료율과 평균 호출 턴 수를 비교하는 것이지, 단일 턴 응답의 유창성만 보는 것이 아니다. 결정 3: 런타임 사고 예산을 스위치가 아니라 보정이 필요한 파라미터로 취급한다. 보도에 따르면 모델은 설정 가능한 추론과 런타임 사고 예산을 지원하며, 추론을 켠 비교에서 출력 토큰이 최대 80% 감소한다고 한다(제조사 주장). 이는 동일한 가중치가 추론 켜기와 끄기에서 서로 다른 지연과 품질 곡선을 갖는다는 뜻이다. 방법은 음성 체인에 지연 예산을 설정하고 그 예산 안에서 둘 중 하나를 선택하며, 출력 토큰 수와 첫 패킷 시간을 측정 지표로 삼아 토큰 절감 주장이 자사 작업 분포에서도 성립하는지 검증하는 것이다. 결정 4: 라이선스는 별도로 확인해야 한다. 보도에 따르면 가중치는 OpenMDW-1.1로 공개되었고, 베이스인 Gemma 4 E4B는 Apache 2.0으로 두 조항은 같지 않다. 가중치를 제품에 포함하기 전에 라이선스 본문을 직접 읽고 배포, 저작자 표시, 상업적 조건을 확인해야 하며, "오픈 웨이트"라는 라벨에서 권한을 추론해서는 안 된다.
제한과 확인할 사항
본문에서 다룬 Nemotron 3.5 Bolt E4B는 현재 KimiSeek에 올라 있지 않으며, 사이트 모델 목록에 해당 항목이 없다. 보도에서 언급된 무료 API는 엔비디아 공식 호스팅 플랫폼에서의 해당 모델 이용 가능성을 가리키며 본 사이트와 무관하다. 실제 이용 가능성과 조건은 제조사 문서를 기준으로 해야 한다. 알려진 경계는 다음과 같다. 보도의 모든 벤치마크 점수는 BF16 기준으로 엔비디아가 자사 NeMo-Gym 프레임워크에서 측정한 것이며 독립 재현이 아니다. 평균 점수가 Nemotron 3 Nano 4B보다 약 40% 높고 추론을 켤 때 출력 토큰이 최대 80% 감소한다는 것도 모두 제조사 자체 보고다. 속도 비교도 기준 차이가 있다. 272.6 대 225.9 tokens/s는 RTX 5070에서 Bolt에 DFlash drafter를, Gemma 4 E4B에 MTP drafter를 붙인 결과로, 하드웨어 표의 133.4 tokens/s와 기준이 다르므로 두 수치를 직접 맞바꿔 쓸 수 없다. MultiChallenge에서 엔비디아는 53.1을 자체 보고했고, 보도가 전한 한 X 게시물은 Scale Labs가 56.03을 제시했다고 하므로 두 숫자는 출처를 각각 표기해야 한다. 라이선스 측면에서 Bolt는 OpenMDW-1.1로 공개되었고 베이스 Gemma 4 E4B는 Apache 2.0이므로, 오픈 웨이트가 동일한 상업적 조항을 뜻하지는 않는다. 하드웨어 데이터는 RTX와 Jetson 네 가지 기기만 포괄하며 다른 플랫폼 데이터는 없다. 입력 형태의 경우 보도의 비교표에 따르면 Bolt 모델 카드에 표기된 입력은 텍스트이며, NIM 형태는 이미지와 오디오도 받는다. 실제 사용 가능한 모달리티와 제한은 여전히 공식 문서를 기준으로 해야 하며, 보도는 이러한 모달리티의 평가 데이터를 제시하지 않았다.