Reflection Beam과 Mistral Large 4 동시 공개: 오픈 웨이트 선택지 늘었지만 가중치와 라이선스는 미확정
InfoQ 중국어판의 2026년 10월 보도에 따르면 10월 5일부터 6일까지 미국 Reflection이 첫 오픈 웨이트 MoE 모델 Beam을 발표했고, 하루 뒤 프랑스 Mistral이 자사 최대 모델 Mistral Large 4를 공개했다. 보도는 Beam의 강점을 추론 효율로 들며 일부 벤치마크에서 GLM-5.2에 근접하지만 중국 최신 세대에는 뒤진다고 전했다. Large 4는 API 프리뷰가 열려 있고 전체 가중치는 10월 말 공개 예정이며, 두 버전 모두 현재 KimiSeek에 등재되지 않았다.
주요 변화
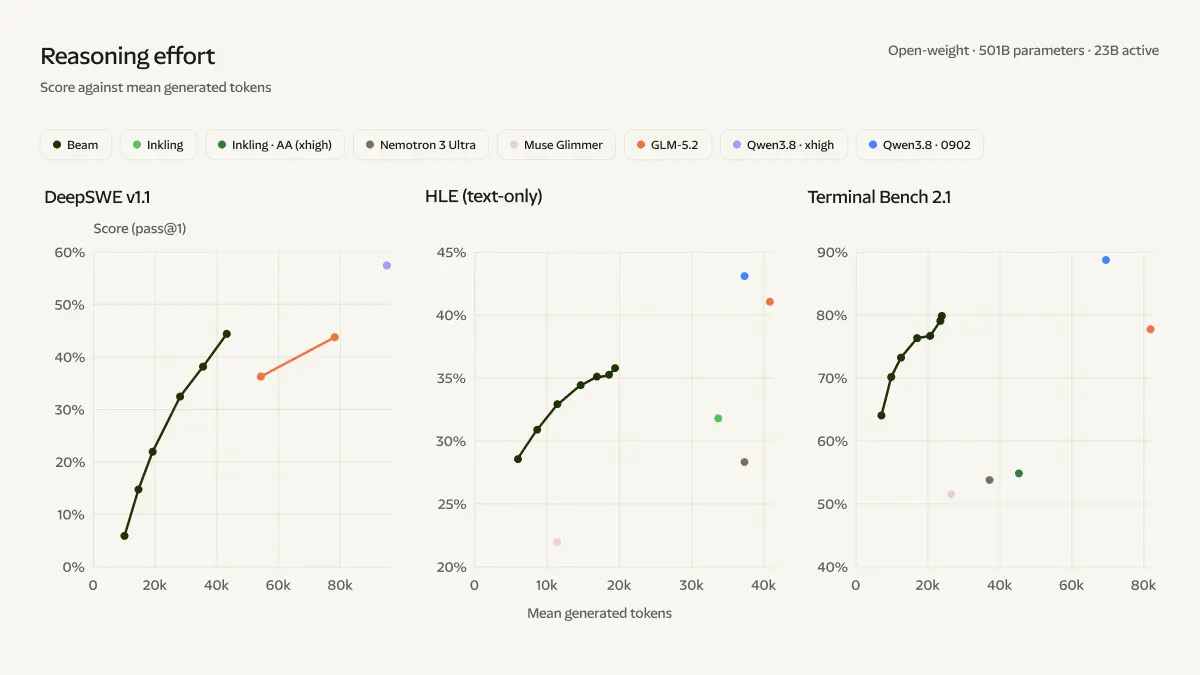
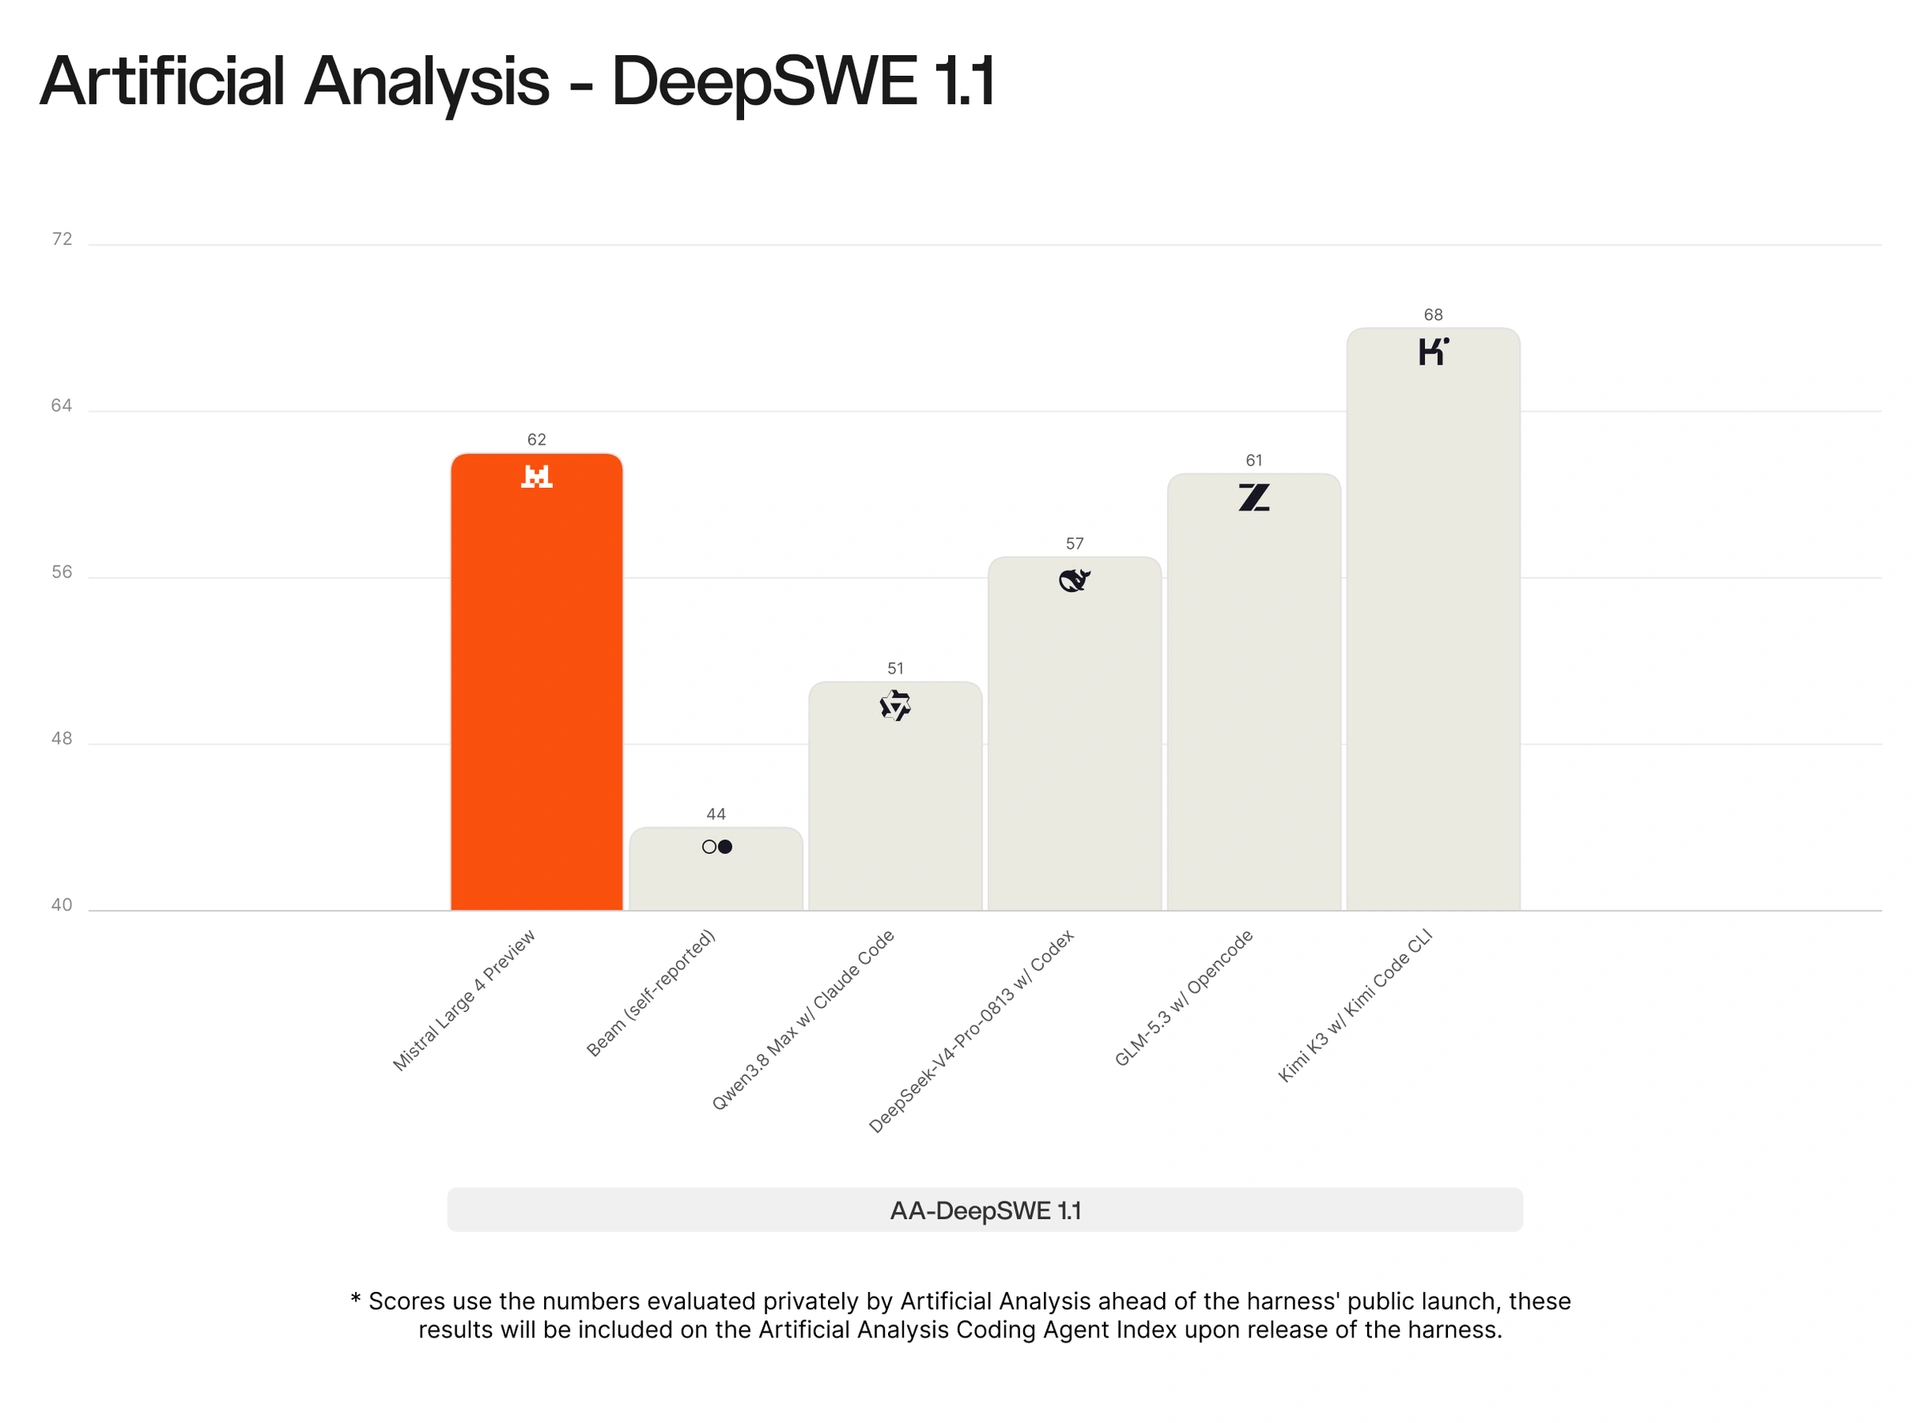
InfoQ 중국어판 보도(원문은 현지 시각 10월 5일부터 6일로 표기)에 따르면 미국 스타트업 Reflection이 첫 오픈 웨이트 모델 Beam을 발표했고, 하루 뒤 프랑스 Mistral이 Mistral Large 4를 내놓았다. 보도는 Beam이 MoE 모델로 총 파라미터 5010억, 토큰당 활성 230억이며 코딩, 추론, Agent 워크로드를 겨냥하고 23.8조 토큰으로 사전 학습되었으며 Nvidia GB300 1만 500장을 동원해 4주 연속 고연산 강화학습을 수행하고 1억 회 이상의 rollout을 생성했다고 전했다. 발표 시점에 최종 레드팀 테스트 단계였고, Reflection은 10월에 가중치와 기술 보고서, 개발 도구를 공개할 계획이라고 한다. Mistral Large 4는 활성 520억, 총 파라미터 1.05조, 16억 파라미터 비전 인코더를 포함한 네이티브 멀티모달로 160개 이상 언어를 지원하며 컨텍스트 창은 100만 토큰이고, 유럽 데이터센터에서 Nvidia Grace Blackwell GPU 약 3800장으로 처음부터 학습되었다고 한다. 보도 시점에 API 프리뷰가 열려 있었고 전체 가중치는 10월 말 공개 예정이다. 보도가 인용한 벤치마크에서 Beam은 DeepSWE v1.1 44.4, Terminal Bench v2.1 80.1로 보도에 함께 실린 GLM-5.3, Kimi K3, DeepSeek V4.1 Flash보다 낮았고, Humanity's Last Exam에서는 36.2로 같은 원문에 병기된 GLM-5.3의 42.3, Kimi K3의 46.9보다 낮았다(원문은 DeepSeek V4.1 Flash의 해당 점수를 제시하지 않았다). Mistral 쪽은 Large 4가 공식 Coding Agent Index에서 DeepSeek V4 Pro와 Qwen 3.8 Max를 앞서고 Kimi K3에는 뒤졌으며, AutomationBench에서는 Kimi K3와 MiMo-V2.6-Pro, DeepSeek V4 Pro를 앞서고 GLM-5.3에는 뒤졌다고 보도했다. 이 점수들은 각각 벤더 자체 주장 또는 벤더가 인용한 제3자 테스트에서 나온 것으로 보도가 전한 내용이며 독립 재현된 것은 아니다.
개발자에게 미치는 영향
이번 발표가 바꾸는 것은 오픈 웨이트 진영의 후보 집합과 비교 좌표이지 중국 모델의 즉각적인 가용성은 아니다. 가장 공학적으로 의미 있는 점은 Reflection이 Beam의 강점을 절대 성능이 아니라 "단위 추론 연산으로 얼마나 많은 지능을 얻는가"로 옮겼다는 것이다. 보도에 따르면 일부 고급 추론 작업에서 GLM-5.2의 약 4분의 1에서 3분의 1 수준의 연산으로 비슷한 성능에 도달할 수 있다. 이 주장이 자체 부하에서 성립한다면 긴 체인 Agent와 배치 추론의 작업당 비용 구조에 영향을 준다. 다만 보도가 전한 벤치마크 기준으로 Beam이 따라잡은 대상은 주로 중국의 이전 세대 모델이며, DeepSWE v1.1과 Terminal Bench v2.1에서는 같은 원문에 병기된 GLM-5.3, Kimi K3, DeepSeek V4.1 Flash보다 낮고 HLE에서는 원문에 실린 GLM-5.3과 Kimi K3보다 낮다. 따라서 "더 적은 연산으로 비슷한 능력"과 "같은 연산으로 더 높은 품질"은 서로 다른 대체 경로이며 상호 대체할 수 없다. Mistral Large 4의 초점은 다르다. 100만 토큰급 컨텍스트와 네이티브 멀티모달, 다국어에 더해 보도가 강조한 프라이빗 클라우드 또는 로컬 배포와 사용자 정의 보안 정책은 순수 코딩 벤치마크 경쟁이 아니라 여러 애플리케이션을 넘나드는 기업 워크플로와 데이터 경계를 자체 통제해야 하는 시나리오를 겨냥한다. 개념 구분이 필요하다. 두 모델 모두 오픈 웨이트로 묘사되지만 보도에서 가중치 가용 시점은 서로 다르고, 발표 시점에 둘 다 실제로 가중치가 열린 것은 아니다. 오픈 웨이트는 다운로드 가능한 모델 파일을 뜻하며 학습 데이터와 학습 코드, 라이선스 조항이 열려 있는지와는 다른 문제다. 보도는 라이선스 세부를 제시하지 않았으므로 이를 근거로 상업적 이용과 재배포, 파인튜닝 권리를 추론할 수 없다. 또한 현재 카탈로그를 확인한 결과 Beam과 Mistral Large 4는 KimiSeek에 대응 항목이 없으며, 보도된 API 프리뷰와 가용성은 벤더 자체 채널을 가리킨다.
연동 및 평가 제안
다음은 조건부 분석 또는 제안이며 보도된 사실이 아니다. 첫째, 주 워크로드가 긴 체인 Agent 코딩이고 비용에 민감하다면, 보도는 Beam이 GLM-5.2의 약 4분의 1에서 3분의 1 수준의 추론 연산으로 그에 근접한 성능을 낼 수 있다고 전한다. 현재 사용 가능한 같은 범주의 옵션에는 GLM-5.2와 DeepSeek V4.1 Flash가 있으므로, 자체 다중 턴 도구 호출 궤적으로 소규모 비교를 먼저 할 수 있다. 측정 지표는 작업 하나를 완료하는 데 드는 총 토큰과 종단 간 지연이며, 전제는 보도 벤치마크에서 중국 최신 세대보다 낮은 수준을 감수할 수 있다는 것이다. 실패율이 높아져 재시도가 발생하면 연산 절감이 상쇄되므로 이 경우 대체는 부적절하며, 평가 기준은 동일 작업 집합에서 종단 간 성공률 하락이 사전 설정 임계값을 넘지 않는 것으로 둘 수 있다. 둘째, 워크로드가 100만 토큰급 컨텍스트나 멀티모달 입력, 다국어를 요구한다면 Mistral Large 4는 100만 토큰 컨텍스트와 160개 이상 언어를 지원한다고 보도되었으나 가중치와 최종 조항이 미정이므로, API 프리뷰 단계에서 긴 컨텍스트 검색 정확도와 비전 인코더의 자체 문서 성능을 먼저 검증해야 한다. 측정 지표는 긴 컨텍스트 질의응답 정확도와 요청당 비용이며, 전제는 프리뷰 버전의 동작을 향후 오픈 웨이트의 동작과 동일시하지 않고 기존 주력 모델을 대체 수단으로 남겨 두는 것이다. 두 규칙 모두 가중치가 정식 공개되고 라이선스가 명확해진 뒤 다시 검토해야 한다.
제한과 확인할 사항
보도 내용은 주로 벤더 자체 주장과 벤더가 인용한 제3자 테스트에서 나왔으며 벤치마크 점수는 독립 재현되지 않았으므로 검증된 결론으로 볼 수 없다. 특히 원문은 Humanity's Last Exam에서 Beam 36.2, GLM-5.3 42.3, Kimi K3 46.9만 제시했고 DeepSeek V4.1 Flash의 HLE 점수는 싣지 않았으므로 HLE 비교 대상은 원문에 실제로 병기된 GLM-5.3과 Kimi K3로 한정해야 한다. 세 벤치마크를 합쳐 "모두 세 곳보다 낮다"고 하는 것은 원문이 뒷받침하지 않는 벤치마크 간 비교다. 또한 Beam과 Mistral Large 4는 KimiSeek의 현재 모델에 대응 항목이 없어 두 버전 모두 현재 KimiSeek에 등재되지 않았으며, 보도된 API 프리뷰와 가중치 공개 계획은 벤더 자체 채널의 가용성을 가리키는 것으로 KimiSeek의 제공 여부와 무관하다. 가중치 가용성은 오픈 소스 라이선스와 동일하지 않으며 보도는 라이선스 조항을 제시하지 않았으므로 상업적 이용과 재배포 권리는 벤더가 실제 공개한 라이선스를 기준으로 해야 한다. 보도는 Beam 가중치를 10월에, Large 4 전체 가중치를 10월 말에 공개할 계획이라고 전했으며 발표 시점에 둘 다 실제로 가중치가 열린 것은 아니고 이후 일정 준수 여부와 조항 변경은 알 수 없다. "약 4분의 1에서 3분의 1 수준의 연산"이라는 표현은 Reflection의 자체 주장으로 독립적인 측정 기준이 없으며 실제 대체 효과는 자체 부하에서 검증해야 한다. 이 브리핑은 두 회사의 향후 로드맵이나 비즈니스 모델 약속 이행 여부를 판단하지 않는다.
원문 보도의 이미지