Supersonic Labs, Julia 1 공개: 1억 4,430만 파라미터 Apache 2.0 의사결정 모델, CPU 온디바이스 실행 지원
MarkTechPost가 2026년 9월 26일 보도한 바에 따르면, 브라질 Supersonic Labs는 mmBERT-small 기반의 1억 4,430만 파라미터 의사결정 모델 Julia 1을 공개했으며, 가중치는 Apache 2.0으로 배포되고 choice, score, noul 세 가지 호출을 지원하며 CPU에서 로컬 실행이 가능하다. 실험에서는 Typed Decisions, AG News, DAIR Emotion에서 Jev 참조값을 상회했으나 72개 라벨의 Banking77에서는 뚜렷하게 뒤처졌고, 호스팅 API는 발표되었으나 아직 개방되지 않았다.

주요 변화
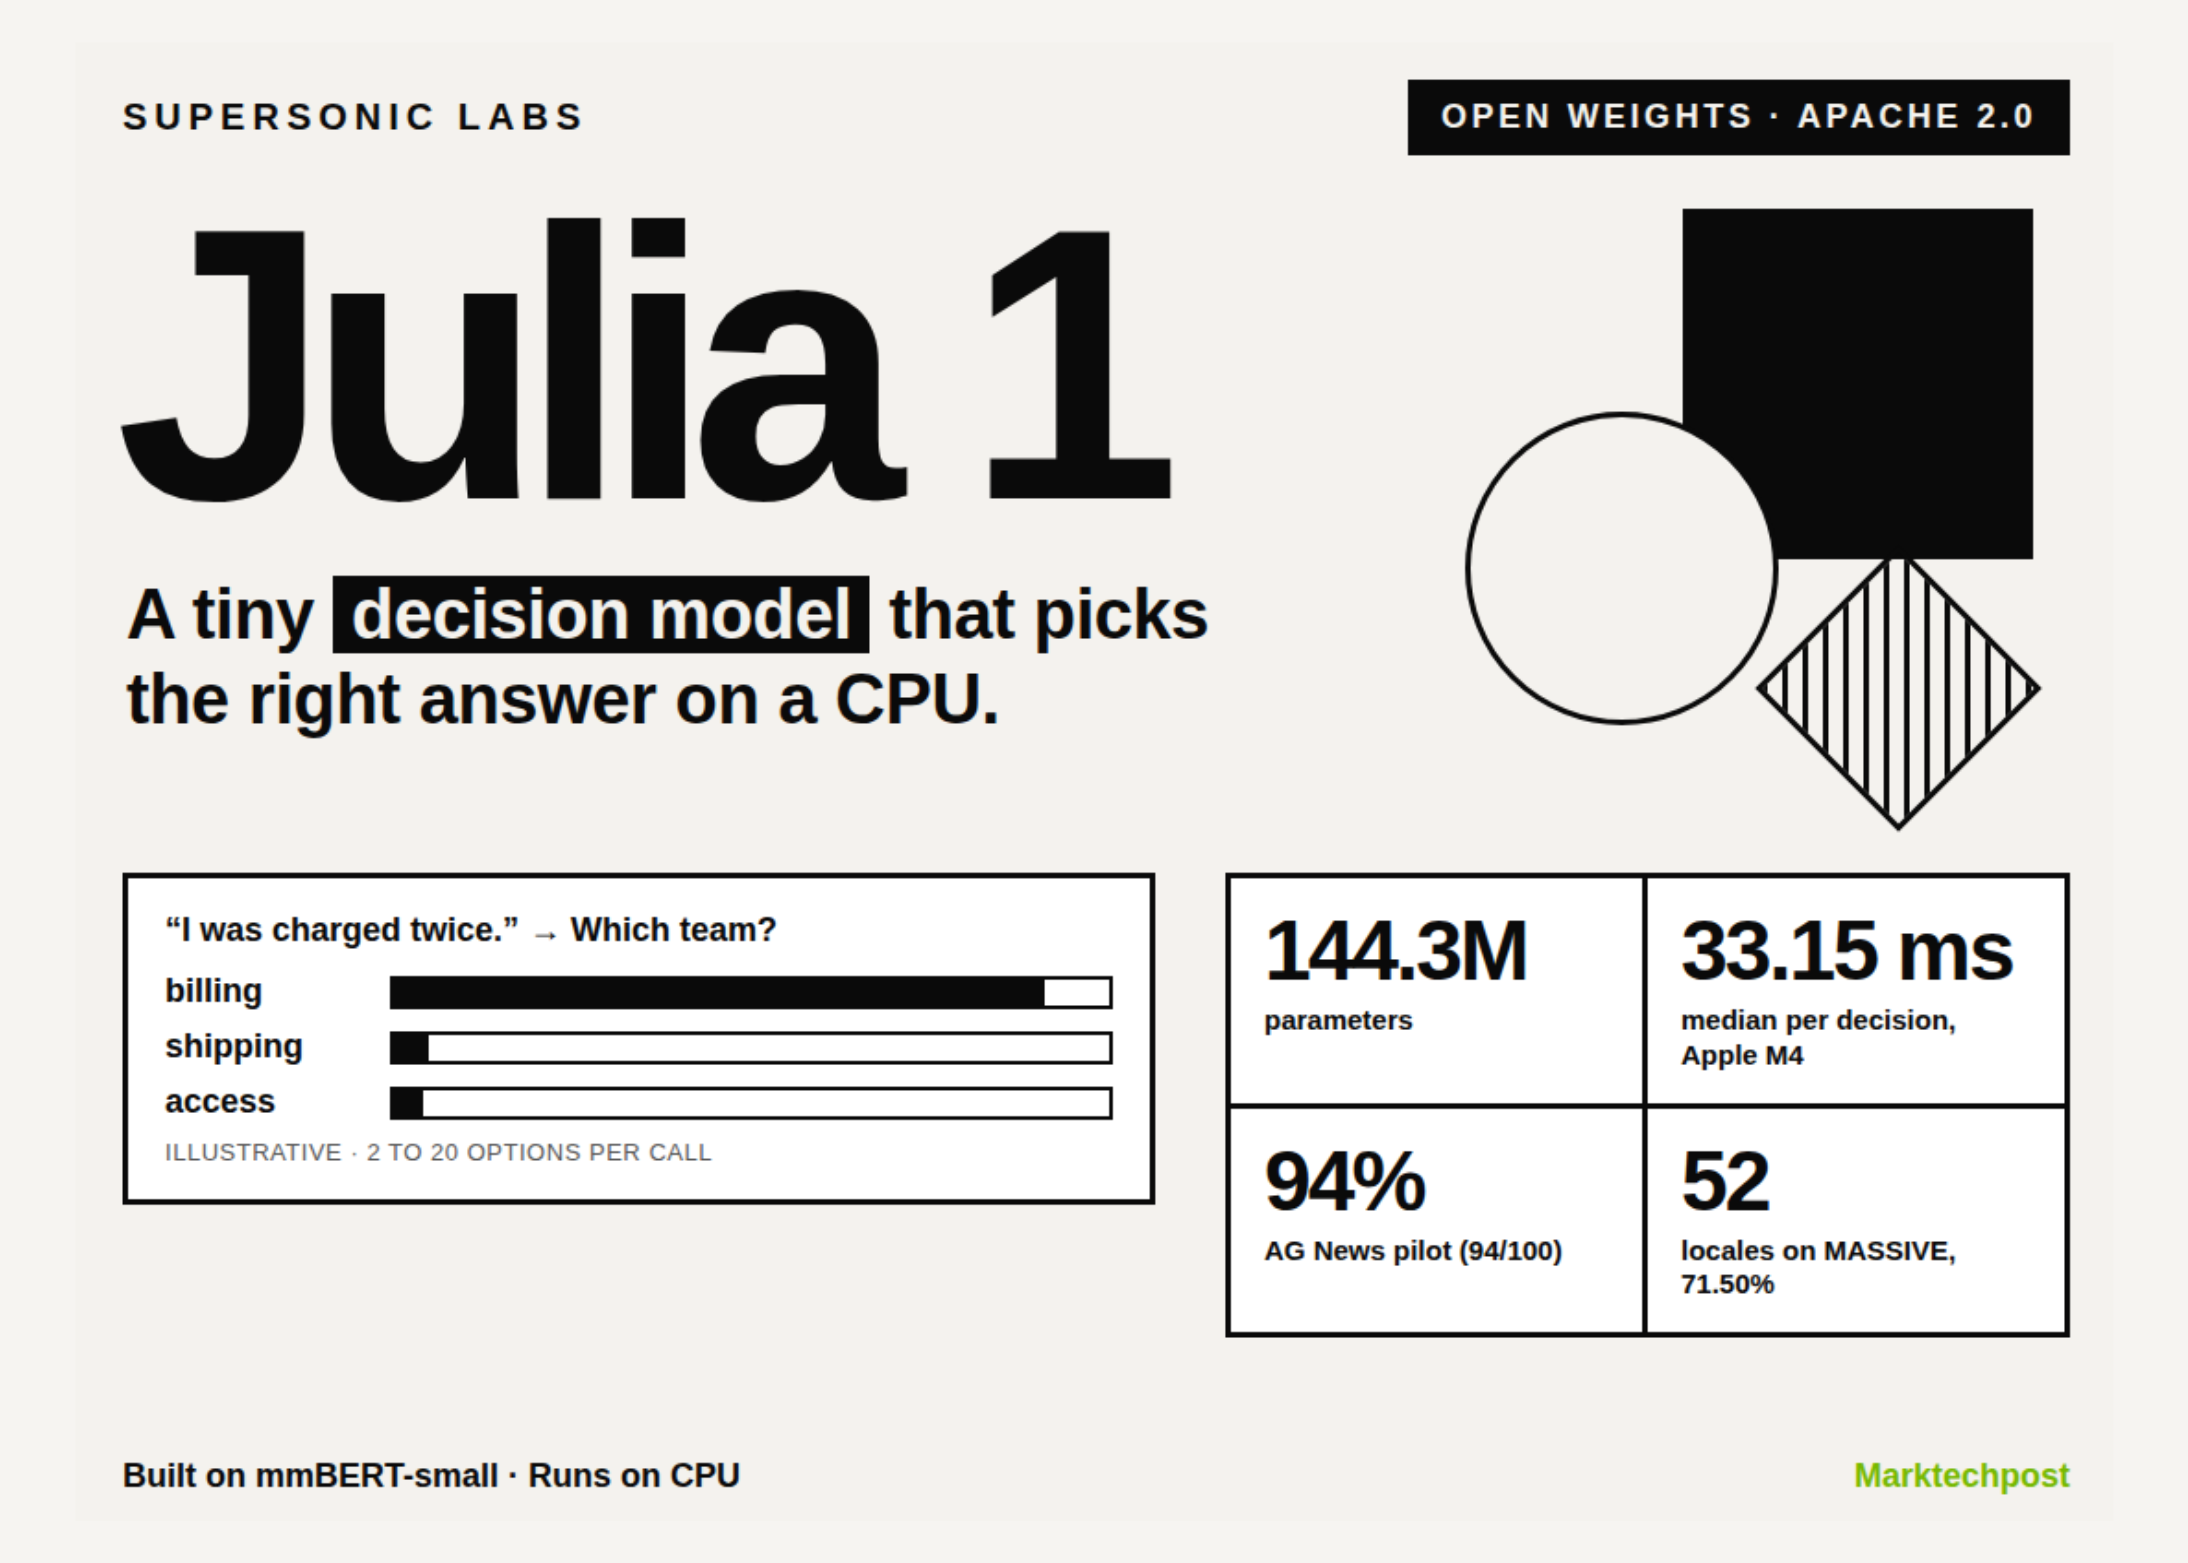
MarkTechPost가 2026년 9월 26일 보도한 바에 따르면, 브라질의 소규모 연구소 Supersonic Labs는 Julia 1을 공개했다(참고: 이 버전은 현재 KimiSeek 카탈로그에 등재되어 있지 않으며, 보도에서 언급된 API 가용성은 제조사 측 사정을 가리킨다). 이는 채팅 모델이 아니라 의사결정 모델이다. 호출자가 컨텍스트, 질문, 그리고 설명이 붙은 2~20개의 후보 답변을 전달하면, 모델은 주어진 순서에 따라 선택 항목과 전체 softmax 확률을 반환하고, 호출자 ID는 그대로 회신되며 자유 텍스트는 생성하지 않는다. 가중치는 Hugging Face에 Apache 2.0으로 공개되었다(가중치 확보가 오픈소스 라이선스 보유를 의미하는 것은 아니나, 이 경우 출처가 Apache 2.0임을 명시했다). Python 3.11 이상 환경에서 CPU 또는 BF16을 지원하는 GPU에서 실행 가능하며, ONNX 빌드를 통해 WebGPU로 브라우저에서도 실행할 수 있다. 호스팅 API는 발표되었으나 아직 개방되지 않았다. 모델은 JHU CLSP의 mmBERT-small 인코더에 의사결정 헤드를 결합한 구조이며, 연구소는 Qwen을 파인튜닝한 것이 아니라고 명확히 밝혔다. 런타임 병합 토큰 상한은 8,192이고, 공개 벤치마크는 1,024를 사용했다. 세 가지 호출은 choice(분류, 라우팅), score(순서 있는 점수 반환 및 기대 인덱스), noul(참/거짓 확률)이다. 보도에 따르면 2026년 9월 24일 평가는 H200 BF16에서 엄격한 인코딩 방식으로 실행되었고, 비교 대상은 Jev를 재실행한 것이 아니라 TypeSafe Jev 벤치마크 프로토콜의 참조값이다. Typed Decisions 73.15%(참조 72.70%), AG News 94/100(참조 91%), DAIR Emotion 86/100(참조 48%), Banking77은 64/100(참조 87%)에 그쳤고, MASSIVE는 52개 언어권 매크로 평균 71.50%, pt-PT 86.25%, en-US 86.75%였다. 분류 실험은 각 항목당 100개 샘플만 사용했다. 9월 25일 CPU 실행에서는 Typed Decisions 72.55%, Banking77 60/100이 재현되었고 3건의 응답 거부가 있었다. 지연 시간과 관련해 보도는 Apple M4 단일 의사결정 중앙값 33.15밀리초, 삼성 SM-X510 태블릿에서 ONNX Runtime 경유 중앙값 203밀리초와 최대 RSS 393.1MB, Intel Core i5-1235U에서 AG News 중앙값 107.83밀리초를 제시했으며, Banking77은 72개 라벨을 먼저 좁혀야 해서 3,713.54밀리초가 걸렸다.
개발자에게 미치는 영향
개발자에게 미치는 직접적 영향은 분류/라우팅/스코어링을 대형 모델에서 분리해 온디바이스 소형 모델로 옮기는 하나의 선택지가 등장했다는 점이다. 1억 4,430만 파라미터, FP32 가중치 약 550.5MiB라는 것은 휴대폰, 태블릿, 노트북, 심지어 브라우저에도 탑재할 수 있으며 분류 호출마다 비용을 내거나 네트워크에 연결할 필요가 없다는 의미다. 보도에서 계획된 API 가격은 백만 입력 토큰당 0.025달러지만 해당 API는 아직 개방되지 않았고 그 가격 보도의 시점은 2026년 9월이므로, 독자는 현재 가격을 본문이 아니라 제조사의 최신 페이지에서 확인해야 한다. 동시에 능력 경계를 분명히 봐야 한다. 이 모델은 제시된 후보 사이에서만 비교하며 누락된 사실을 보완하거나 대수·다단계 계산을 하지 못하고, Router가 좁히는 과정에서 정답 라벨을 버릴 수 있으며, 기존 Transformers 파이프라인을 바로 대체하는 구성 요소도 아니다. 보도에 따르면 이를 호스팅하는 Hugging Face 추론 제공자는 없다. 벤치마크에서 가장 중요한 신호는 "세 항목이 Jev를 상회했다"가 아니라 라벨 공간이 4, 6에서 72로 확장될 때의 급격한 성능 저하다. AG News 94/100 대 Banking77 64/100, 그리고 CPU 재현에서는 60/100에 그쳤다는 점은 이 모델이 세밀한 다중 분류보다는 거친 입자, 적은 라벨의 판정에 더 적합함을 보여준다. 또한 보도의 "Jev보다 5배 빠르다"는 주장은 제조사의 X 게시물에서 나온 것이고, Jev 실험은 Jev를 호스팅 서비스로 프랑스에서 호출해 측정한 것이므로 지연 시간이 동일 조건 비교가 아니어서 그대로 받아들이기 어렵다.
연동 및 평가 제안
다음은 보도를 바탕으로 한 조건부 분석과 제안이며, 검증된 사실이 아니다. 첫 번째 결정: 이 모델의 출력을 온라인 자동 라우팅에 직접 사용할지 여부. 보도의 "라벨 수가 많을수록 나쁘다"(Banking77 64/100, CPU 60/100)와 "Router가 라벨을 잃을 수 있다"는 서로 다른 변동이므로 분리해 다뤄야 한다. 시나리오의 라벨 수가 약 20개를 넘고 오판이 결제, 권한, 환불 같은 되돌릴 수 없는 동작을 유발한다면 모델 출력을 직접 실행하지 말고 제2의 판정이나 사람 검수를 붙이는 것이 좋다. 라벨 수가 매우 적고(예: 4개 이내의 거친 분류) 동작이 롤백 가능하다면 우선 그레이 단계로 진입할 수 있다. 측정 가능한 평가 기준: 자체 샘플링한 최소 200건의 실제 요청에서 모델 선택 항목과 사람이 라벨링한 값의 일치율을 비교하고, "정답이 Router의 축소 단계에서 배제된" 비율을 별도로 집계한다. 두 번째 결정: 기존 호스팅 분류 호출을 온디바이스 배포로 대체할지 여부. 보도에서 제시한 기기 실측은 M4 중앙값 33.15밀리초, SM-X510 중앙값 203밀리초, i5-1235U에서 AG News 중앙값 107.83밀리초였고 Banking77은 3,713.54밀리초에 달했다. 이는 후보 수나 라벨 규모가 실행 가능성의 전제 조건임을 뜻한다. 요청이 적은 라벨의 짧은 텍스트 위주이고 수백 밀리초 수준의 네트워크 없는 로컬 추론을 감수할 수 있다면 온디바이스가 더 유리하다. 라벨 규모가 크거나 낮은 지연과 높은 동시성이 필요하다면 온디바이스 CPU 경로는 성립하지 않을 수 있다. 측정 가능한 평가 기준: 목표 기기에서 입력 길이를 고정하고 각 의사결정 유형의 P50, P95 지연과 최대 메모리(보도 참조값 RSS 393.1MB)를 부하 테스트하며 기존 방안과 같은 기기에서 비교한다. 세 번째 결정: 지금 업무를 호스팅 API로 이전할지 여부. 보도는 해당 API가 발표되었으나 아직 개방되지 않았다고 명확히 밝혔으므로 현 단계에서는 자체 호스팅만 가능하다. 우선 로컬 가중치로 소규모 검증을 하고 API 측 가용성, 속도 제한, 과금을 확인한 뒤 전환 여부를 정하는 것이 좋으며, 보도의 계획 가격을 근거로 용량 계획을 세우지 말아야 한다. 평가 절차로는 먼저 1,024 토큰 이내로 입력을 고정하고 보고된 기준에 맞춰 후보를 구성해 오프라인 일치율 테스트를 하고, 이어 기기 부하 테스트를 진행하며 두 가지가 모두 기준을 충족한 뒤 그레이 단계에 올리는 것을 권한다.
제한과 확인할 사항
이번 보도의 핵심 한계는 표본과 비교 기준이다. 분류 실험은 항목당 100개 샘플만 사용했고, Typed Decisions는 2,000건이지만 나머지 항목은 신뢰 구간이 넓어 강한 결론을 뒷받침하기 어렵다. 비교 기준선은 동일 환경에서 Jev를 재실행한 것이 아니라 Jev 프로토콜의 참조값을 사용했고, Jev 지연은 호스팅 서비스를 국경을 넘어 호출해 측정한 것이라 이 모델의 로컬 실행과 비교할 수 없으므로 제조사의 "5배 빠르다" 주장은 독립적 검증이 필요하다. 모델의 비공개 훈련 파이프라인은 공개되지 않아 데이터 구성과 잠재적 편향을 확인할 수 없다. 9월 25일 CPU 재현에서 3건의 응답 거부가 발생했다는 점은 저사양 환경에서 동작이 퇴화할 수 있음을 보여준다. 보도에서 주장된 호스팅 API는 이 글을 쓰는 시점에 아직 개방되지 않았으며, 계획된 백만 입력 토큰당 0.025달러 가격은 2026년 9월 보도에서 나온 것으로 가격은 변할 수 있으니 제조사의 가격 페이지를 기준으로 확인해야 한다. 특히 밝혀둘 점은 Julia 1 버전이 현재 KimiSeek 카탈로그에 등재되어 있지 않으며, 보도에서 언급된 API 가용성은 제조사 측 계획을 가리키는 것으로 KimiSeek 플랫폼과 무관하다. 또한 보도는 후보 답변의 표현, 순서 민감도, 다국어 안정성(MASSIVE는 매크로 평균과 두 언어권만 보고) 같은 세부 사항을 제시하지 않았는데, 이들은 실제 성능에 영향을 줄 수 있으므로 독자가 직접 테스트해 확인해야 한다.
원문 보도의 이미지