Underdog, 7.89GB 2비트 Qwen3.8-27B 기반 Saluki 27B 공개…도구 호출에서 원본 상회
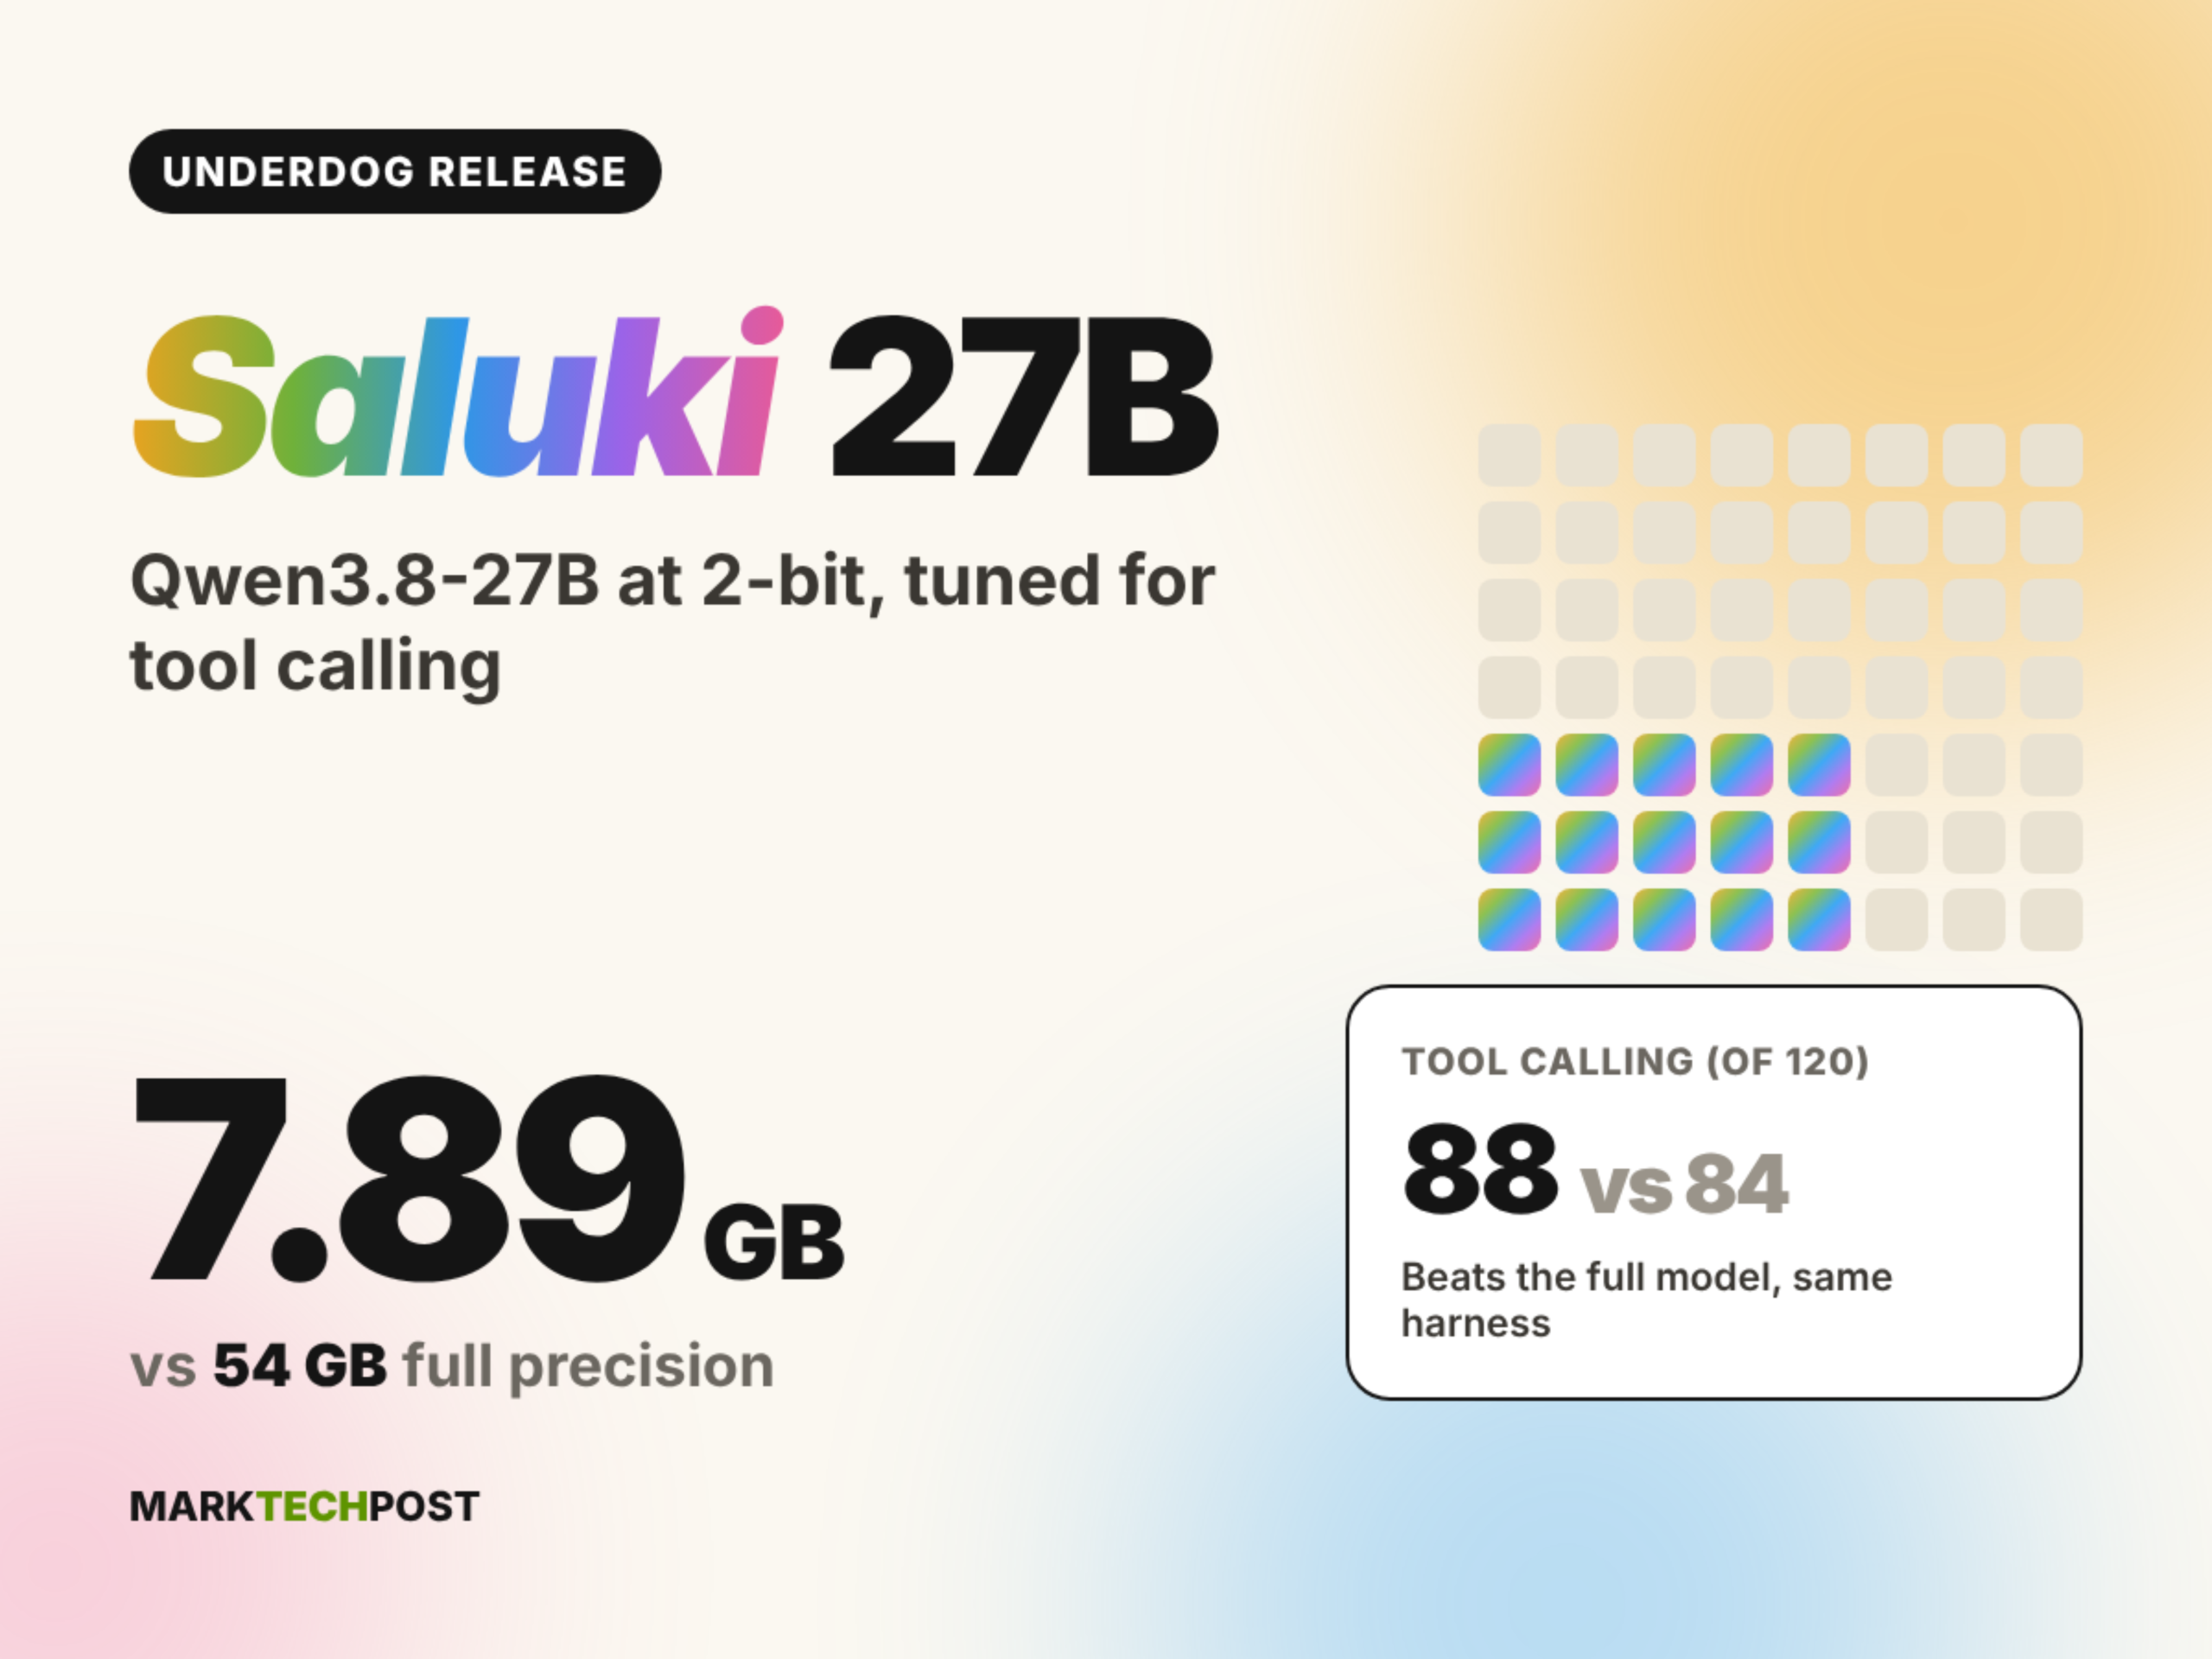
MarkTechPost가 2026년 10월 9일 보도한 바에 따르면, Conway Research 산하 Underdog는 Apache 2.0으로 Saluki 27B를 공개했다. 54GB의 Qwen3.8-27B를 7.89GB의 2비트 하이브리드 GGUF로 압축해 원본 llama.cpp에서 실행할 수 있으며, 도구 호출 점수는 원본을 앞섰지만 경쟁 수학과 다단계 추론에서는 12~18점 낮았다.
주요 변화
MarkTechPost가 2026년 10월 9일 보도한 바에 따르면, Conway Research 산하의 온디바이스 어시스턴트 프로젝트 Underdog가 Apache 2.0 라이선스로 Saluki 27B를 공개했다. 이 모델은 Qwen3.8-27B의 2비트 혼합 정밀도 GGUF 버전으로 파일 크기는 7.89GB이며, 완전한 BF16 모델은 54GB다. 보도에 따르면 그 구성에는 세 층의 작업이 겹쳐 있다. 베이스는 Qwen 팀의 27B 덴스 모델 Qwen3.8-27B(64층, 하이브리드 Gated DeltaNet 선형 어텐션과 게이티드 어텐션, 네이티브 262,144 토큰)이고, 그 위에 ISTA-DASLab의 GSQ-RCO GGUF가 있으며 최소 파일 IQ2_XS는 8.4GB, 평균 2.50비트/가중치다. Underdog는 여기에 자체 압축과 도구 호출 최적화를 더해 IQ2-mix라는 이름의 imatrix 표기 파일을 만들었지만, 보도는 Underdog가 이 단계의 완전한 레시피를 아직 공개하지 않았다고 지적했다. 실행 측면에서 보도는 이 모델이 원본 llama.cpp 및 이를 기반으로 한 애플리케이션에서 바로 실행되며 전체 GPU 오프로드를 지원하고, 629MB 또는 928MB의 선택적 비전 부가 모듈도 있다고 전했다. 벤치마크와 관련해 보도는 Underdog가 자체 보고한 두 묶음의 결과를 제시했다. 완전한 모델과 같은 프레임워크로 비교한 묶음에서 Underdog Bench(BFCL v4의 120개 태스크, 사고 모드 끔, temperature 0)는 Saluki가 88점, 완전한 모델이 84점이었고, 병렬 도구 호출은 42대 35, SWE-bench Verified 50개 이슈 중 수정은 30개 대 33개였다. 공개된 풀사이즈 점수와의 비교에서는 IFEval 93.5 대 91.5, IFBench 72.7 대 71.0, MBPP+ 78.0 대 83.9, MuSR 67.5 대 79.6, AIME 2025 79.2 대 96.7, AIME 2026 80.0 대 94.6이었다. 보도는 동시에 ISTA GSQ-RCO IQ2_XS와 PrismML Bonsai 2 27B를 대조군으로 제시했고, 각 제조사가 자체 테스트 프레임워크를 사용하므로 제조사 간 점수는 직접 비교할 수 없다고 강조했다. Bonsai 2는 부피가 더 작지만 PrismML의 llama.cpp 브랜치가 필요하다.
개발자에게 미치는 영향
로컬 에이전트가 필요한 개발자에게 이 소식의 실질적 변화는 27B급 도구 호출 모델의 가중치가 8GB 미만으로 양자화되었고, 서드파티 llama.cpp 브랜치 없이도 로드할 수 있다는 점이다. 이는 VRAM과 배포 진입 장벽에 대한 판단을 직접 바꾼다. 단일 소비자용 GPU나 대용량 메모리 머신에서의 전체 오프로드가 현실적으로 가능해지고, 로컬 에이전트 루프에 원격 모델을 백업으로 두는 하이브리드 아키텍처의 비용 계산도 더 수월해진다. 다만 공개 가중치와 라이선스 권리를 구분해야 한다. 보도는 이 파일이 Apache 2.0으로 공개되었다고 전하는데, 이는 라이선스 차원의 선언이며 상업적 사용 가능 여부는 여전히 모델 카드와 라이선스 원문으로 확인해야 한다. 가중치를 내려받을 수 있다는 것 자체가 라이선스 허용 범위를 뜻하지는 않는다. 능력 분포가 고르지 않다는 점도 더 주목해야 한다. 보도에 따르면 도구 호출과 지시 준수 계열 지표는 원본에 근접하거나 약간 높았지만, AIME, MuSR 등 수학과 다단계 추론 지표는 12~18점 하락했다. 이는 이 양자화 버전이 도구 오케스트레이션, 함수 선택, 형식 제약 계열 워크로드에 적합하고 추론 주력으로 삼기에는 부적합하다는 뜻이다. 또한 모든 점수는 Underdog 또는 그것이 인용한 제조사 자체 테스트에서 나온 것이며 제조사마다 테스트 프레임워크가 달라, 독립 재현이 아닌 전달된 주장으로 보아야 하고 모델 간 순위는 비교 불가로 취급해야 한다. 보도는 가중치당 비트 수, 컨텍스트 길이, 압축 레시피를 공개하지 않았으며, 이러한 미지 항목은 긴 컨텍스트와 배치 동시성 환경에서의 실제 성능에 영향을 준다.
연동 및 평가 제안
제안 1(도구 호출 라우팅): Saluki 27B를 로컬 에이전트의 함수 선택과 파라미터 생성 계층으로 쓸지는 워크로드가 병렬 도구 호출과 구조화 출력 중심인지에 달려 있다. 단일 턴이나 소수 병렬 호출, 엄격한 응답 형식이 필요한 시나리오라면 보도에서 병렬 도구 호출과 지시 준수 계열 지표가 원본에 근접하거나 초과한다고 했으므로 로컬 실행을 우선 고려할 수 있다. 긴 사슬의 다단계 계획에 의존하는 워크로드라면 보도에서 MuSR과 AIME가 뚜렷이 하락했다고 했으므로 원본이나 더 강한 모델을 백업으로 남겨야 한다. 측정 가능한 평가 기준은 자체 도구 스키마에서 동일한 고정 태스크 묶음을 Saluki와 원본(또는 기존 온라인 모델)에 실행해 도구 이름 선택 정확도, 파라미터 JSON 유효 비율, 병렬 호출 시나리오의 태스크 완료율을 비교하는 것이다. 제안 2(압축 방식 선정): 마찬가지로 2비트 구간에 속하는 후보들 중에서 선택하는 일은 비원본 런타임을 유지할 의향이 있는지에 달려 있다. 보도에 따르면 Saluki는 원본 llama.cpp에서 실행할 수 있지만 PrismML Bonsai 2는 자체 llama.cpp 브랜치가 필요하며, 이는 빌드, 업그레이드, CI 복잡도에 직접 영향을 준다. 또한 보도는 Saluki가 가중치당 비트 수와 컨텍스트를 공개하지 않았고, 대조 방식은 2.50비트/가중치와 파일 크기를 공개했다고 전했다. 팀이 추론 프레임워크 분기를 원하지 않는다면 원본 llama.cpp 로드 가능을 하드 전제로 두고 부피와 정밀도를 비교하면 된다. 부피가 최우선 제약이라면 브랜치 유지 비용을 감수해야 한다. 측정 가능한 평가 기준은 동일한 대상 머신에서 첫 토큰 지연, VRAM 피크, 실제 최대 입력 길이에 가까운 긴 컨텍스트에서의 안정성을 기록하고, 해당 파일 로드에 필요한 llama.cpp 버전 요구사항을 확인하는 것이다. 제안 3(양자화 후 검수): 어느 쪽을 택하든 벤치마크 점수가 아니라 양자화 후에도 엔드투엔드 태스크를 완수하는지를 출시 기준으로 삼아야 한다. 측정 가능한 평가 기준은 실제 온라인 트래픽 표본으로 수정 계열 태스크 통과 수, 도구 호출 라운드 수, 실패 재시도율을 비교하고, 예컨대 엔드투엔드 태스크 통과율이 원본 대비 허용 가능한 일정 비율 아래로 떨어지면 자동으로 되돌리는 등 명확한 롤백 임계값을 설정하는 것이다. 이상은 조건부 분석과 제안이며 보도에 나온 사실 진술이 아니다.
제한과 확인할 사항
먼저 분명히 해야 한다. 보도에 나온 Saluki 27B(Qwen3.8-27B의 2비트 GGUF 파생 버전)는 현재 KimiSeek 모델 카탈로그에 존재하지 않는다. 해당 보도에서 말한 배포 방식은 Hugging Face 등 채널에서 GGUF 가중치를 받아 원본 llama.cpp에서 로컬 실행하는 것이며, KimiSeek 플랫폼상의 API 가용성과는 무관하다. API 가용성에 관한 어떤 언급도 배포 주체 자체 채널을 가리킨다. 둘째, 본문의 모든 벤치마크 숫자는 Underdog의 자체 테스트와 그것이 인용한 공개 점수를 전달한 것으로 배포 주체의 진술에 속하며, 본문은 독립 재현을 하지 않았다. 보도 자체도 각 제조사가 자체 테스트 프레임워크를 사용하므로 제조사 간 점수는 직접 비교할 수 없다고 밝히고 있다. 셋째, 보도는 해당 파일의 가중치당 비트 수, 컨텍스트 길이, 세 번째 압축 단계의 완전한 레시피를 공개하지 않았으므로 긴 컨텍스트, 배치 동시성, 다양한 하드웨어에서의 성능은 여전히 미지다. 넷째, 가중치가 Apache 2.0으로 공개되었다는 것은 보도에 나온 라이선스 선언이며, 구체적 상업 조건 충족 여부는 모델 카드와 라이선스 원문을 기준으로 해야 한다. 가중치 확보가 허용 범위를 명확히 하는 것은 아니다. 마지막으로 Qwen3.8-27B 베이스의 능력 서술(64층, 하이브리드 어텐션, 262,144 네이티브 컨텍스트) 역시 해당 보도에서 나온 것이며 본문에서 검증하지 않았다.