Aleph Alpha lança Kolibri de pesos abertos: MoE de 78,1 bilhões de parâmetros com 3,46 bilhões ativados por token
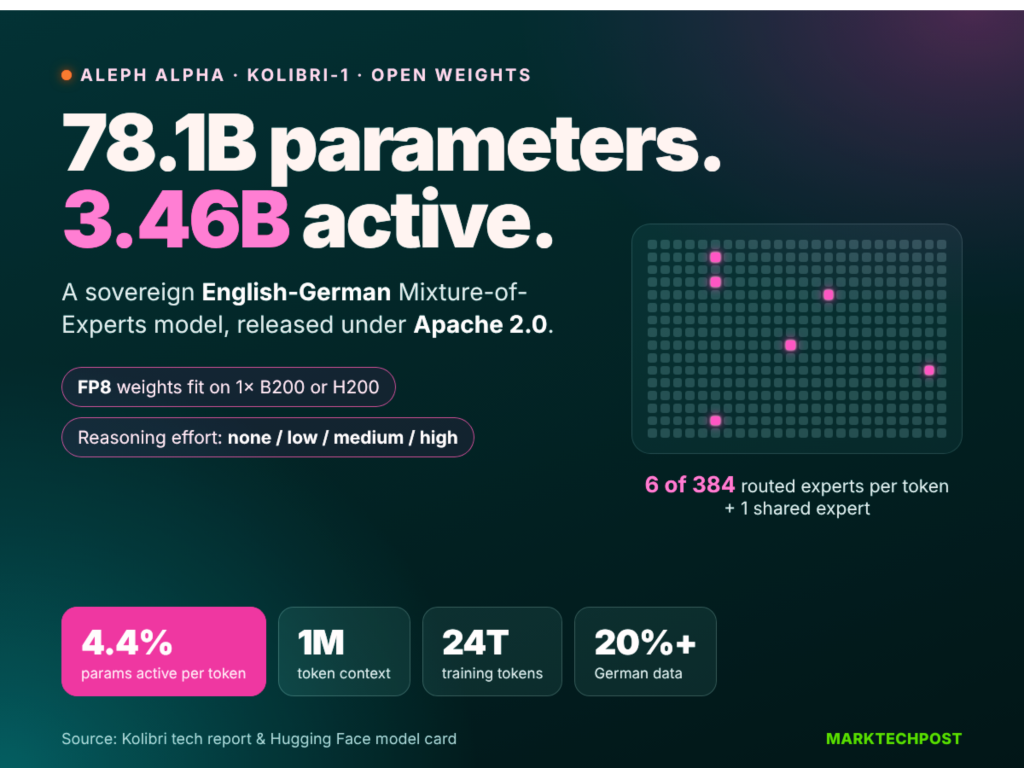
Segundo o MarkTechPost, em 4 de outubro de 2026, a Aleph Alpha lançou o Kolibri-1, um modelo MoE de pesos abertos bilíngue (inglês-alemão), com 78,1 bilhões de parâmetros totais e apenas 3,46 bilhões ativados por token, suporte a contexto de até 1.048.576 tokens e quatro níveis de esforço de raciocínio, publicado no Hugging Face sob licença Apache 2.0, com checkpoint FP8 de cerca de 78 GB, servível com vLLM em uma única B200 ou H200.
O que mudou
Segundo o MarkTechPost, em 4 de outubro de 2026, a equipe alemã Aleph Alpha lançou o modelo de pesos abertos Kolibri (Kolibri-1), posicionado como um modelo de linguagem de mistura de especialistas (MoE) bilíngue em inglês e alemão, voltado para implantação soberana em setores regulados como administração pública, indústria e aeroespacial. A reportagem afirma que o total de parâmetros é de 78,1 bilhões, com apenas 3,46 bilhões ativados por token (cerca de 4,4%): cada camada MoE usa um roteador sigmoide para escolher top 6 entre 384 especialistas roteados, mais 1 especialista compartilhado, com balanceamento de carga via Exact Quantile Balancing e Load-Error Injection. O modelo empilha 50 blocos Transformer, largura 2560, atenção de consulta agrupada com 48 cabeças de consulta e 4 cabeças KV; cada quinto bloco é de atenção completa sem codificação posicional, e os outros 40 blocos usam atenção de janela deslizante cobrindo os 512 tokens anteriores com RoPE, de modo que apenas 10 camadas de cache KV crescem com o contexto. O limite de contexto reportado é de 1.048.576 tokens, e o esforço de raciocínio pode ser definido por requisição como nenhum, baixo, médio ou alto. No treinamento, a reportagem afirma que o pré-treinamento cobriu 20T tokens em 768 GPUs NVIDIA B200, o treinamento intermediário 3,44T tokens (comprimento de sequência 65.536), a fase de contexto longo 201B tokens (comprimento de sequência 262.144), com mais de 2T tokens adicionais em alemão; o pós-treinamento combinou ajuste fino supervisionado e aprendizado por reforço em mais de 1,2 milhão de tarefas internas. A licença é Apache 2.0, com pesos publicados no Hugging Face; o checkpoint FP8 tem cerca de 78 GB e pode ser servido em uma única B200, B300 ou H200, ou em duas H100 SXM5, via vLLM com parser de inferência e parser de chamada de ferramentas dedicados. As comparações de benchmark da reportagem mostram 75,5 no geral em inglês e 70,8 em alemão, com 61,4 no BFCL v4, abaixo do Qwen3.5 comparado. Esses detalhes de parâmetros, benchmarks e implantação são todos reproduções da reportagem original e do relatório técnico, ainda sem reprodução independente.
Impacto para desenvolvedores
Do ponto de vista do desenvolvedor, o valor desta notícia concentra-se em três pontos. Primeiro, a combinação de licença e auto-hospedagem: a reportagem afirma que os pesos foram publicados sob licença Apache 2.0, o que oferece um espaço de autorização mais claro do que a prática comum de "pesos abertos com restrições comerciais", mas os termos da licença devem ser verificados no texto original do cartão do modelo e do repositório no Hugging Face, sem inferir direitos apenas pela paráfrase da reportagem; note também que a disponibilidade dos pesos não significa que os dados de treinamento, o tokenizador ou o pacote de inferência estejam sob a mesma licença. Segundo, a estrutura de custos trazida pela esparsidade: 78,1 bilhões de parâmetros totais e 3,46 bilhões ativados significam que o consumo de memória é calculado pelos parâmetros totais, enquanto o custo computacional é calculado pelos parâmetros ativados; a reportagem afirma que o checkpoint FP8 de cerca de 78 GB pode rodar em uma única B200/H200, o que é um ponto de partida viável de auto-hospedagem para equipes que já têm nós de alto VRAM com placa única, mas a vazão real e a concorrência ainda dependem da largura de banda de memória, da precisão do cache KV e do tamanho do lote, exigindo testes próprios. Terceiro, atenção híbrida e contexto de um milhão: as camadas de janela deslizante mantêm o cache KV fixo e apenas 10 camadas crescem com o contexto; a equipe afirma que, com o mesmo poder computacional, é possível suportar sequências 4 vezes mais longas do que uma solução de atenção completa; se isso se confirmar, a economia de contexto para documentos longos e RAG industrial será claramente melhor do que a de modelos densos de porte semelhante; mas isso é uma declaração do fabricante e precisa ser verificado na própria distribuição de documentos quanto ao contexto efetivo, não apenas pelo número do limite. Além disso, o posicionamento bilíngue inglês-alemão e o tokenizador otimizado para alemão (a reportagem afirma 4,90 bytes por token em alemão, cerca de 11,2% menos tokens do que o tokenizador comparado) indicam que sua vantagem está no alemão; negócios predominantemente em chinês não devem inferir capacidade em chinês a partir disso, pois a reportagem não fornece avaliação em chinês. É importante deixar claro: até esta verificação de catálogo, a versão Kolibri-1 não aparece no catálogo de modelos em tempo real do KimiSeek, portanto a disponibilidade de pesos e serviço de inferência mencionada na reportagem refere-se ao lançamento da Aleph Alpha e do Hugging Face, e não a algo já disponível neste site.
Integração e avaliação
O que segue são recomendações e análises condicionais, não fatos comprovados. Recomendação 1: decida primeiro com base em licença e conformidade, depois em desempenho. A escolha prática é verificar o arquivo LICENSE do repositório no Hugging Face, as restrições de uso no cartão do modelo e a licença do próprio pacote de inferência aleph-alpha-inference, antes de decidir se ele entra como dependência de produção. Quando a carga de trabalho envolve processamento local de dados regulados e a equipe dispõe de nós com VRAM de nível B200/H200 única, a auto-hospedagem tem mais valor do que chamar APIs externas; se esse pré-requisito não for atendido (por exemplo, apenas GPUs de consumo ou várias placas de VRAM média/baixa), abandone segundo critérios quantificáveis: o limiar de aprovação é carregar com sucesso o checkpoint FP8 no hardware alvo e produzir saída estável; falha no carregamento ou necessidade de expansão de VRAM além do orçamento significa não avançar para a próxima rodada. Recomendação 2: antes de trocar ou introduzir o modelo, faça uma avaliação comparativa com os modelos atuais usando seu próprio corpus em alemão ou misto inglês-alemão. As variáveis-chave selecionáveis são o nível de esforço de raciocínio (nenhum/baixo/médio/alto) e a precisão do cache KV, pois isso altera diretamente o custo e a latência por requisição; quando a tarefa é extração de documentos longos e a tolerância à latência da resposta é alta, aumentar o esforço de raciocínio pode trazer ganho de qualidade, enquanto em tarefas de perguntas e respostas curtas de alta concorrência, esforço baixo com lotes maiores é mais vantajoso. O critério de avaliação deve ser mensurável: em um conjunto fixo de 200 a 500 perguntas e respostas sobre documentos longos em alemão, compare a acurácia e a latência ponta a ponta por mil tokens em cada nível; só adote um nível mais alto se o ganho de acurácia superar o aumento de latência e custo. Recomendação 3: a capacidade de contexto longo deve ser validada pela "janela efetiva", não pelo limite. A escolha prática é começar com o contexto padrão de 262.144 e depois abrir gradualmente para janelas maiores ajustando max-model-len e sobrescrevendo max_position_embeddings; o pré-requisito é que a tarefa realmente exija dependências contínuas de até um milhão de tokens; se os resultados de recuperação da tarefa já forem menores que cem mil tokens, abrir o limite só aumentará o custo do cache KV. O critério quantificável é medir a taxa de recall de informações-chave em gradientes de comprimento (por exemplo, 32k, 128k, 512k); se houver queda acentuada em determinado comprimento, use os comprimentos abaixo desse como limite prático. Recomendação 4: cenários de chamada de ferramentas e agentes devem ser testados sob carga separadamente. A reportagem afirma que a pontuação no BFCL v4 é inferior à do modelo Qwen comparado, enquanto a média agêntica é próxima à do concorrente, indicando que a diferença pode ser grande entre subtarefas agênticas; a escolha prática é manter o modelo atual como cadeia principal de chamada de ferramentas e usar o Kolibri para recuperação e geração em alemão, ou o inverso. O pré-requisito é que a equipe já tenha um conjunto de testes de regressão para chamada de ferramentas; o critério quantificável é a taxa de sucesso de chamadas e a taxa de acerto de parâmetros no próprio schema de ferramentas; se for significativamente inferior ao modelo em uso, não migre a cadeia principal.
Limites e pontos a confirmar
Primeiro, é preciso deixar claro: até esta verificação de catálogo, o Kolibri-1 não aparece no catálogo de modelos em tempo real do KimiSeek; os pesos, o pacote de inferência e o modo de implantação descritos neste artigo referem-se ao lançamento da Aleph Alpha e do Hugging Face e não indicam que este site já oferece o modelo; qualquer menção à disponibilidade de API na reportagem também se refere apenas ao lado do fabricante e não deve ser entendida como serviço deste site. Segundo, todos os números de arquitetura, treinamento, benchmark e implantação deste artigo vêm da reportagem do MarkTechPost de 4 de outubro de 2026 e do relatório técnico e cartão de modelo por ela reproduzidos, sem reprodução independente; as comparações de benchmark usam configurações de avaliação próprias do fabricante, e a comparabilidade horizontal entre modelos é limitada, não devendo ser a única base para escolha. Terceiro, a reportagem não fornece detalhes de validação independente para chinês, código ou cenários de contexto longo; a capacidade em idiomas além do posicionamento bilíngue inglês-alemão é desconhecida; a afirmação de "4 vezes o comprimento de sequência com o mesmo poder computacional" é uma declaração da equipe e precisa ser verificada por conta própria. Quarto, o Apache 2.0 é uma declaração de licença para os pesos publicados; o escopo específico de aplicação (pesos, tokenizador, pacote de inferência, dados de treinamento) deve ser verificado item a item na licença original e no cartão do modelo, não se podendo derivar de "pesos abertos" a autorização de todos os componentes. Quinto, poder rodar em uma única placa e ser utilizável em produção são coisas diferentes; a concorrência de pico, a margem de VRAM e o impacto dos níveis de esforço de raciocínio no custo precisam ser medidos no hardware alvo. Sexto, preços, limites e parâmetros de amostragem recomendados na reportagem são informações do momento do lançamento e podem mudar com versões posteriores; consulte o conteúdo mais recente nas páginas do fabricante e do Hugging Face.