Cantina lança apex-flash-1: modelo de pesquisa de vulnerabilidades com pesos abertos ajustado a partir do GLM-5.3-Flash resolve 40 de 60 tarefas reservadas
Segundo o MarkTechPost, em 4 de outubro de 2026, a Cantina Security, em conjunto com a Yeta Labs, lançou o modelo de pesos abertos apex-flash-1, ajustado por GRPO sobre o GLM-5.3-Flash e publicado no Hugging Face sob licença MIT, com resultados auto-relatados de 40 de 60 tarefas de vulnerabilidade em dados reservados e cerca de 640 GB de memória de GPU para os pesos em BF16.
O que mudou
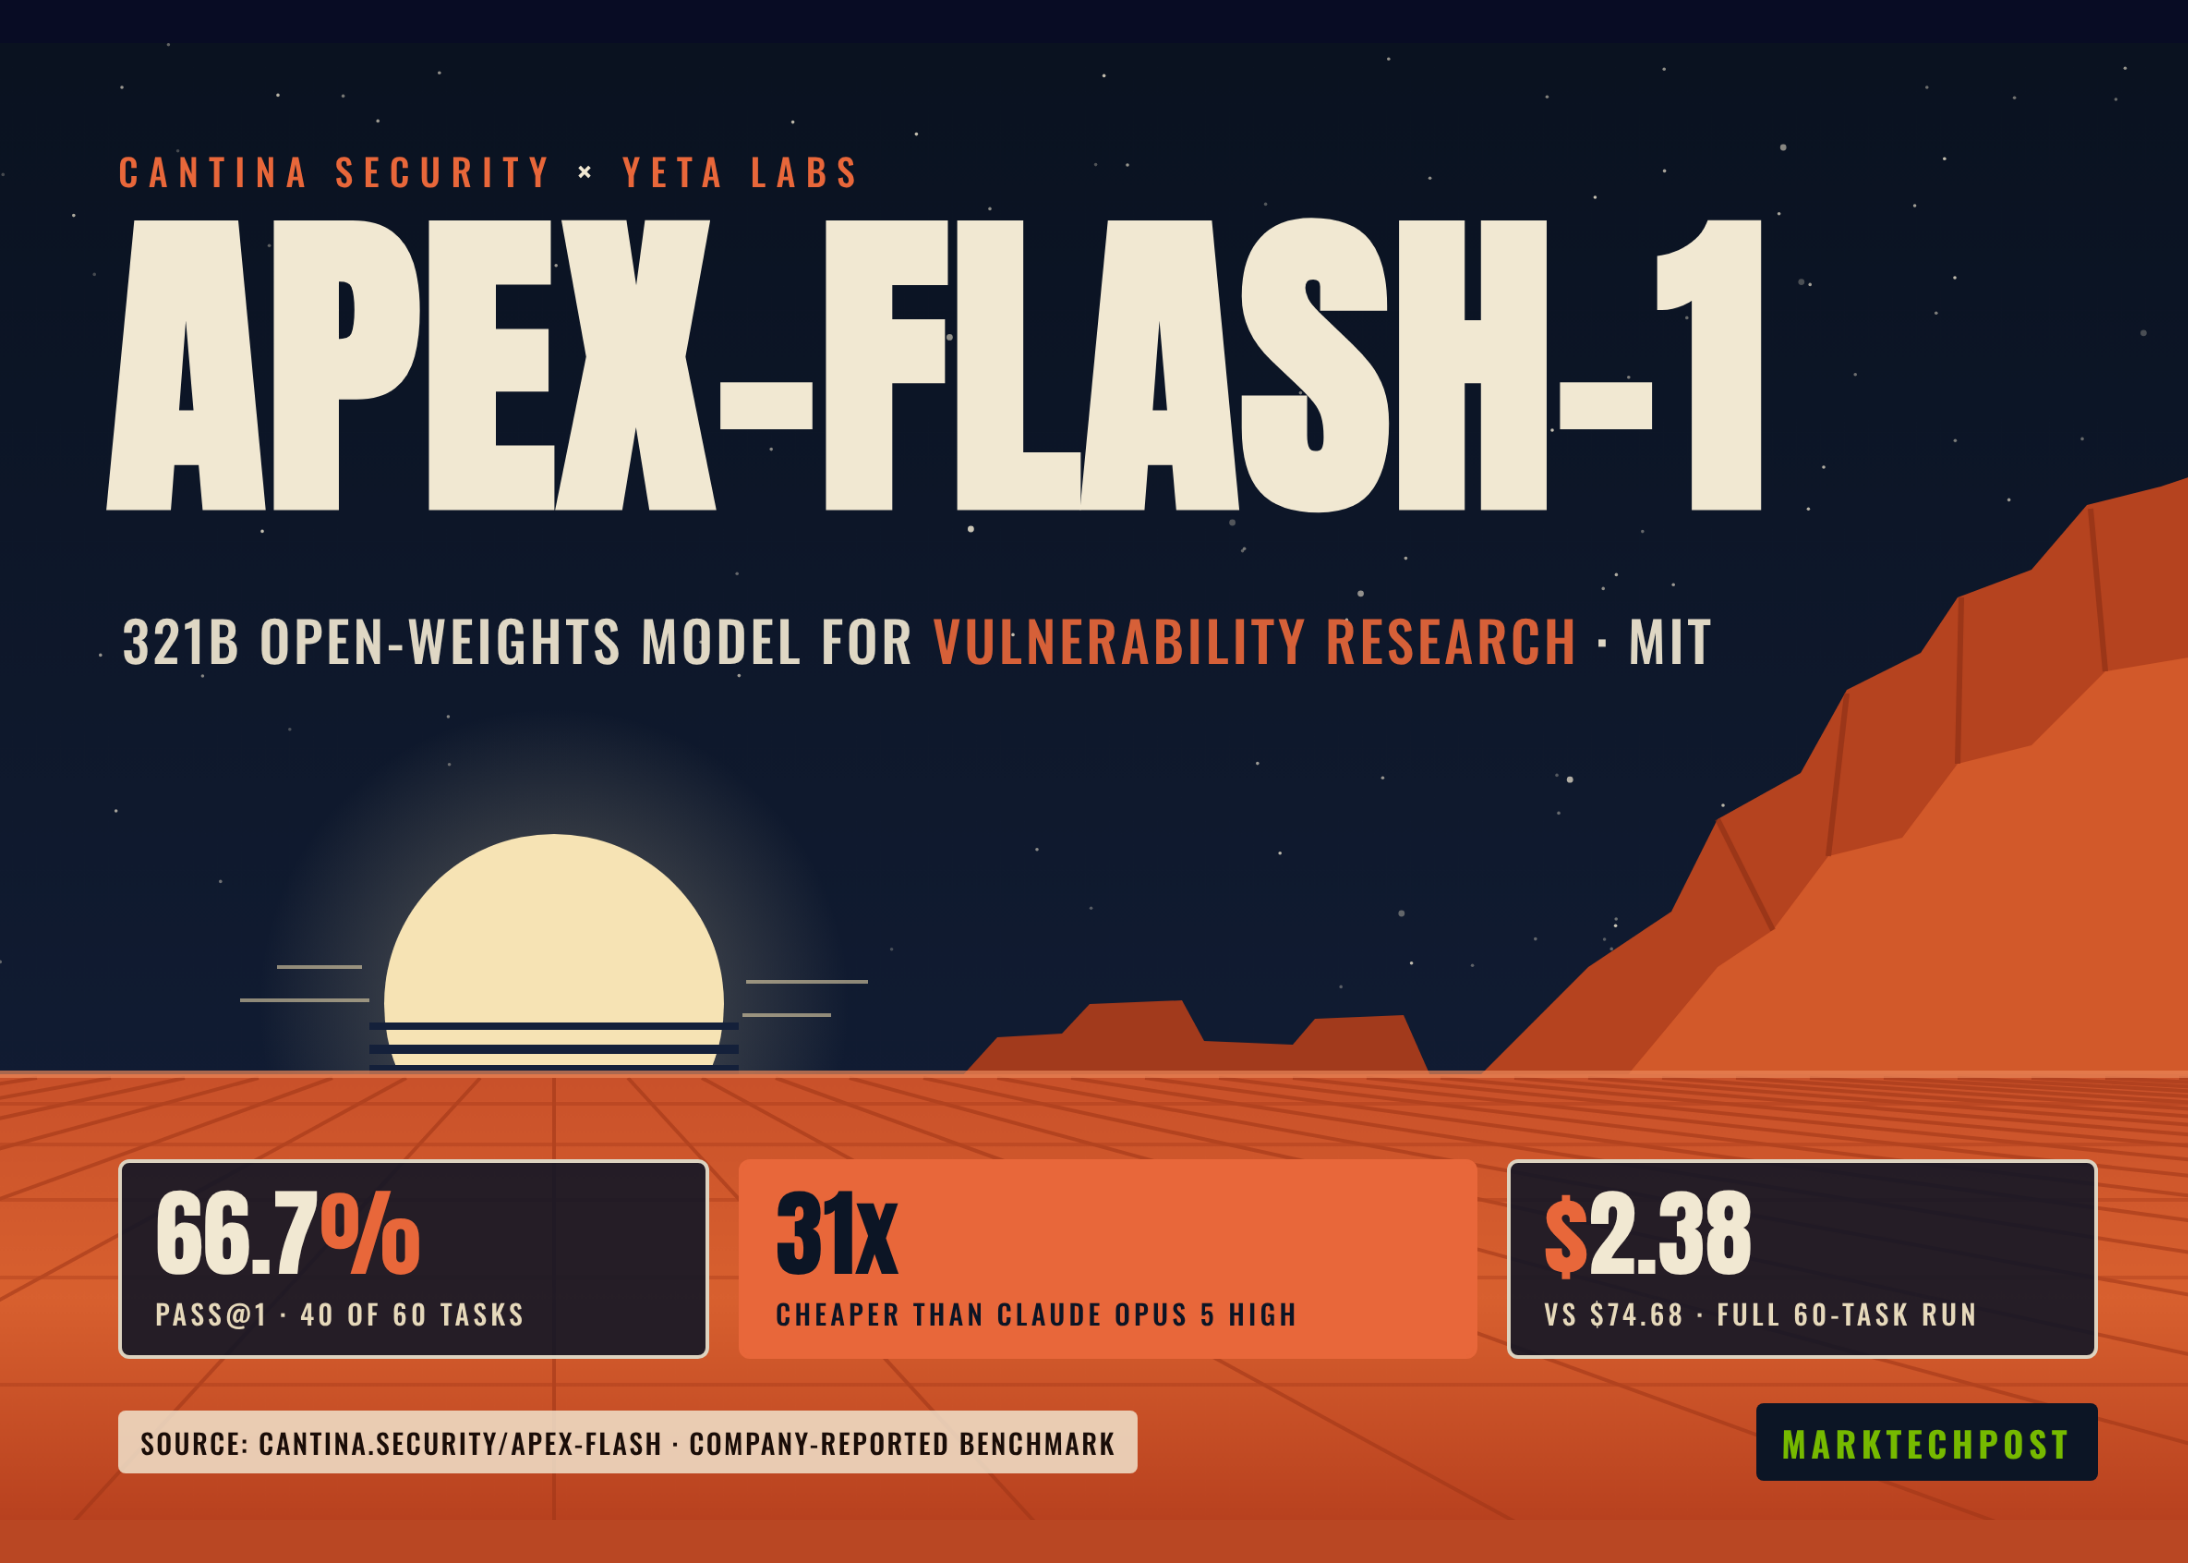
Segundo o MarkTechPost, em 4 de outubro de 2026, a Cantina Security, em conjunto com a Yeta Labs, lançou o apex-flash-1. O modelo é o produto de um ajuste fino por aprendizado por reforço sobre o GLM-5.3-Flash da Z.ai (MoE, cerca de 320 bilhões de parâmetros totais e 18 bilhões ativados), com pesos publicados no Hugging Face sob licença MIT. A reportagem afirma 321,3 bilhões de parâmetros totais e o uso de GRPO, LoRA com rank 256 e treinamento seletivo de todos os parâmetros. Os dados consistem em 150 tarefas derivadas de 50 casos reais de vulnerabilidade, cada caso com três variantes: caixa branca guiada, caixa branca focada e caixa preta focada. Entre os tipos de caso, falhas de autorização, identidade e escopo de permissão representam 72%, contabilidade e precisão numérica 18%, e o restante envolve validação temporal, regras de negócio e SSRF. A reportagem cita o cartão do modelo ao afirmar que o rollout é executado no harness de agente Codex. Na avaliação, a Cantina selecionou 60 tarefas de 20 casos reservados e executou cada modelo uma vez: o apex-flash-1 resolveu 40 de 60 (66,7% pass@1, cerca de 2,38 dólares), o GLM-5.3-Flash base 36 de 60 (60,0%, cerca de 4,56 dólares) e o Claude Opus 5 High 43 de 60 (71,7%, cerca de 74,68 dólares). A reportagem também menciona uma variante experimental apex-flash-1-abliterated, com comportamento de recusa modificado e sem avaliação separada. A Cantina o posiciona como um modelo de trabalho orquestrado por modelos maiores, voltado a cenários de defensores com implantação local sob controle próprio. Cabe notar que os benchmarks e custos acima são dados internos auto-relatados pelo fornecedor.
Impacto para desenvolvedores
O impacto para desenvolvedores pode ser dividido em três camadas. A primeira é a fronteira de licença e uso: a reportagem afirma que os pesos foram publicados sob licença MIT, o que é diferente de “os pesos são baixáveis” — MIT é um termo de licença, com caminho relativamente claro para uso comercial e redistribuição, mas ainda é preciso consultar a LICENSE e o NOTICE do repositório oficial, pois a reportagem não detalha se há uma política de uso separada. A segunda é a estrutura de custo de implantação: a reportagem afirma que os pesos em BF16 exigem cerca de 640 GB de memória de GPU, o que não é uma escala suportada por uma única placa; a auto-hospedagem exige nós multi-GPU ou portes quantizados. A reportagem menciona que a comunidade já tem um porte de 4 bits, mas não fornece avaliação de qualidade: o efeito da quantização em tarefas de exploração de vulnerabilidade é uma incógnita e exige comparação própria. A terceira é a adequação à tarefa: 72% dos dados de treinamento se concentram em falhas de autorização, identidade e escopo de permissão, e o desempenho nesses tipos de tarefa não pode ser extrapolado para vulnerabilidades de segurança de memória, concorrência, criptografia ou cadeia de suprimentos; a avaliação deve ser estratificada por categoria de falha, não apenas pelo pass@1 total. Além disso, a reportagem posiciona o modelo como um “modelo de trabalho” orquestrado por modelos maiores, sugerindo que sua forma de integração esperada é uma etapa de execução em um harness de agente, e o grau de alinhamento da interface e do protocolo de chamada de ferramentas afetará diretamente a usabilidade. Quanto ao estado atual do catálogo: o apex-flash-1 não tem correspondência exata no catálogo ao vivo do KimiSeek; se for necessário chamar seu modelo base GLM-5.3-Flash, há uma entrada com o mesmo nome no catálogo, mas a informação do catálogo apenas indica a disponibilidade de chamada atual e não serve como evidência dos benchmarks, preços ou pesos da reportagem.
Integração e avaliação
O que segue são recomendações e análises condicionais, não afirmações factuais da reportagem. Recomendação 1: faça primeiro uma comparação de amostra pequena por categoria de falha antes de decidir se vale investir em auto-hospedagem. A mudança concreta na reportagem é que 72% dos dados de treinamento se concentram em falhas de autorização/identidade/escopo de permissão; a decisão correspondente é escolher o apex-flash-1 ou o GLM-5.3-Flash base, e a premissa é se a tarefa-alvo cai nessas categorias; o critério mensurável é comparar a diferença de pass@1 entre os dois em 20 a 30 tarefas de autorização reservadas próprias; se o ganho for inferior a cerca de 5 pontos percentuais, não vale assumir o custo operacional extra de uma implantação multi-GPU. Recomendação 2: estabeleça um limiar de taxa de sucesso de chamada de ferramentas para a integração com agentes. A reportagem afirma que o rollout é executado no harness de agente Codex e lista leitura de código, chamada de ferramentas, desenvolvimento de exploração de vulnerabilidade e validação como capacidades-alvo; a decisão correspondente é usá-lo como executor no agente, não como planejador, e a premissa é que o schema de ferramentas do seu harness seja próximo do ambiente de treinamento dele; o critério mensurável é medir a taxa de formato válido e a taxa de conclusão ponta a ponta em 50 chamadas reais de ferramentas; se a taxa de formato válido for inferior a cerca de 95%, adicione uma camada de validação de saída antes de integrar. Recomendação 3 (condicional): se a memória de GPU for insuficiente, escolher ou não o porte comunitário de 4 bits. A reportagem menciona que já existe um porte de 4 bits, mas sem dados de qualidade; a decisão correspondente é a escolha entre esperar pela quantização oficial e adotar o porte comunitário, e a premissa é se sua tarefa é mais sensível à precisão numérica ou à vazão; o critério mensurável é executar o mesmo conjunto de 60 tarefas antes e depois da quantização e comparar a queda no número de resoluções; se a queda ultrapassar 3 a 5 tarefas, ele não é adequado para substituir diretamente o BF16 em validação automatizada de vulnerabilidades.
Limites e pontos a confirmar
Todos os dados de benchmark (66,7% pass@1, 40/60, cerca de 2,38 dólares etc.) são resultados internos auto-relatados pela Cantina, com amostra de 20 casos reservados e 60 tarefas no total, escala pequena e distribuição de tipos de tarefa não divulgada integralmente, sem reprodução por terceiros. A reportagem não divulga as regras de pontuação da avaliação, se múltiplas tentativas eram permitidas nem o critério de “resolvido”, e o pass@1 pode ter significados diferentes em implementações distintas. A variante apex-flash-1-abliterated não foi avaliada separadamente, e o impacto da mudança no comportamento de recusa sobre a segurança é totalmente desconhecido. Quanto aos requisitos de hardware, o corpo da reportagem afirma cerca de 640 GB, a tabela lateral cerca de 642 GB e a tabela de parâmetros afirma BF16 328 GB; há inconsistências entre esses números, e na escolha deve-se usar como referência o tamanho real dos arquivos de peso do repositório oficial; o porte comunitário de 4 bits não tem dados de qualidade. Quanto à verificação de catálogo deste ciclo, a versão apex-flash-1 não aparece atualmente no catálogo ao vivo do KimiSeek; qualquer disponibilidade de API ou custo de chamada mencionado neste texto aponta para o fornecedor ou serviços de terceiros e não representa chamada direta nesta plataforma; seu modelo base GLM-5.3-Flash tem uma entrada com o mesmo nome no catálogo, mas essa informação de catálogo reflete apenas a disponibilidade de chamada atual e não constitui corroboração dos benchmarks ou preços da reportagem. A data da reportagem é 4 de outubro de 2026, e as comparações de custo e conclusões nela contidas são temporais e não devem ser consideradas o estado atual; para informações de preço, consulte a página oficial de preços.