EmbeddingGemma 2: lançamento de pesos abertos com 740 milhões de parâmetros em espaço compartilhado de 768 dimensões, código e recuperação de áudio como novas variáveis
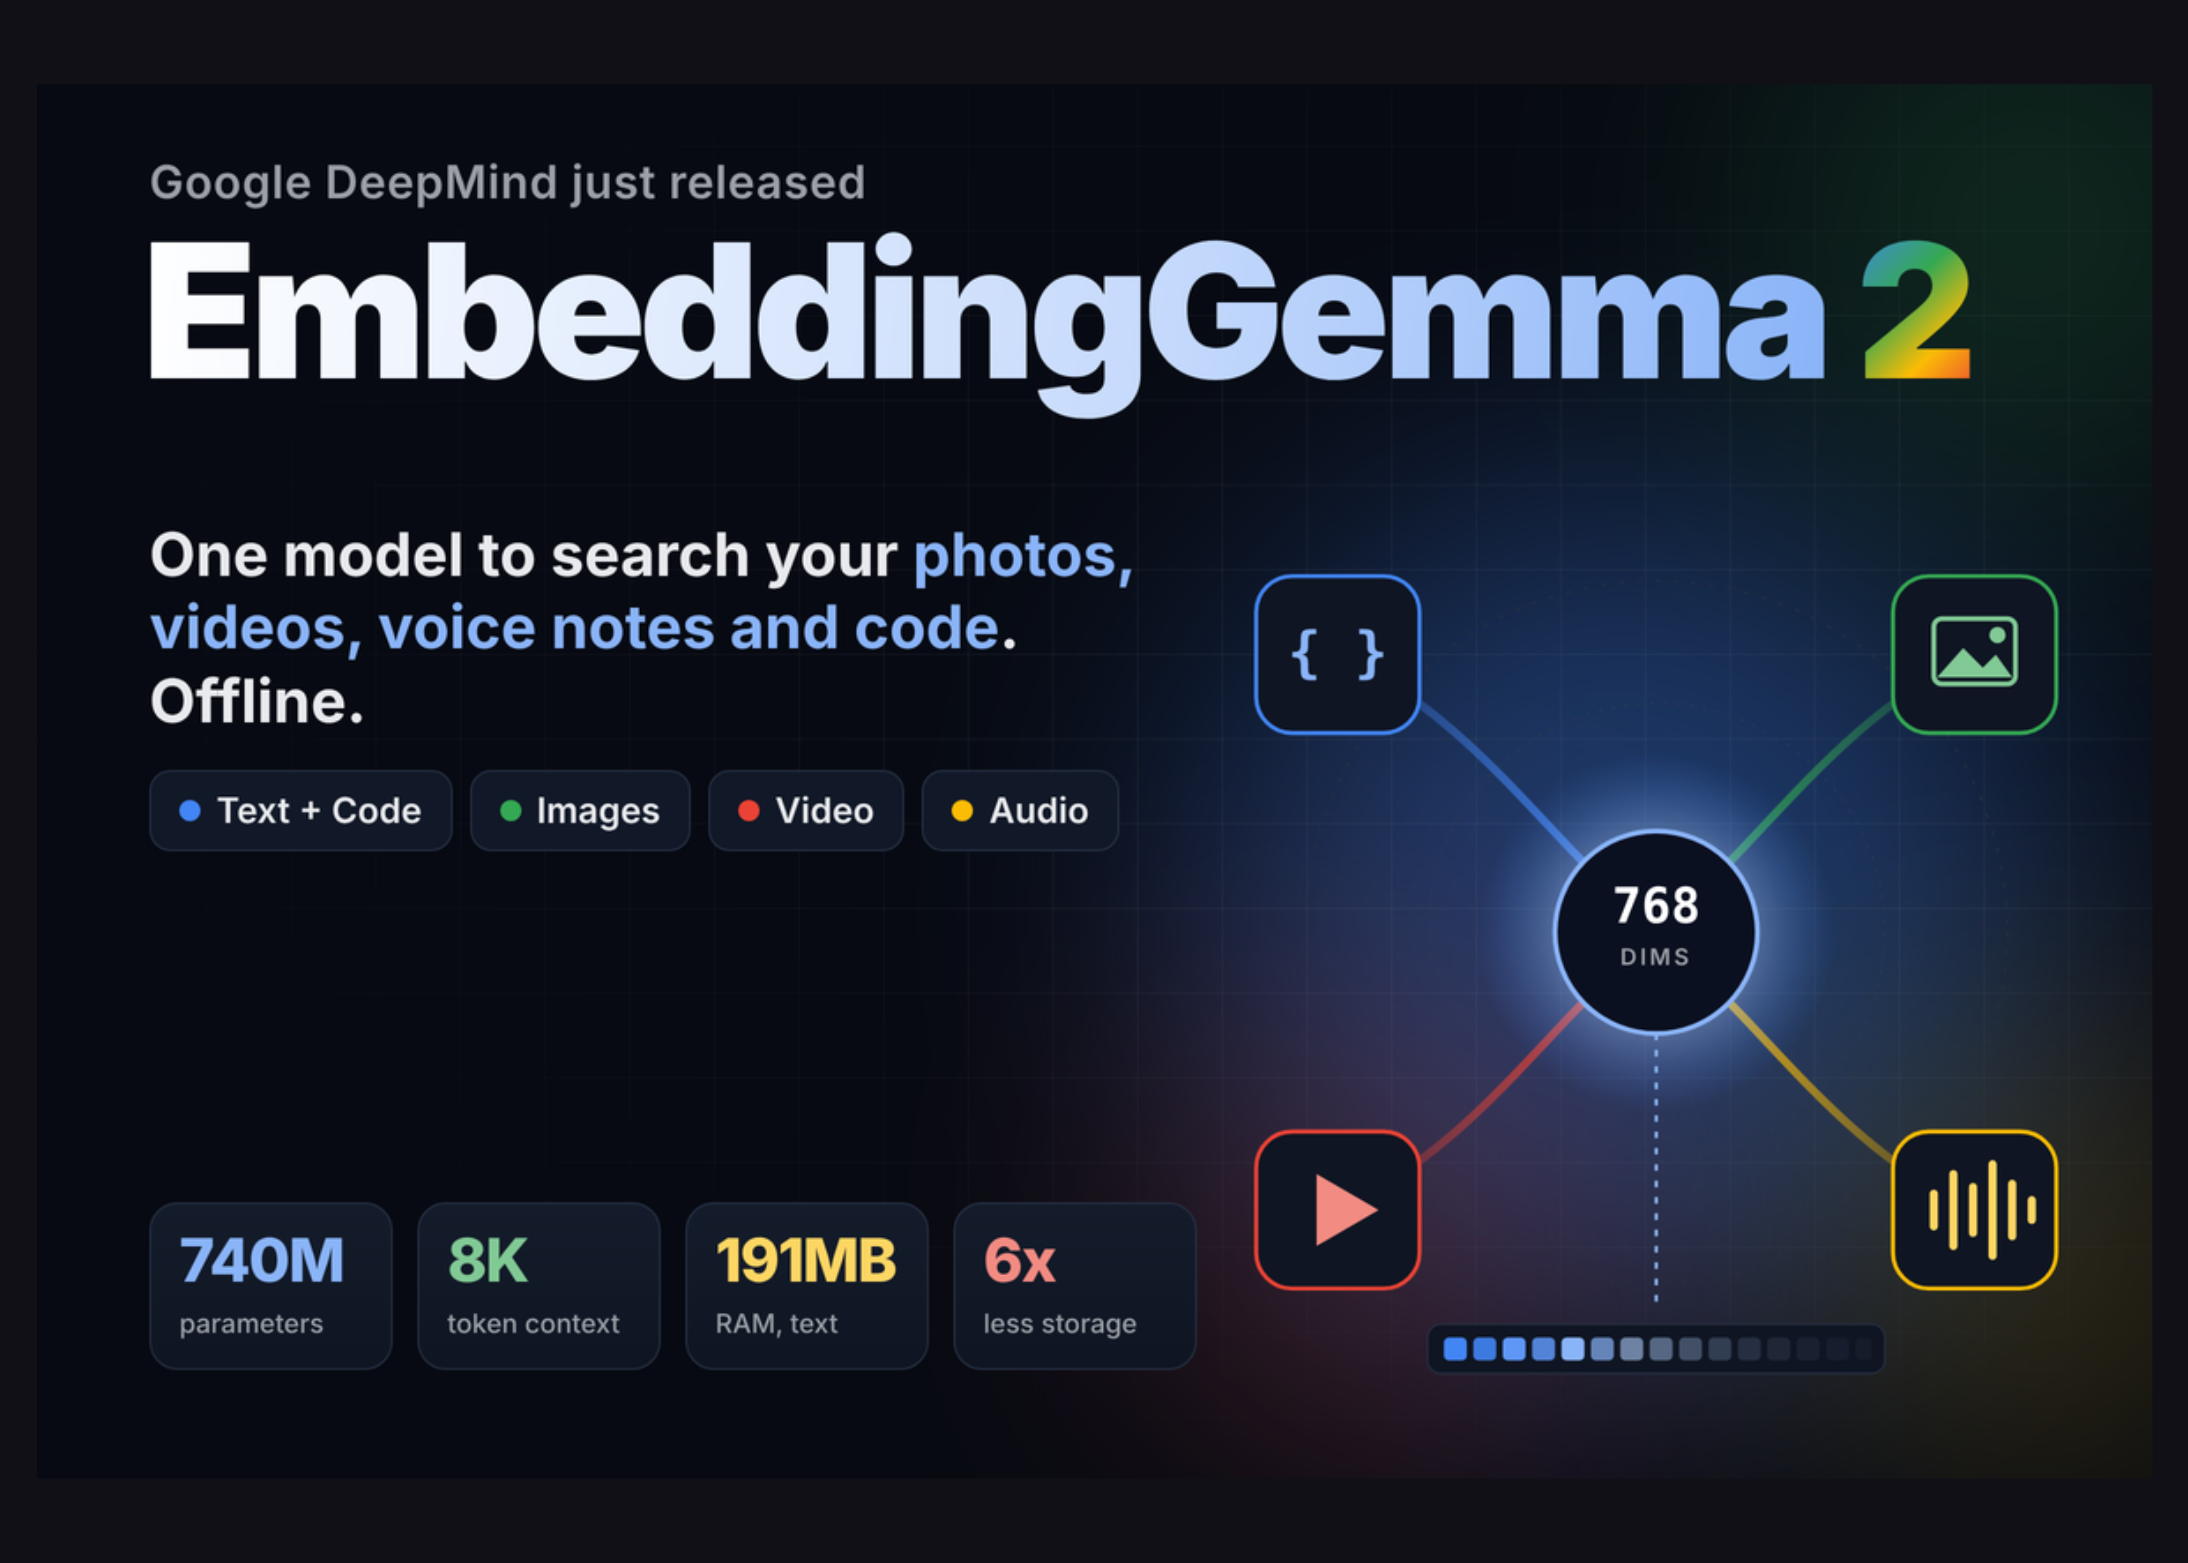
Segundo o MarkTechPost, em 6 de outubro de 2026, o Google DeepMind lançou o EmbeddingGemma 2, um modelo de embedding multimodal de pesos abertos com 740 milhões de parâmetros, contexto de 8K e licença Apache 2.0, que mapeia texto, código, imagens, vídeo e áudio no mesmo espaço de 768 dimensões. O backbone de texto, com 270 milhões de parâmetros, pode ser carregado separadamente.
O que mudou
Segundo o MarkTechPost, em 6 de outubro de 2026, o Google DeepMind lançou o EmbeddingGemma 2, um modelo de embedding multimodal de pesos abertos baseado na arquitetura Gemma 4 e sob licença Apache 2.0. Ele usa codificadores modulares para mapear diferentes modalidades no mesmo espaço vetorial de 768 dimensões: o backbone de texto e código tem cerca de 270 milhões de parâmetros (130 milhões de transformer mais 140 milhões de embedder), o codificador visual de 170 milhões de parâmetros é opcional, o codificador de áudio de 300 milhões de parâmetros é opcional, e o carregamento completo soma cerca de 740 milhões de parâmetros, podendo o desenvolvedor carregar apenas as partes necessárias. A janela de contexto é de 8192 tokens, o que a reportagem afirma ser o quádruplo da primeira geração, comportando cerca de 29 imagens, 58 quadros de vídeo ou 5,5 minutos de áudio. Segundo o model card, o MTEB Code v1 subiu de 68,76 na geração anterior para 78,68, o MTEB multilingual v2 foi de 61,15 para 61,36, e foram adicionadas métricas como MIEB lite de imagem 64,64, pontuação total MMEB v2 de 59,01 e MAEB de áudio 49,39. A reportagem afirma que os pesos já estão no Hugging Face e no Kaggle, com formas de execução em Ollama, llama.cpp GGUF, LiteRT, sentence-transformers v6.1.0+, vLLM, SGLang, MLX, LM Studio e MediaPipe, armazenamento vetorial com suporte do Qdrant e ajuste fino com suporte do Unsloth; o MRL permite truncar vetores para 512, 256 e 128 dimensões.
Impacto para desenvolvedores
Para os desenvolvedores, a mudança principal deste lançamento não é o número de parâmetros, mas o fato de o mesmo espaço vetorial cobrir ao mesmo tempo código e áudio, além da possibilidade de carregar apenas o backbone de texto. Isso altera diretamente três tipos de decisão de escolha. Primeiro, a camada de recuperação do RAG multimodal costumava exigir dois modelos de embedding, dois índices e lógica de normalização de pontuações para texto e imagem; a reportagem afirma que vetores de consulta gerados por uma configuração somente texto podem corresponder a vetores de documentos gerados pelo modelo completo, e, se isso for reproduzível, seria possível indexar primeiro com o backbone de 270 milhões de parâmetros e depois adicionar codificadores visuais ou de áudio conforme necessário sem reconstruir a base. Segundo, o aumento no benchmark de recuperação de código (cerca de 9,92 pontos, aproximadamente 14%, segundo a reportagem) coloca o modelo na lista de candidatos para busca semântica em repositórios de código, mas esses são números do model card do fornecedor, não equivalem ao desempenho em repositórios próprios. Terceiro, ele forma um trade-off diferente com o Qwen3-VL-Embedding-2B da Alibaba: segundo a reportagem, este último reporta 73,2 pontos em seu próprio teste MMEB v2, tem cerca de 2,7 vezes mais parâmetros e não suporta áudio; já o EmbeddingGemma 2 enfatiza contexto de 8K, memória em dispositivo e suporte a áudio. É preciso notar que pesos abertos não equivalem a licença de código aberto sem restrições: a Apache 2.0 é uma licença permissiva, mas a origem dos dados de treinamento no relatório do modelo e os requisitos de conformidade a jusante ainda precisam ser verificados por conta própria. Além disso, o catálogo atual de modelos do KimiSeek não tem nenhum item chamado EmbeddingGemma 2, e essa versão não está disponível no KimiSeek; a disponibilidade mencionada na reportagem refere-se a canais externos como Hugging Face, Kaggle e Ollama, e, caso haja oferta futura em forma de API, ela também deve seguir a página do respectivo fornecedor.
Integração e avaliação
O que segue são sugestões e análises condicionais, não fatos da reportagem. Sugestão um: primeiro determine se você precisa de recuperação entre modalidades. Se houver apenas texto em chinês e código, e você já usa um modelo de embedding de texto maduro, trate o EmbeddingGemma 2 como candidato para teste A/B, não como substituição imediata; faça primeiro experimentos de recuperação com o mesmo conjunto de consultas e documentos próprios, avaliando com Recall@10 e nDCG@10, em vez de olhar apenas para a pontuação MTEB. Se a carga de trabalho realmente incluir texto com imagens ou recuperação de memorandos de voz, vale priorizar a verificação da hipótese de espaço vetorial compartilhado: construa a base com o backbone de texto de 270 milhões de parâmetros e depois use o modelo completo para gerar embeddings do mesmo conjunto de documentos com texto e imagem, medindo a consistência de similaridade entre configurações; se a ordenação de relevância divergir claramente, será preciso criar índices separados para cada configuração. Sugestão dois: o trade-off entre dimensão e armazenamento. A reportagem afirma que em 256 dimensões o MTEB multilingual cai apenas de 61,36 para 60,41, enquanto em 128 dimensões o MMEB cai para 45,65, e a recomendação oficial é usar 128 dimensões principalmente para texto puro. Se o gargalo for o custo de armazenamento do banco vetorial e o cenário for texto puro, teste primeiro a mudança para 256 dimensões; se envolver recuperação de imagens ou vídeo, mantenha 768 dimensões e compare a diferença de recall entre 256 e 768 dimensões nos seus próprios dados, definindo um limite aceitável de perda de recall antes de decidir. Sugestão três: risco de aprisionamento na pilha de implantação. Há muitas pilhas de execução possíveis; na escolha, guie-se pelo seu objetivo de servidor ou de dispositivo, e registre na configuração a dimensão do vetor, o template de prompt (os nomes de prompt SearchQuery e Document citados na reportagem) e o método de quantização, rodando um conjunto de regressão fixo antes e depois da quantização para comparar diferenças de recall. Na avaliação, use sempre dados próprios da empresa, não rankings públicos, pois a qualidade multilíngue ficou basicamente estável na reportagem e os ganhos se concentram em código e nas novas modalidades.
Limites e pontos a confirmar
Os números de benchmark, uso de memória e latência acima vêm do model card do Google ou de afirmações da própria equipe de pesquisa, sendo relatos do fornecedor, sem reprodução independente por terceiros; os 191MB e 567MB em dispositivo são memória ativa após quantização em hardware específico (Pixel 11 Pro) e não podem ser extrapolados diretamente para outros hardwares. A reportagem não divulga a composição dos dados de treinamento nem detalhes da distribuição de idiomas, e o desempenho real em cenários em chinês precisa ser verificado por conta própria. Na comparação entre modelos, os 73,2 pontos do Qwen3-VL-Embedding-2B seguem o critério autorreportado no próprio MMEB v2, e comparações parciais e pontuações de rankings diferentes não podem ser comparadas diretamente. Além disso, a versão EmbeddingGemma 2 não aparece atualmente no catálogo de modelos do KimiSeek, portanto este artigo não a considera um modelo disponível no KimiSeek; a publicação dos pesos, o download via Ollama e os diversos suportes de runtime mencionados na reportagem referem-se a lançamentos de fornecedores ou da comunidade em canais externos, e a disponibilidade e eventuais preços futuros devem seguir as páginas oficiais das respectivas plataformas. A reportagem menciona que o suporte ao ML Kit para Android será lançado em algumas semanas, o que é um plano e não um fato consumado, não devendo servir de base para cronogramas.
Ilustrações da notícia original