GLM 5.3 chega ao Amazon Bedrock: MoE de 753B em API gerenciada, cache explícito de prompt e inferência entre regiões como focos de integração
Segundo o blog oficial da AWS, em 5 de outubro de 2026, o GLM 5.3 da Z.ai está disponível no Amazon Bedrock para clientes empresariais elegíveis, podendo ser chamado via Responses/Chat Completions compatíveis com OpenAI e Invoke/Converse do Bedrock, com suporte a cache de prompt implícito e explícito, configurações de inferência entre regiões US e Global, e um caminho para invocá-lo com o agente de pentest open source Strix.
O que mudou
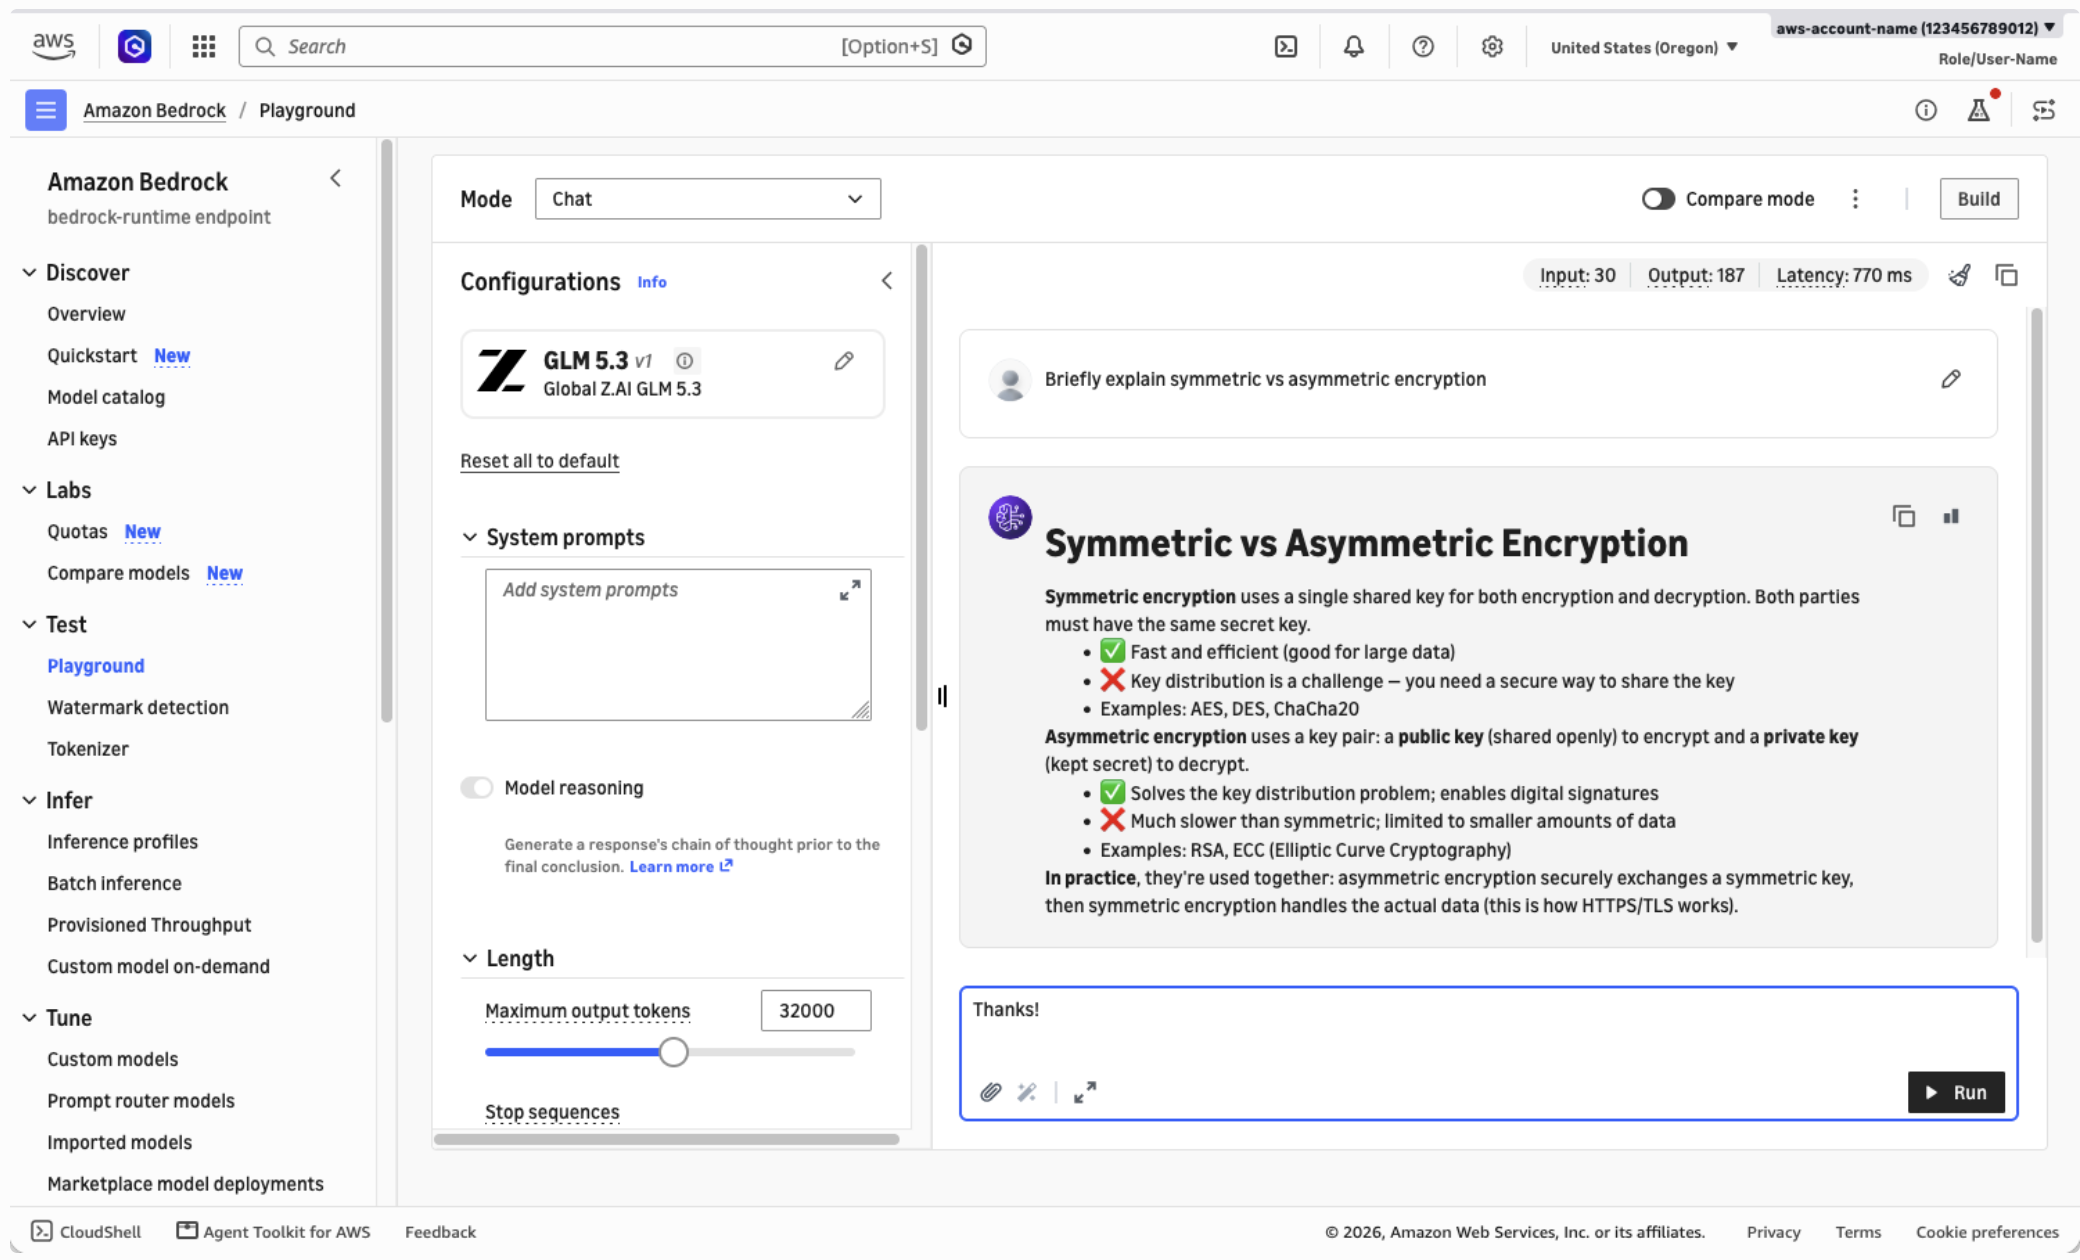
Segundo o blog oficial da AWS, em 5 de outubro de 2026, o GLM 5.3 da Z.ai (Zhipu AI) foi disponibilizado no Amazon Bedrock, aberto a clientes empresariais elegíveis. O texto afirma que, conforme informações publicadas no Hugging Face Hub, o GLM 5.3 é um modelo de mistura de especialistas (MoE) com 753 bilhões de parâmetros, otimizado para codificação e tarefas de agentes de longa duração, e que a Z.ai relata desempenho destacado em tarefas de segurança, com 84,5 pontos no benchmark CyberGym no lançamento. Em comparação com o GLM 5, que chegou ao Bedrock no início do ano, o texto lista três mudanças: a Z.ai afirma que ele é competitivo em benchmarks de codificação como DeepSWE, Terminal Bench 3.0 e FrontierSWE, e que supera o GLM 5.2 em 50% em um benchmark interno de codificação, mas não fornece comparação direta com o GLM 5 porque os próprios benchmarks foram atualizados desde o GLM 5.1; a capacidade de segurança é descrita como "emergente"; e a integração com o Bedrock é mais completa. Quanto ao acesso, o modelo pode ser chamado pelo endpoint bedrock-runtime com as APIs Responses e Chat Completions compatíveis com OpenAI, e também com Invoke e Converse do Bedrock; a AWS recomenda que novas aplicações priorizem a API compatível com OpenAI e usem credenciais de curta duração em vez de chaves de API de longa duração. O modelo é oferecido por dois perfis de inferência entre regiões, us.zai.glm-5.3 e global.zai.glm-5.3, e em três níveis de serviço: Flex, Priority e Standard.
Impacto para desenvolvedores
Para desenvolvedores que avaliam caminhos de hospedagem de modelos chineses, a mudança substancial deste evento não está em "um modelo mais forte", mas na complementação da superfície de chamada e dos meios de controle de custo. Primeiro, o Bedrock oferecer simultaneamente interface compatível com OpenAI e Invoke/Converse nativos significa que as mudanças em código existente do SDK da OpenAI se concentram em base_url, forma de autenticação (usar aws-bedrock-token-generator para trocar credenciais da AWS CLI por um token de curta duração) e identificador do modelo, em vez de reescrever a camada de chamada; para equipes que já têm várias adaptações compatíveis com OpenAI, o custo de migração está principalmente em credenciais e roteamento, não na lógica de negócio. Segundo, o cache explícito de prompt é marcado pela AWS como "recomendado", e para cargas de agentes que reenviam a cada turno o prompt de sistema, definições de ferramentas ou arquivos de repositório isso afeta diretamente o custo de tokens de entrada e a latência do primeiro token, tornando a taxa de acerto do cache uma métrica de engenharia observável. Terceiro, os perfis de inferência entre regiões desacoplam "para qual região a requisição é enviada" de "onde ela é realmente processada", e clientes empresariais precisam reexaminar residência de dados e critérios de conformidade, em vez de presumir execução local. Quarto, a documentação do Strix atualmente usa o GLM 5.3 como modelo padrão e pode apontar para o Bedrock, o que coloca a inferência de cargas altamente sensíveis, como testes de segurança, sob o controle da própria conta AWS, uma opção relevante para equipes de segurança, mas que envolve escopo de autorização e julgamento de conformidade e não equivale simplesmente a "pronto para uso". Vale notar que as descrições acima vêm apenas do blog unilateral da AWS e de benchmarks autorreportados pela Z.ai, sem verificação independente reproduzida.
Integração e avaliação
Recomenda-se avaliar segundo as regras condicionais abaixo, que são julgamentos baseados na fonte e não conclusões comprovadas. Primeiro, trocar ou não para a interface compatível com OpenAI: se a aplicação existente já se baseia no SDK da OpenAI e precisa do conjunto completo de recursos de cache explícito, segundo a AWS deve-se priorizar a API Responses compatível com OpenAI; se o código existente está profundamente ligado ao Bedrock Converse ou precisa compartilhar a camada de chamada com outros modelos do Bedrock, manter a interface nativa exige menos mudanças. O pré-requisito é que a conta tenha as permissões bedrock:InvokeModel, bedrock:InvokeModelWithResponseStream e bedrock:CallWithBearerToken. O critério mensurável é rodar dois turnos de conversa com o mesmo prompt de sistema longo, verificar se input_tokens_details.cached_tokens na resposta é diferente de zero e comparar a cobrança de tokens de entrada e a diferença de latência do primeiro token entre os dois turnos. Segundo, ativar ou não o cache explícito: se a carga reenvia a cada turno grandes blocos de contexto estático (prompt de sistema, definições de ferramentas, trechos de repositório), a fonte recomenda mudar para o modo explicit de prompt_cache_options e marcar prompt_cache_breakpoint; se o contexto é curto ou muda com frequência, o cache implícito basta e não vale o custo de manter marcações. O pré-requisito é que cada ponto de quebra tenha pelo menos 1.024 tokens para ter elegibilidade de cache, pois marcar prompts curtos é ineficaz. O critério mensurável é a proporção de tokens com acerto de cache sob a mesma carga e a queda de latência ponta a ponta, confirmando que a divisão dos pontos de quebra não quebra fronteiras semânticas. Terceiro, qual perfil de inferência entre regiões escolher: equipes voltadas a usuários dos EUA ou com requisitos de conformidade na região us avaliam us.zai.glm-5.3, e quem precisa de cobertura mais ampla avalia global.zai.glm-5.3, com a escolha baseada em requisitos de residência de dados e latência medida, e não na adoção padrão do "global". O critério mensurável é a latência P50/P95 de requisições originadas na região de origem alvo, além da conclusão escrita da revisão de conformidade sobre a região de processamento. Quarto, nível de serviço: para tarefas insensíveis como processamento em lote e análise offline, avaliar Flex para otimizar custo; para requisições sensíveis a latência, como assistentes de codificação interativos, avaliar Priority, com Standard como linha de base padrão. O pré-requisito é que a escolha de nível altera o preço unitário, então é essencial verificar a cobrança atual no console. Em qualquer caso, primeiro faça uma comparação em pequena escala com seu próprio código e trajetórias reais de agentes, em vez de substituir diretamente o modelo padrão de produção.
Limites e pontos a confirmar
Esta versão GLM 5.3 ainda não aparece no catálogo em tempo real do KimiSeek, e a disponibilidade no Bedrock, os identificadores de modelo e os critérios de cobrança mencionados aqui vêm da AWS e da Z.ai e não representam a oferta no KimiSeek. O catálogo do KimiSeek tem outras entradas, como GLM-5.3, GLM-5.3 Flash e GLM-5.2, que são versões ou canais de oferta diferentes, e não se pode inferir a partir delas que a versão do Bedrock descrita aqui esteja disponível no KimiSeek. As afirmações de desempenho da fonte, incluindo CyberGym 84,5, o ganho de 50% em benchmark interno de codificação sobre o GLM 5.2 e as expressões de "competitividade" em DeepSWE, Terminal Bench 3.0 e FrontierSWE, são autorreportadas pela Z.ai ou reproduzidas pela AWS, sem reprodução independente, e as versões dos benchmarks foram atualizadas desde o GLM 5.1, então comparações laterais exigem cautela. A AWS afirma explicitamente que o GLM 5.3 é voltado a "clientes empresariais elegíveis", e a fonte não esclarece se contas comuns podem ativá-lo diretamente nem se todas as regiões estão disponíveis. O texto original também menciona que o LiteLLM, naquele momento, ainda não conseguia resolver bedrock/global.zai.glm-5.3, exigindo especificar explicitamente a rota Converse e o ARN do perfil de inferência, uma limitação conhecida da época cuja correção posterior é desconhecida. A afirmação de que o Strix usa o GLM 5.3 como modelo padrão vem de uma descrição de documentação "até o momento da redação" e pode ter mudado. Preços e valores unitários por nível mudam com o tempo; consulte as páginas de preços em tempo real da AWS e do KimiSeek. Os exemplos de teste de segurança se aplicam apenas a aplicações próprias ou com autorização escrita, e o conteúdo da fonte foi truncado no trecho sobre o AWS Continuum.
Ilustrações da notícia original