“Super Brain” 3.0 da JD Logistics afirma reduzir o planejamento de rotas para segundos: cinco modelos industriais, sem menção a pesos públicos ou API
Segundo um artigo do InfoQ China publicado em 6 de novembro de 2026, a JD Logistics atualizou o grande modelo “Super Brain” para a versão 3.0 e afirma que o tempo de resolução do planejamento de rotas ótimas para centenas de milhões de pacotes caiu de minutos para segundos. O sistema é composto por cinco modelos nativos de cadeia de suprimentos — PreX, OptiX, OmniX, GeoX e EmbodiedX — e cobre mais de 3.600 armazéns e mais de 600 mil funcionários, com taxa de despacho automatizado de veículos de 86%. O artigo não menciona pesos públicos, licença de código aberto ou interface que terceiros possam chamar diretamente.
O que mudou
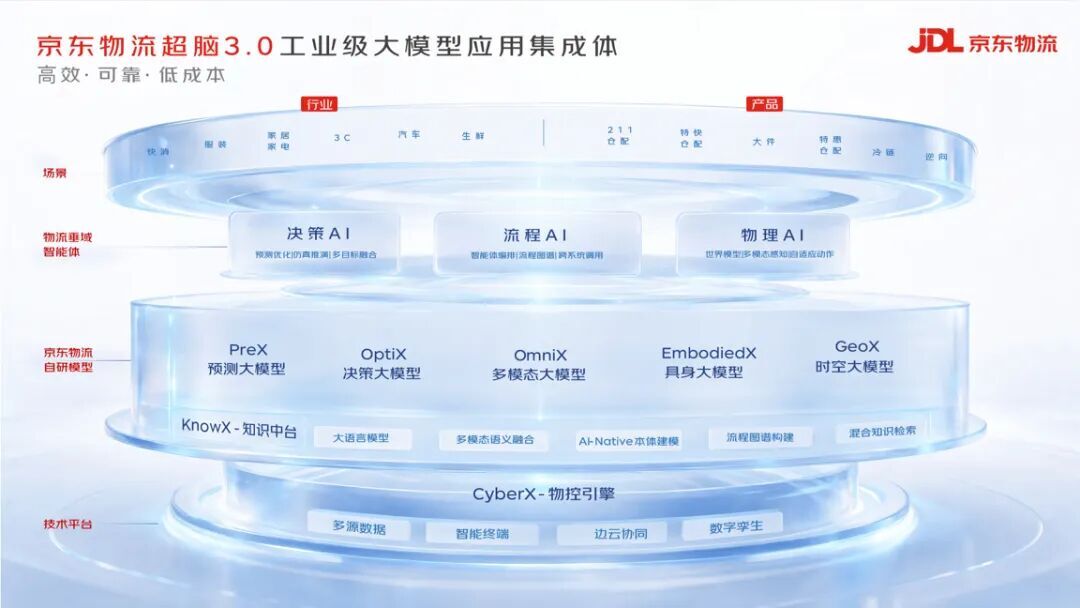
Segundo um artigo publicado pelo InfoQ China em 6 de novembro de 2026, o grande modelo “Super Brain” da JD Logistics foi atualizado para a versão 3.0, descrita no artigo como um conjunto integrado de aplicações de grande modelo de nível industrial em que toda a operação, do armazém à entrega, é comandada por IA. Em comparação com a versão 2.0, o artigo afirma que a 3.0 tem maior eficiência operacional, maior resiliência do sistema e menor custo operacional, além de reduzir o tempo de resolução do planejamento de rotas ótimas de ponta a ponta para centenas de milhões de pacotes de minutos para segundos. O sistema é composto por cinco modelos nativos de cadeia de suprimentos: o PreX prevê mudanças de demanda e oferta a partir de dados dinâmicos multidimensionais; o OptiX combina otimização operacional, aprendizado por reforço e capacidades de modelos generativos para resolver soluções globais sob restrições de rede de armazéns, estoque, transporte, pessoal e equipamentos; o OmniX compreende de forma unificada imagens, vídeos, espaço e objetos; o GeoX coloca endereços, localizações, rotas e tempo em um sistema de coordenadas espaço-temporais unificado; e o EmbodiedX converte percepção e decisão em ações executáveis por robôs. O artigo descreve esse conjunto como a tríade de IA de decisão, IA de processo e IA física: a camada de decisão modela de forma unificada pedidos, estoque, rede de armazéns, veículos, condições de trânsito, clima, além de informações como imagens, vídeos e localização; a camada de processo integra os dados dos sistemas de armazenagem, transporte, triagem e entrega, unifica as definições de pessoas, mercadorias, veículos, armazéns, pedidos e equipamentos, e então decompõe as decisões em tarefas executáveis que são distribuídas, acompanhadas e tratadas em caso de exceção; a camada física é operada pelo motor de controle de materiais CyberX, que aciona os robôs “Zhilang”, os braços mecânicos de triagem “Yilang” e os veículos de entrega autônomos “Dulang”, que executam e devolvem resultados, formando um ciclo fechado de percepção, previsão, decisão, execução e retroalimentação. Outros números citados no texto incluem: cobertura de mais de 3.600 armazéns e mais de 600 mil funcionários; taxa de despacho automatizado de veículos de 86%; ganho de eficiência de 13,8% nas operações dos funcionários de armazém; o serviço de cadeia de suprimentos de ponta a ponta “Jinghui”, voltado a comerciantes, que afirma atingir em média mais de 80% de cumprimento no prazo de entrega no dia seguinte, além de sugerir automaticamente recomendações de reposição e executar transferências; o “Yilang” já opera 24 horas em vários parques logísticos, com validação acumulada de captura e empilhamento de mais de dez milhões de pacotes reais; e o “Dulang” já foi testado em várias regiões do país e na Arábia Saudita. O artigo também afirma que essas capacidades estão sendo abertas para os setores de manufatura e varejo.
Impacto para desenvolvedores
Primeiro, é preciso separar o verificável do não verificável. Os números acima vêm todos da narrativa da JD Logistics; o artigo não informa o número de parâmetros dos modelos, o volume de dados de treinamento, a metodologia dos testes de referência, o hardware de inferência ou a janela temporal das estatísticas, nem menciona pesos abertos, licença de código aberto, model card ou API pública para terceiros. Para desenvolvedores, isso se parece mais com um resumo operacional de um sistema de uso próprio do que com um modelo que possa ser baixado, hospedado ou chamado por token. A definição dos indicadores também deixa lacunas. “Segundos” não especifica se é média ou latência de cauda, nem em que escala de pedidos, com qual limite de tempo de resolução e em qual hardware foi medido; a taxa de despacho automatizado de veículos de 86% não deixa claro se o denominador é toda a frota ou apenas veículos que atendem a certas condições; o ganho de eficiência de 13,8% dos funcionários não tem grupo de controle nem período estatístico. Esses números operacionais são mais adequados como alegações do fornecedor a serem verificadas do que como expectativas de desempenho que possam ser extrapoladas diretamente para o próprio negócio. O que realmente tem valor de transferência é a divisão arquitetural, não os números específicos: separar previsão, resolução de restrições, percepção multimodal, cognição espaço-temporal e controle físico em módulos independentes e, antes da orquestração, alinhar as definições de entidades entre sistemas por meio de uma camada de processo. Essa ordem resolve o problema de “a decisão é calculável, mas não é executável”. O custo também é claro: uma camada a mais de unificação semântica significa uma camada a mais de objetos de mapeamento e pontos de falha a manter no longo prazo, e só compensa quando os dados estão de fato dispersos em sistemas heterogêneos. Há também uma ambiguidade em “aberto para os setores”: o artigo não esclarece se é entregue como produto, SDK, API ou projeto sob medida, nem lista condições de integração e forma de cobrança. O item de formato externo mais claro no texto é o “Jinghui”, voltado a comerciantes, mas ele é um serviço de cadeia de suprimentos, não uma interface de modelo; a integração significa entregar pedidos, estoque, rede de armazéns e dados de cumprimento ao fornecedor e validar item por item conforme o cenário do próprio comerciante.
Integração e avaliação
A seguir há análises e recomendações condicionais, não fatos declarados no artigo. Equipes que pretendem integrar grandes modelos à cadeia de despacho ou orquestração podem começar com experimentos comparativos em pequena escala seguindo as duas abordagens do artigo. Primeiro, a IA de processo unifica as definições de pessoas, mercadorias, veículos, armazéns, pedidos e equipamentos antes de orquestrar tarefas, e isso merece verificação separada. A escolha a fazer é: adicionar ou não uma camada de semântica unificada de entidades e regras antes da sua camada de orquestração de agentes. A premissa é que os dados estejam de fato dispersos em vários sistemas e que o mesmo objeto de negócio tenha definições inconsistentes em etapas diferentes; se houver apenas uma fonte de dados, essa camada só acrescentará latência e superfície de manutenção. O critério de aceitação testável é executar o mesmo lote de ordens de serviço históricas em duas cadeias — “unificar o padrão primeiro” e “o modelo decompõe diretamente de ponta a ponta” — e comparar o número de erros de mapeamento de campos, a taxa de repetição, a taxa de intervenção humana e a latência de ponta a ponta, exigindo que os dois primeiros caiam e que a latência não suba de forma significativa. Segundo, a IA de decisão coloca previsão e resolução de restrições no mesmo ciclo contínuo e afirma atualizar decisões em segundos quando mudam pedidos, estradas ou capacidade de transporte. A escolha a fazer é: em tarefas de despacho, deixar um modelo generativo emitir diretamente a solução final ou separar previsão, resolução e retroalimentação de execução em três etapas avaliadas separadamente. A premissa é que seu problema tenha restrições rígidas (prazo, custo, capacidade) e alto custo de erro; tarefas de mera ordenação ou recomendação podem manter a solução de modelo único. O critério testável é reproduzir com pedidos históricos e comparar a taxa de violação de restrições, a diferença de custo em relação à linha de base com regras atuais e o tempo de recuperação após injetar perturbações. Terceiro, a parte de IA física não pode ser reproduzida localmente e só pode ser validada por meio de piloto ou processo de compra. Para avaliar soluções do tipo braço mecânico ou veículo autônomo, primeiro defina a faixa de diversidade das formas dos pacotes no local e depois exija do fornecedor indicadores observáveis como horas de operação contínua, taxa de sucesso de captura, taxa de danos e frequência de intervenção humana, em vez de aceitar descrições como “operação normalizada”. Há ainda uma ação de baixo custo aplicável a qualquer narrativa semelhante: registrar diretamente no formulário de avaliação os critérios que o fornecedor deve fornecer, incluindo percentis de latência, escala do problema, configuração de hardware, janela estatística e configuração do grupo de controle. Sem isso, os números do fornecedor não podem ser convertidos no seu próprio planejamento de capacidade.
Limites e pontos a confirmar
Todos os números de desempenho e eficiência do texto são fornecidos pela JD Logistics, sem reprodução por terceiros, e não devem ser tomados como linha de base de capacidade extrapolável. O artigo apresenta apenas a divisão de responsabilidades dos cinco modelos, sem informações necessárias à seleção, como escala de parâmetros, termos de licença, se os pesos são publicados ou custo de inferência; a forma de implementação de “aberto para os setores de manufatura e varejo”, as barreiras de integração e a forma de cobrança não são explicadas, e o escopo real de disponibilidade do “Jinghui” também precisa ser confirmado com a JD Logistics. É importante deixar claro que o grande modelo “Super Brain” 3.0 da JD Logistics não está atualmente no catálogo de modelos do KimiSeek, o site não tem entrada correspondente para ele, e este artigo não o considera um modelo chamável no site; os serviços externos mencionados no texto, sua disponibilidade, especificações e cobrança estão sujeitos às explicações da JD Logistics. Se, no futuro, esse conjunto publicar uma API ou pesos, a decisão de integrá-lo ainda deverá ser avaliada separadamente segundo os critérios testáveis acima.
Ilustrações da notícia original