JetBrains abre Mellum2.1: modelo agente de código MoE 12B com pesos e quantizações Apache 2.0
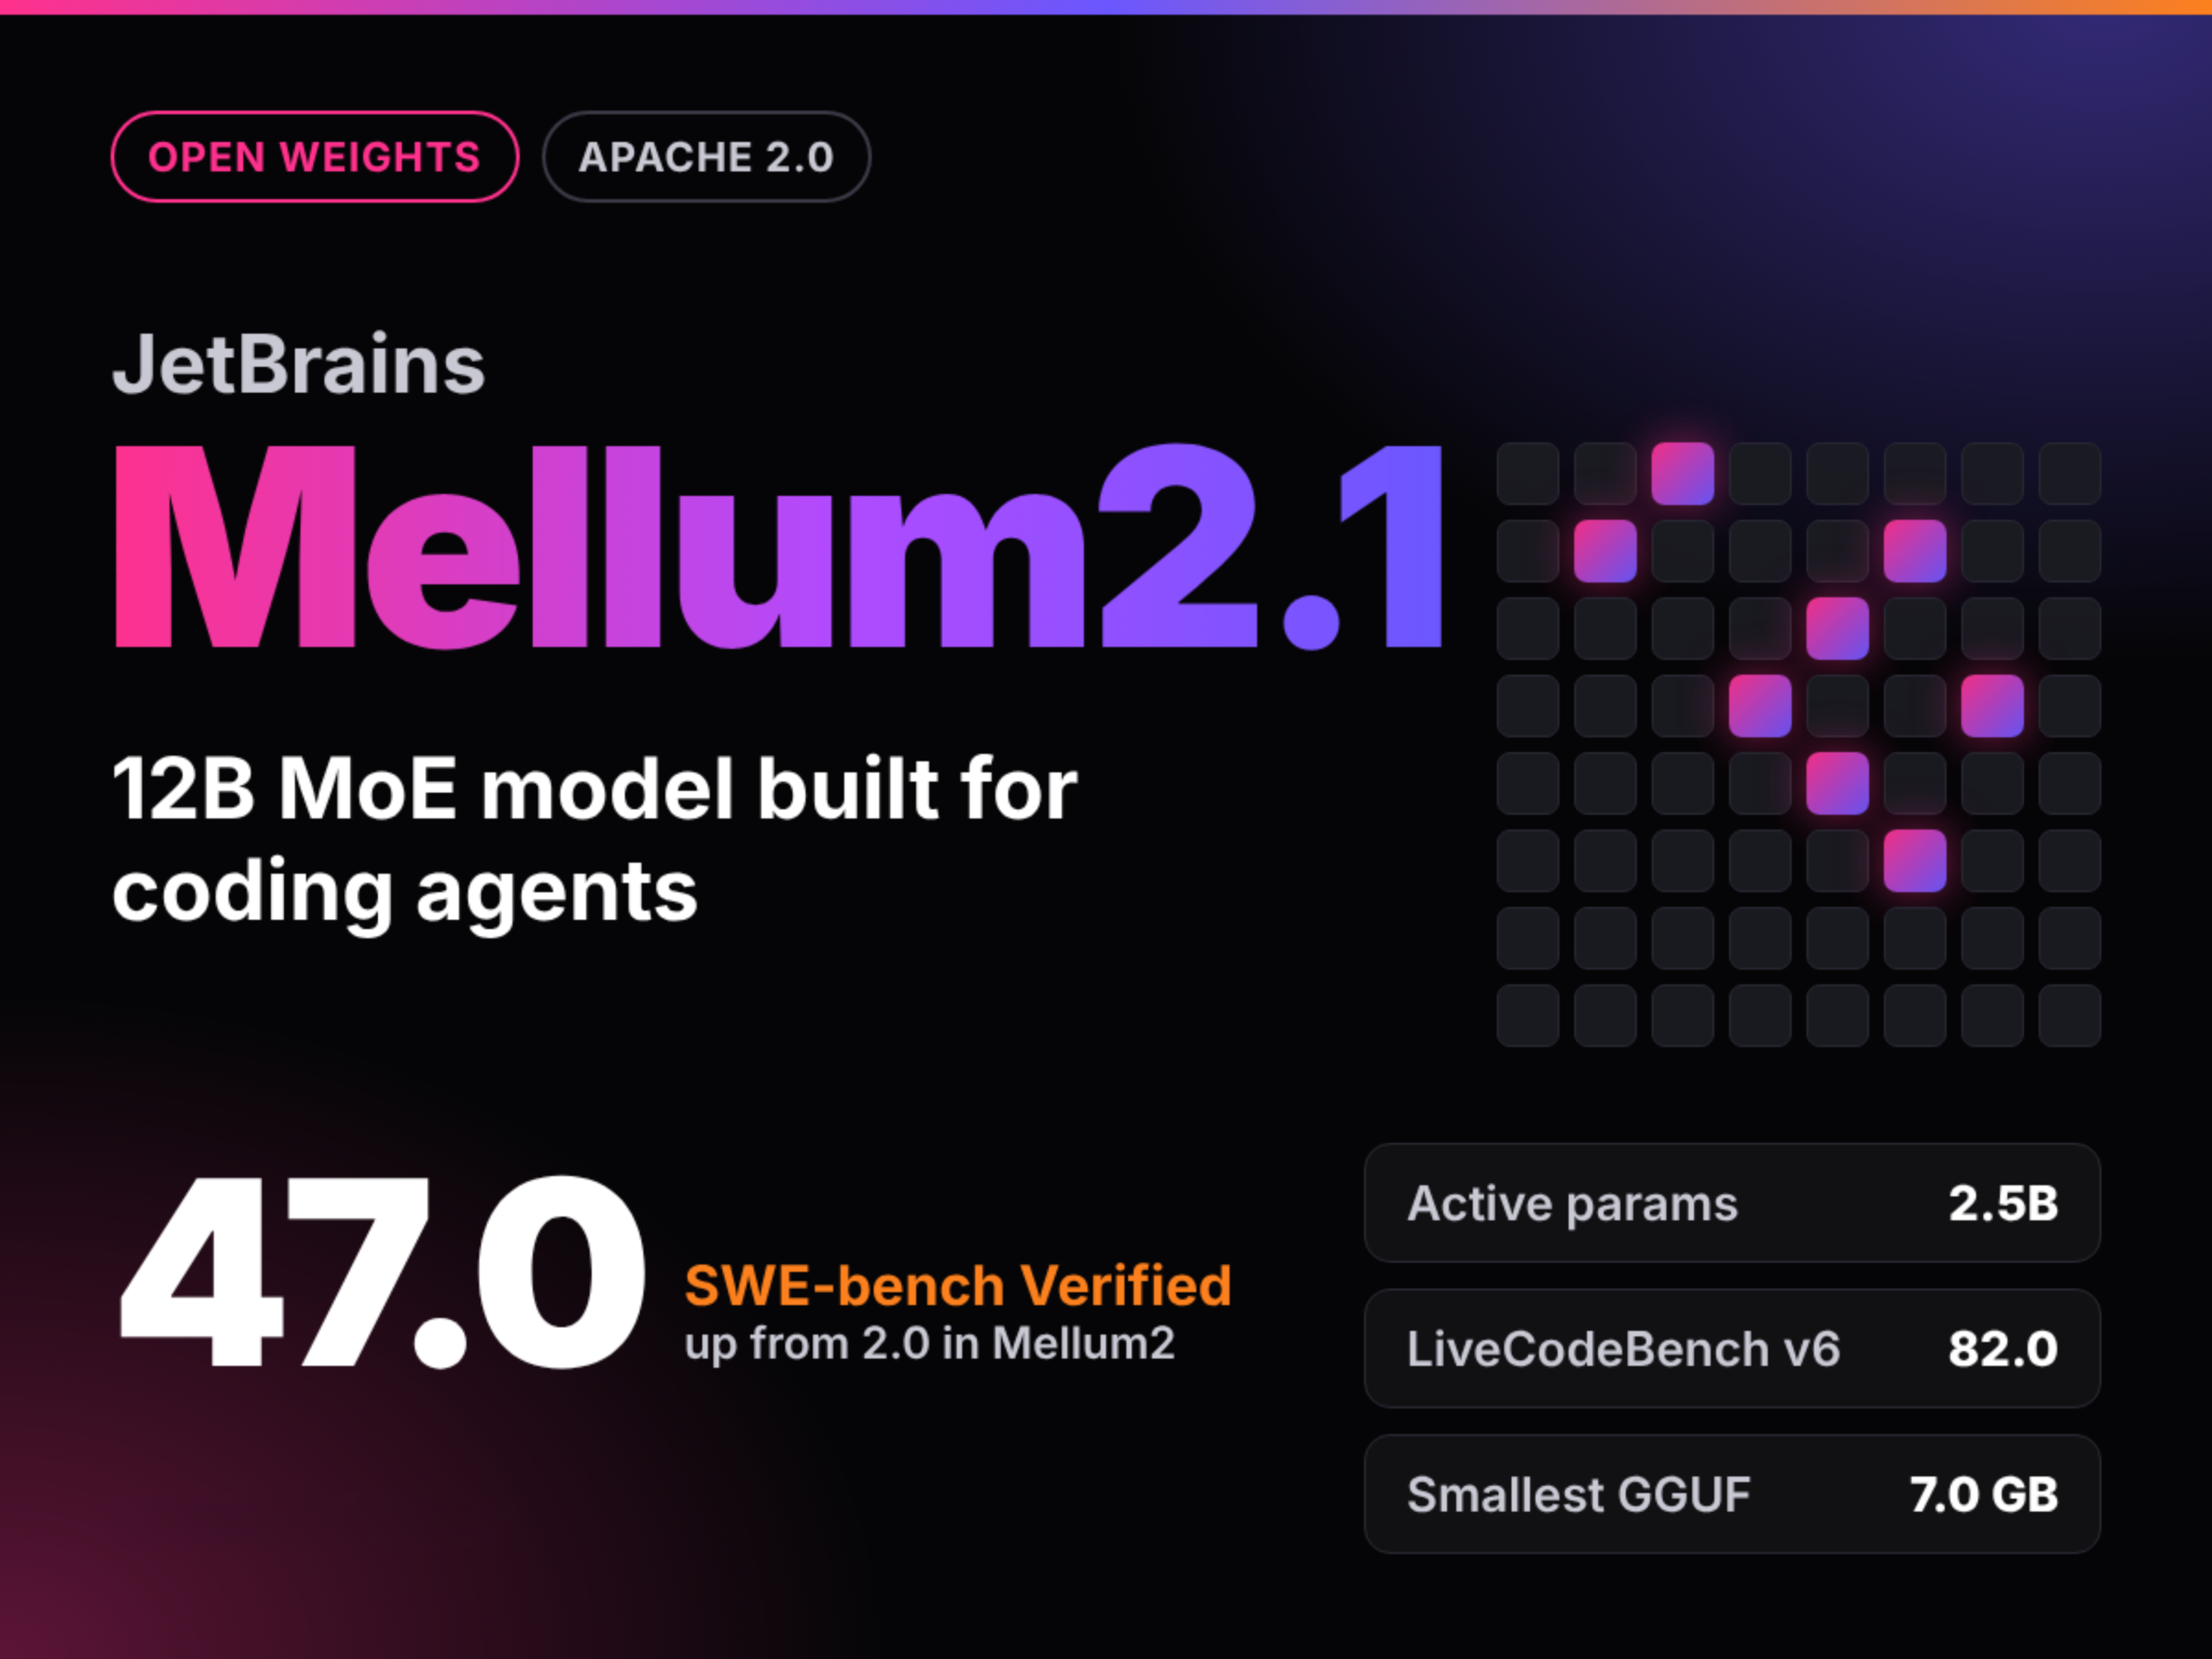
Segundo o MarkTechPost em 8 de outubro de 2026, a JetBrains abriu o Mellum2.1 sob a licença Apache 2.0, ou seja, o Mellum2.1-12B-A2.5B-Thinking: um modelo MoE de raciocínio com 12B de parâmetros totais e 2,5B ativados por token, com a mesma arquitetura da geração anterior; a melhoria vem principalmente de aprendizado por reforço em repositórios de código reais, e o relatório afirma que o SWE-bench Verified subiu de 2.0 para 47.0.
O que mudou
Segundo o MarkTechPost em 8 de outubro de 2026, a JetBrains lançou o Mellum2.1, cujo checkpoint se chama Mellum2.1-12B-A2.5B-Thinking, publicando os pesos no Hugging Face sob a licença Apache 2.0. É um modelo de raciocínio de mistura de especialistas com 12B de parâmetros totais e 2,5B ativados por token, 28 camadas, 64 especialistas, 8 ativados por token, com GQA (32 cabeças de consulta, 4 de KV), 3 de cada 4 camadas usando janela deslizante de 1024 tokens, contexto de 131072 tokens, vocabulário de 98304 e pesos em bfloat16. A reportagem afirma que a arquitetura não mudou em relação ao Mellum2 Thinking, aberto em junho de 2026, e que a atualização vem quase toda do pós-treinamento: o RL se tornou o corpo principal do treinamento, com acréscimo de tarefas de matemática, programação competitiva, ciência, chamada de ferramentas e engenharia de software, treinando em repositórios reais com ferramentas de shell e edição de arquivos e recompensa por testes aprovados. A reportagem diz que, nos testes da própria JetBrains, o SWE-bench Verified subiu de 2.0 para 47.0, o SWE-bench Pro de 0.0 para 28.0, o Terminal-Bench 2.1 de 0.6 para 17.4, o LiveCodeBench v6 ficou em 82.0, o BFCL v4 em 62.3 e o HarmBench caiu de 21.5 para 8.5; o Qwen3.5-9B ainda lidera no SWE-bench Verified (50.0), SWE-bench Pro (38.0), GPQA Diamond (77.8) e AIME 25/26 (86.7).
Impacto para desenvolvedores
Este lançamento importa para agentes de código auto-hospedados em três pontos, todos dependentes do relato e não de reprodução independente. Primeiro, o modelo abre pesos sob Apache 2.0, uma publicação de pesos abertos com licença clara, e não apenas pesos baixáveis; mas todas as pontuações de benchmark no relato são auto-reportadas pela JetBrains, e os valores de LiveCodeBench v6 e GPQA Diamond do cartão oficial do Qwen para o mesmo modelo diferem bastante do processo de avaliação da JetBrains, indicando que as pontuações são sensíveis ao framework de avaliação e não podem ser tomadas como conclusão comparável entre fornecedores. Segundo, os 2,5B de parâmetros ativados somados ao contexto de 131072 tokens e às quantizações GGUF tornam viável um subagente local em ambiente de consumidor ou de GPU única: o relato lista versões como BF16 24,3 GB, Q8_0 12,9 GB, Q4_K_M 8,1 GB (taxa de correspondência do primeiro token de 88,0%) e MXFP4_MOE 7,0 GB (85,6%). O desenvolvedor deve observar se a degradação após quantização cai dentro da tolerância da sua tarefa, e não apenas o tamanho do arquivo. Terceiro, o relato afirma que a vazão sob alta carga em uma única H200 é quase o dobro da do Qwen3.5-9B e que o MTP acelera cerca de 1,6 vez em cenário de requisição única, mas a cabeça MTP para decodificação especulativa no vLLM está marcada como em breve, ou seja, a implantação atual não pode usar essa aceleração diretamente. Para equipes que usam agentes de código, este é mais um candidato a unidade de execução de baixo custo do que um substituto do núcleo de inferência geral: o relatório mostra desempenho inferior no Terminal-Bench 2.1 e em benchmarks de conhecimento.
Integração e avaliação
Recomenda-se validar por camadas de tarefa, em vez de substituir a pilha inteira. Decisão um: se a carga for complementação de código ou unidade de execução de subagente de alta concorrência e passos curtos, pode-se avaliar primeiro a implantação MoE de 12B/2,5B ativados, desde que haja memória de GPU suficiente para ao menos uma placa e ambiente vLLM ou SGLang; o relato indica iniciar com vLLM e --reasoning-parser qwen3, adicionar --enable-auto-tool-choice --tool-call-parser hermes para chamada de ferramentas, e parâmetros de amostragem sugeridos temperature 0.6, top_p 0.95, top_k 20; a métrica deve ser vazão por token e custo por tarefa no mesmo hardware, não apenas a pontuação de benchmark. Decisão dois: se a carga for correção de nível de repositório em cadeia longa, convém primeiro fazer uma comparação em pequena amostra com repositórios próprios, comparando taxa de sucesso e modos de falha com modelos como o Qwen3.5-9B, pois o SWE-bench Verified auto-reportado de 47.0 é inferior ao 50.0 do Qwen3.5-9B e a diferença no Terminal-Bench 2.1 é mais evidente; a condição aqui é que a empresa já tenha conjunto de testes com julgamento automático; a métrica é a taxa de sucesso ponta a ponta e o número médio de passos. Decisão três: em cenários locais ou offline, pode-se testar primeiro as quantizações Q4_K_M e MXFP4_MOE, desde que a tarefa não seja sensível ao desvio de comportamento do primeiro token; a métrica é a taxa de correspondência do primeiro token e a diferença de acurácia real entre a versão quantizada e a referência BF16 no próprio conjunto de prompts. Nota-se ainda que a disponibilidade descrita no relato se refere aos pesos publicados pelo fornecedor e ao suporte dos frameworks de inferência, e a forma de integração segue a documentação de cada framework.
Limites e pontos a confirmar
Limitações importantes devem ser explícitas: o Mellum2.1 não aparece no catálogo ao vivo de modelos do KimiSeek, e essa versão atualmente não está listada no KimiSeek; os pesos, GGUF e modos de implantação vLLM/SGLang mencionados no relato referem-se ao lançamento da JetBrains e não significam disponibilidade neste site. Todos os números de desempenho vêm de auto-relato da JetBrains ou de seu processo unificado de avaliação, incluindo SWE-bench, Terminal-Bench, LiveCodeBench e BFCL, sem reprodução independente; o próprio relato observa que o cartão oficial do Qwen e a avaliação da JetBrains dão valores diferentes para o mesmo modelo, portanto conclusões de comparação horizontal exigem cautela. A taxa de correspondência do primeiro token das versões quantizadas não equivale à acurácia da tarefa; a lista GGUF do relato e a nota de que "o GGUF ainda está em produção" apresentam diferença de critério, e os arquivos realmente disponíveis e sua qualidade precisam ser verificados por conta própria. A cabeça MTP está marcada como em breve e a aceleração por decodificação especulativa no vLLM ainda não está disponível. Além disso, preços e formas de cobrança específicos de chamada devem seguir a página de preços do fornecedor; este texto não cita valores concretos.