Jiuzhang Yunji lança Alaya-DFlash2, decodificação especulativa de código aberto para GLM-5.3, com alegação de 3,41 vezes mais velocidade em contexto de 32k
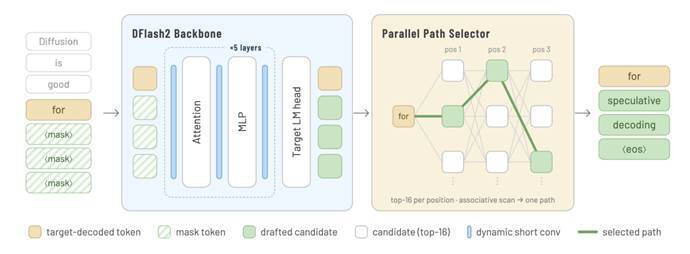
Segundo reportagem da InfoQ de 20 de outubro de 2026, a Jiuzhang Yunji lançou o Alaya-DFlash2, uma solução de aceleração por decodificação especulativa voltada ao GLM-5.3, com modelo de rascunho de elaboração paralela e mecanismo de seleção de caminhos, tendo os pesos sido tornados públicos. Avaliações do fabricante afirmam que, em 8×H200 com TP=8, a velocidade de decodificação em concorrência única é 3,41 vezes a da autoregressão nativa, e que o comprimento de aceitação em contextos de baixa entropia de 1k a 32k supera o de dois esquemas comparados. Esses números e comparações são avaliações próprias do fabricante, ainda pendentes de reprodução por terceiros.
O que mudou
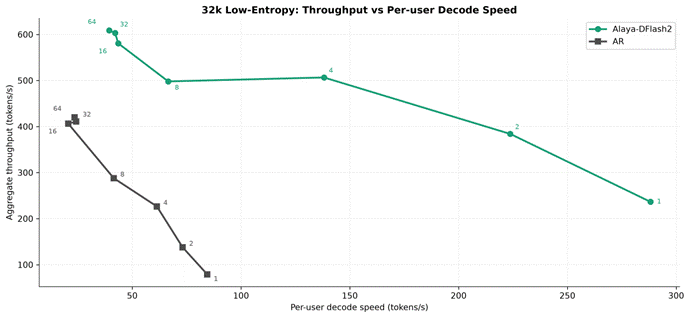
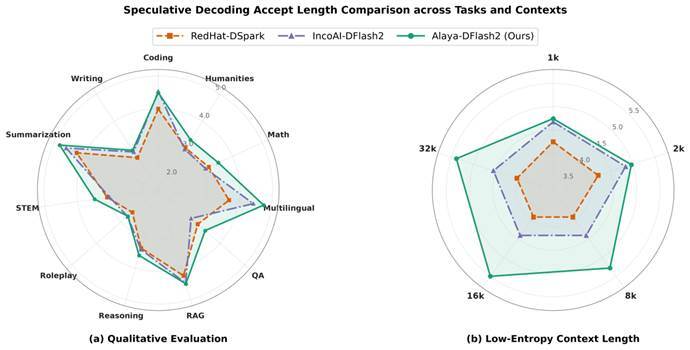
Segundo reportagem da InfoQ de 20 de outubro de 2026, a Jiuzhang Yunji apresentou o Alaya-DFlash2, uma solução de aceleração por decodificação especulativa voltada ao GLM-5.3, composta por um modelo de rascunho capaz de elaborar em paralelo e um mecanismo de seleção de caminhos, com pesos tornados públicos sob o nome AlayaNeW/GLM-5.3-DFlash2; a reportagem não detalha os termos da licença de código aberto. A reportagem afirma que a solução treina um modelo de rascunho associado ao GLM-5.3 com base no motor de computação inteligente AlayaNeW da Jiuzhang Yunji. Quanto à avaliação, a reportagem apresenta dados em ambiente de 8×H200 com TP=8: a velocidade de decodificação em concorrência única é de cerca de 288,2 tokens/s, contra cerca de 84,5 tokens/s da autoregressão nativa, uma razão de 3,41 vezes; a vazão total de saída correspondente sobe de 78,95 para 236,47 tokens/s. Com o aumento da concorrência, a vantagem diminui: a vazão em 4 concorrências é 2,24 vezes a da autoregressão nativa, e em 64 concorrências é de 608,71 tokens/s, um ganho de 44,9% sobre os 420,13 tokens/s da autoregressão nativa. A reportagem também lista os comprimentos de aceitação em contextos de baixa entropia: 4,74, 4,97, 5,28, 5,50 e 5,39 para 1k, 2k, 8k, 16k e 32k, respectivamente, todos superiores aos do IncoAI-DFlash2 e do RedHat-DSpark incluídos na comparação; afirma ainda que, em 9 de 11 categorias de tarefas, o comprimento de aceitação lidera, e que as categorias de código e role-playing ficam próximas do IncoAI-DFlash2.
Impacto para desenvolvedores
O significado prático da decodificação especulativa para desenvolvedores está em que ela altera a estrutura de custo de geração no mesmo hardware, não a capacidade do modelo em si. Conforme a reportagem, manter o comprimento de aceitação do rascunho em torno de 5 em cenários de contexto longo significa que uma passagem pelo modelo principal pode verificar e aceitar cerca de 5 tokens candidatos, reduzindo as rodadas de decodificação repetida do modelo principal e encurtando diretamente a espera de saída contínua após o primeiro token. Para equipes que operam serviço de inferência próprio do GLM-5.3, isso equivale a trocar por vazão de decodificação sem substituir o modelo principal nem alterar a distribuição de saída, ao custo de carregar pesos adicionais do modelo de rascunho e do correspondente consumo de memória de GPU e sobrecarga de escalonamento. A reportagem também mostra que o ganho varia com a concorrência: a velocidade em concorrência única tem o maior aumento, e em 64 concorrências o ganho de vazão total cai para 44,9%, indicando que o benefício se concentra mais em cenários interativos de baixa concorrência, com incremento de vazão por unidade relativamente limitado em serviços de alta concorrência. Cabe notar que todos os números vêm de autotestes do fabricante, com ambiente fixo de TP=8 e 8×H200, e que o comprimento de aceitação depende da distribuição concreta dos dados, podendo diferir fora de contextos de baixa entropia; além disso, tornar os pesos públicos não equivale a termos de licença claros, sendo necessário verificar as informações de licença no repositório antes de uso comercial.
Integração e avaliação
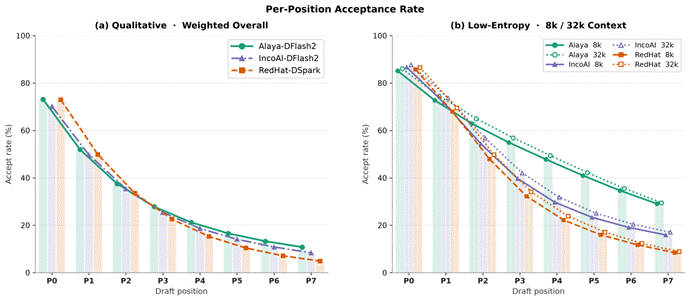
Recomenda-se decidir com base nas condições abaixo, em vez de adotar diretamente as conclusões da avaliação. A primeira decisão é se vale introduzir esse modelo de rascunho. Se a carga de inferência for predominantemente de contexto longo e baixa a média concorrência, como perguntas e respostas sobre documentos longos e sumarização em RAG, os dados reportados de comprimento de aceitação acima de 5 em 16k a 32k sustentam a realização de um teste comparativo com tráfego real; se a carga for predominantemente de alta concorrência e requisições curtas, e como a reportagem indica ganho de vazão de apenas 44,9% em 64 concorrências, é preciso primeiro medir se o consumo extra de memória de GPU e o custo de escalonamento do modelo de rascunho compensam. O critério de avaliação pode ser: medir o comprimento de aceitação efetivo e a latência entre tokens sobre amostras próprias de 32k; se o comprimento de aceitação for claramente inferior ao reportado ou o aumento de memória de GPU reduzir o limite de concorrência, não introduzir. A segunda decisão é a configuração do número de posições de rascunho e do lote de verificação. A reportagem mostra que a taxa de aceitação nas posições finais do rascunho ainda é considerável (em 32k, 49,43% na 5ª posição e 29,51% na 8ª posição), o que sustenta ajustar a profundidade de verificação para além do padrão; mas esse ganho só se sustenta se a taxa de aceitação no backend se mantiver nos dados próprios, e se em tipos de tarefa em que a reportagem não obteve liderança, como código e role-playing, a taxa de aceitação decair rapidamente, aumentar o comprimento do rascunho apenas desperdiçará poder de computação. O critério de avaliação pode ser: calcular a taxa de aprovação por posição, identificar a posição em que a taxa de aceitação cai abaixo do limite definido e truncar o comprimento do rascunho com base nisso. Todas as recomendações acima são condicionais e baseadas nos dados da reportagem, não sendo conclusões de implantação fornecidas pelo fabricante.
Limites e pontos a confirmar
Todos os dados de desempenho da reportagem vêm de autotestes da Jiuzhang Yunji, sem reprodução por terceiros nem divulgação dos conjuntos de dados de teste, modelos de prompt e parâmetros de decodificação; o comprimento de aceitação depende fortemente da distribuição dos dados e pode não se reproduzir em tráfego próprio. O ambiente de avaliação é fixo em 8×H200 com TP=8, sendo desconhecido o desempenho em outros hardwares e configurações de paralelismo. O código aberto citado na reportagem fornece apenas o endereço dos pesos, sem indicar o tipo de licença; pesos disponíveis não significam que os termos de licença permitam uso comercial ou redistribuição irrestritos, prevalecendo a declaração do repositório. Além disso, o Alaya-DFlash2 é uma solução independente de modelo de rascunho voltada ao GLM-5.3, distinta do modelo principal; o GLM-5.3 tem de fato entrada correspondente no catálogo atual do KimiSeek, mas o Alaya-DFlash2 em si, como solução de aceleração, não está listado como modelo chamável no KimiSeek, e sua disponibilidade deve ser verificada junto ao fabricante e ao repositório de pesos.
Ilustrações da notícia original