Kimi K3.1 Pro Highspeed chega ao Bedrock com esforço de raciocínio máximo por padrão
Em um post de blog de 10 de novembro de 2026, a AWS afirmou que o Kimi K3.1 Pro Highspeed está disponível no Amazon Bedrock, mantendo o endpoint e a API do K3; a Moonshot AI informa que a velocidade de saída é 2 a 3 vezes a do K3.1 Pro. O esforço de raciocínio máximo por padrão, o custo de latência da camada Flex e a indisponibilidade do cache explícito no Converse são as três decisões antes da integração.
O que mudou
Em um post de blog de aprendizado de máquina de 10 de novembro de 2026, a AWS anunciou que o Kimi K3.1 Pro Highspeed, da Moonshot AI, está disponível no Amazon Bedrock. O texto o descreve como uma versão pós-treinada do Kimi K3: mantém a mesma arquitetura de pesos abertos de nível 3T e a janela de contexto de 1 milhão de tokens, treinada com volume significativamente maior de computação de pós-treinamento; segundo a Moonshot AI, esse treinamento visa tarefas de agentes de longo ciclo, busca reduzir erros factuais e melhorar modelagem financeira, documentos de escritório e programação voltada a engines de jogos, cenas 3D e scripts CAD. A taxa de geração de tokens de saída é maior, e a Moonshot AI informa que a velocidade é 2 a 3 vezes a do Kimi K3.1 Pro. No Bedrock, ele mantém o endpoint, a API e os recursos do Kimi K3, e aplicações que já usam o K3 só precisam alterar o ID do modelo; suporta chamada de ferramentas, saída estruturada, raciocínio configurável, entrada de imagens e saída em streaming, podendo ser acessado por três perfis de inferência entre regiões (global, us e in), sendo os requisitos de residência de dados o critério para escolher o perfil. A AWS afirma que os dados são processados dentro de seu limite de dados, não são compartilhados com a Moonshot AI nem usados para treinar modelos, e que as requisições de inferência sempre têm retenção zero de dados, com operadores sem acesso a prompts e completions durante a inferência. A série K3.1 já havia sido noticiada; o que se acrescenta aqui é o canal gerenciado no Bedrock e as opções de inferência e cobrança que ele define.
Impacto para desenvolvedores
O impacto prático da integração está na forma da interface e nos valores padrão, não na capacidade do modelo em si. Equipes que já usam o OpenAI SDK podem apontar o base_url para o endpoint de runtime do Bedrock e trocar o nome do modelo, mas a autenticação passa a ser um bearer token de curta duração gerado a partir de credenciais da AWS; o IAM exige as permissões InvokeModel e InvokeModelWithResponseStream, e o uso de bearer token também requer CallWithBearerToken. O Bedrock oferece tanto Chat Completions e Responses compatíveis com OpenAI quanto Converse e Invoke próprios, e a AWS recomenda os primeiros. A segunda mudança é o raciocínio no máximo por padrão: o modelo sempre raciocina antes de responder, e sem esforço definido assume max, o que em tarefas de classificação, extração de campos e perguntas curtas, com espaço de resposta pequeno, eleva diretamente a latência e os tokens de saída; ao interpretar a resposta do Converse também é preciso selecionar o bloco de texto, pois a resposta pode vir primeiro com um bloco de raciocínio. O terceiro ponto é a divisão em camadas: a AWS diz que o Flex custa metade do preço do Standard, ao custo de tempo de resposta potencialmente maior, e que as cotas sob demanda são compartilhadas entre Standard, Priority e Flex, de modo que migrar tráfego para o Flex não cria cota extra; a camada é definida por requisição e uma mesma aplicação pode misturá-las. O quarto ponto é o limite de interface do cache: o cache explícito de prompt vale para Chat Completions, Responses e Invoke, mas não para Converse; é preciso haver pelo menos 256 tokens de conteúdo estável antes do ponto de quebra, o conteúdo em cache é mantido por no mínimo 30 minutos, a gravação é cobrada a uma taxa superior à da entrada padrão e a leitura tem taxa com desconto e não entra na cota de tokens de entrada por minuto. Para agentes e assistentes de programação que reenviam a cada turno instruções de sistema, definições de ferramentas e convenções do repositório, o acerto do cache costuma pesar mais na fatura do que o preço unitário. A reportagem também explica por que a velocidade de saída importa mais em agentes de programação: ler arquivos, planejar mudanças, editar código, rodar testes e corrigir falhas formam uma sequência de chamadas seriais, cada uma esperando o fim da anterior, e mais tokens por unidade de tempo encurtam todo o ciclo. Tudo isso são mudanças estruturais do lado do canal, não uma verificação independente da qualidade do modelo.
Integração e avaliação
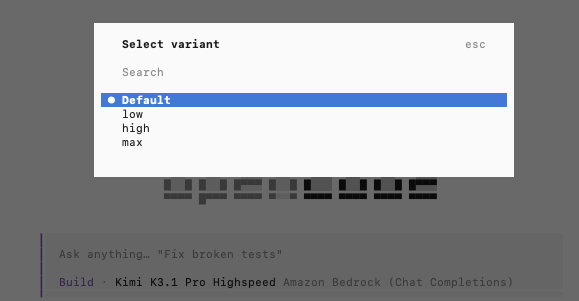
A seguir, análises e recomendações condicionais baseadas na reportagem, que são sugestões e não fatos verificados. Decisão um: colocar o esforço de raciocínio explicitamente na configuração. A reportagem diz que, sem definir reasoning_effort, o padrão é max, com opções low, high e max, e que no Responses a mesma configuração corresponde a reasoning.effort. Se sua carga é classificação, extração de campos, perguntas curtas ou reescrita padronizada, tarefas com espaço de resposta pequeno, recomenda-se fixar por tipo de tarefa em low ou high e manter max apenas nos fluxos que realmente exigem raciocínio em várias etapas. O pressuposto é ter resultados próprios de avaliação por faixa, e não baixar por intuição; se o fluxo impõe restrições rígidas ao formato de saída, confirme também que a redução não diminui os campos da saída estruturada. Critério testável: no mesmo conjunto próprio de tarefas, comparar a taxa de aprovação e a mediana de tokens de saída entre low e max; se a queda de aprovação ficar dentro do intervalo aceitável e os tokens de saída caírem claramente, registre a faixa na configuração em vez de depender do padrão. Decisão dois: escolher a camada de serviço por requisição e conferir qual camada realmente atendeu. A AWS diz que o Flex pode ter maior latência mas preço menor, que a camada é definida por requisição e que as três compartilham cota. Se sua tarefa é avaliação offline, resumo em lote ou etapas de segundo plano de um agente, insensível ao tempo de uma resposta, você pode colocar uma pequena parte do tráfego no Flex e manter as requisições síncronas voltadas ao usuário em Standard ou Priority. O pressuposto é confirmar com as dimensões ServiceTier e ResolvedServiceTier do CloudWatch qual camada de fato atendeu a requisição, pois pedir Flex e ser atendido pelo Flex são coisas distintas, e misturar camadas altera ao mesmo tempo a latência de cauda e o consumo de cota. Critério testável: latência p95 e custo por mil tarefas do mesmo lote em Flex e Standard; só amplie a proporção se o custo melhorar e a latência de cauda continuar dentro do orçamento de timeout definido. Decisão três: tratar a disponibilidade de cache como critério de escolha de interface, não como otimização posterior. O cache explícito não está disponível no Converse, exige pelo menos 256 tokens de conteúdo estável antes do ponto de quebra e mantém o cache por no mínimo 30 minutos. Se seu serviço já foi construído sobre o Converse e o contexto contém grandes prefixos estáveis (instruções de sistema, definições de ferramentas, convenções do repositório), será preciso escolher entre migrar para Chat Completions ou Responses para obter cache explícito, o que pode aumentar o acerto ao custo de mudar o caminho de chamada e aceitar a cobrança de gravação a taxa maior, ou aceitar depender apenas do cache automático. Critério testável: primeiro ler a contagem de tokens em cache no uso retornado para confirmar acerto maior que zero, depois comparar custo de entrada e latência do primeiro token antes e depois de ativar, confirmando que pequenos ajustes na posição do ponto de quebra não derrubam o acerto. Há ainda um ponto que vale definir na revisão de arquitetura: o perfil global custa menos por token que os perfis geográficos, mas com requisitos de residência de dados só se pode escolher us ou in, e mudar depois afeta a topologia de implantação. Se você já roda negócios com o Kimi K3 no Bedrock, a verificação mínima é manter um conjunto de tarefas rodando em paralelo no K3 e no Highspeed, comparando o tempo de conclusão por tarefa e o número de novas tentativas após falha, em vez de olhar só a velocidade do primeiro pacote.
Limites e pontos a confirmar
Duas incertezas devem ser preservadas. Primeiro, 2 a 3 vezes é a velocidade informada pela própria Moonshot AI; o blog da AWS não apresenta benchmark, método de medição nem condições de concorrência, e a diferença real depende do comprimento da saída e da camada usada, não podendo ser tratada como conclusão reproduzida de forma independente. Segundo, a expressão “arquitetura de pesos abertos de nível 3T” descreve a arquitetura, enquanto o Bedrock entrega um serviço de inferência gerenciado: se os pesos podem ser baixados e sob qual licença são publicados não decorre dessa frase e exige consulta ao anúncio oficial e ao texto da licença da Moonshot AI; mesmo que os pesos sejam baixáveis, pesos abertos não equivalem a licença de código aberto. Há ainda um ponto que confunde: segundo o texto original, mais computação de pós-treinamento, redução de erros factuais e ganhos em modelagem financeira, documentos de escritório, engines de jogos, 3D e scripts CAD são descrições relativas ao Kimi K3; entre o K3.1 Pro Highspeed e o não Highspeed, a diferença apresentada neste texto é principalmente a taxa de geração de tokens de saída, e o artigo não oferece comparação item a item de capacidades nem dados de avaliação independentes do Highspeed. A informação de que o cache é mantido por “no mínimo 30 minutos” dá apenas o piso, não o teto, e o custo de latência do Flex também é apenas qualitativo. Regiões suportadas, cotas e preços devem ser consultados no model card, na página de disponibilidade regional e na página de preços do Bedrock, que mudam; o catálogo interno já tinha uma entrada com o mesmo nome no momento desta verificação, e seus preços e limites estão na página de preços interna, mas a inclusão no catálogo e a disponibilidade no Bedrock são coisas distintas, e a primeira não valida a segunda.
Ilustrações da notícia original