Kimi K3.1 Pro é lançado: MoE de 2,8T/104B e contexto de 1M, API já disponível
Segundo o Marktechpost, em 23 de outubro de 2026, a Moonshot AI lançou o Kimi K3.1 Pro, primeiro modelo da série K3.1, com estrutura MoE de 2,8T de parâmetros totais e 104B ativados, suporte a contexto de 1M tokens, já disponível na API Kimi, com preço de API inferior ao K3; pesos abertos previstos para novembro de 2026. Seus benchmarks autodeclarados ficam próximos da fronteira em codificação, mas claramente atrás em tarefas de terminal científico.
O que mudou
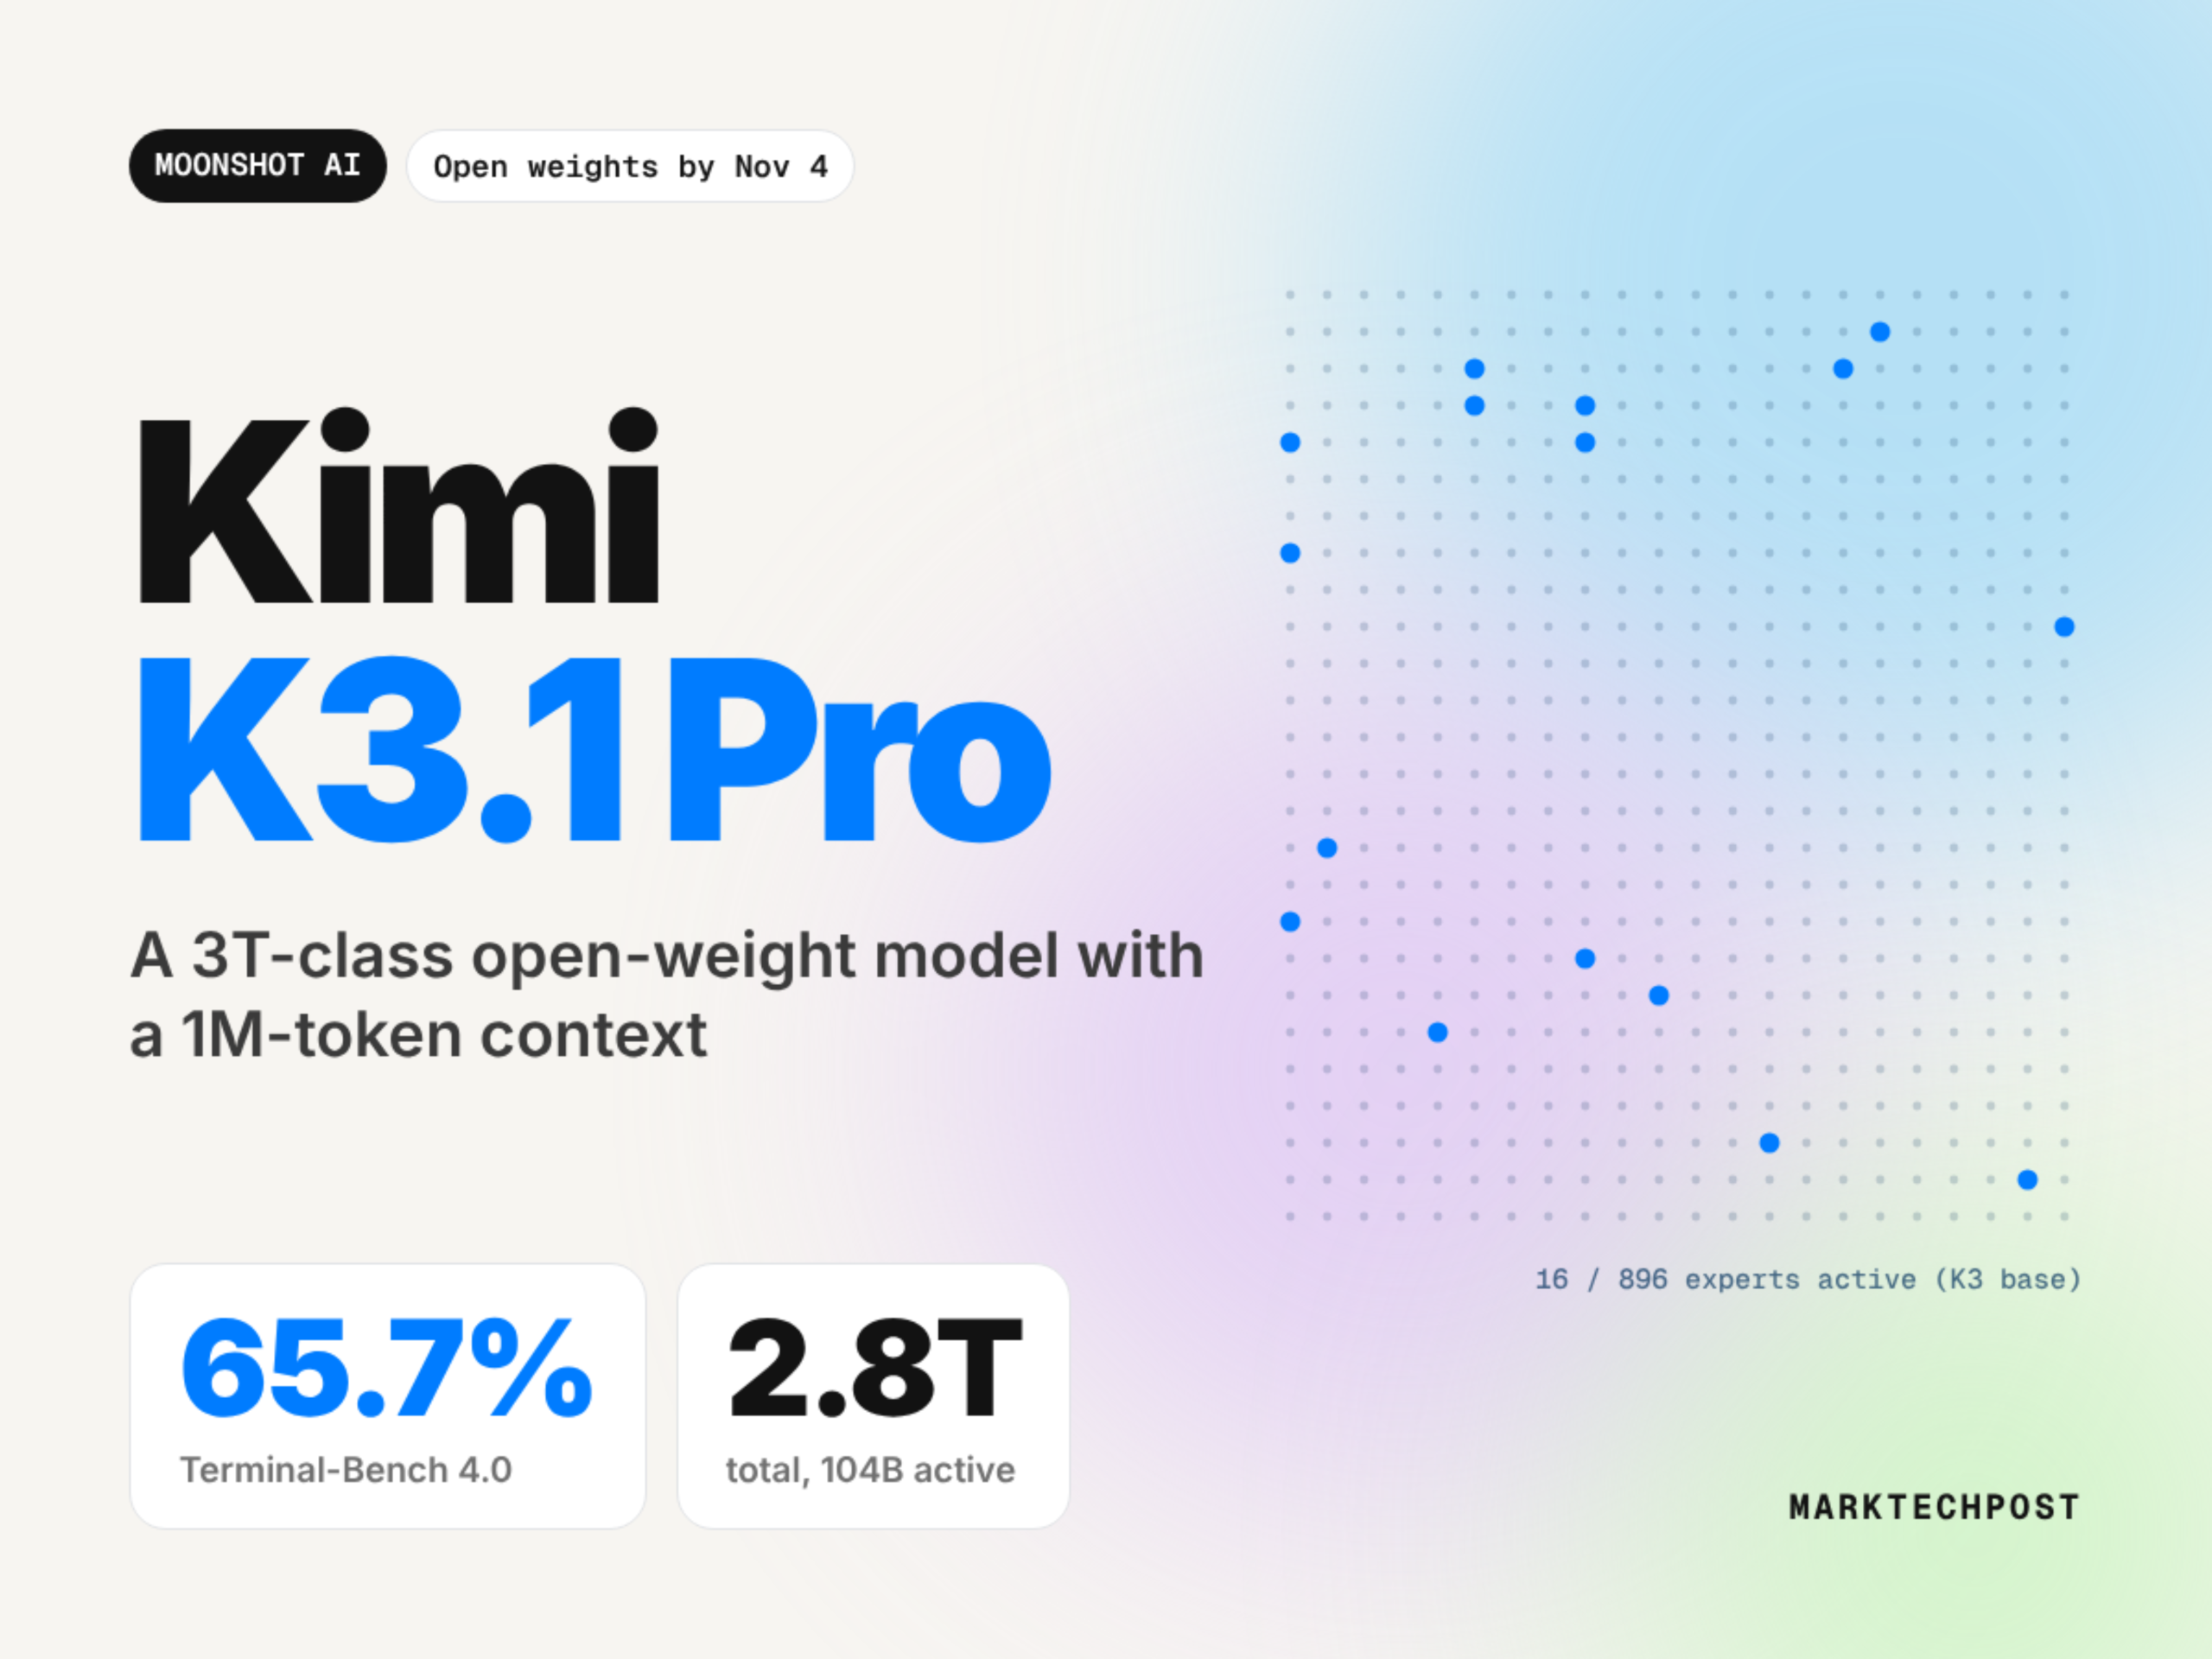
Segundo o Marktechpost, em 23 de outubro de 2026, a Moonshot AI lançou o Kimi K3.1 Pro, primeiro modelo da série K3.1, uma versão de pós-treinamento do K3, com relato de aumento substancial no compute de pós-treinamento e aprendizado por reforço conjunto em centenas de domínios downstream. A fonte afirma que o modelo tem 2,8T de parâmetros totais e 104B ativados (MoE); a arquitetura base K3 usa Kimi Delta Attention e Attention Residuals, ativando 16 de 896 especialistas via Stable LatentMoE, com suporte a contexto de 1M tokens; a API aceita texto, imagem e vídeo. Também foi lançada uma variante Highspeed, que o blog oficial afirma ser 2 a 3 vezes mais rápida. Os identificadores de API são kimi-k3.1-pro e kimi-k3.1-pro-highspeed, com endpoint compatível com OpenAI. A reportagem cita a fonte dizendo que o preço da API é inferior ao do K3, com cobrança separada para acertos de cache; os pesos abertos ainda não foram lançados, com previsão para novembro de 2026. Os dados de benchmark são todos autodeclarados pela Moonshot, a maioria obtida com esforço de raciocínio máximo e harness do Claude Code: Terminal-Bench 4.0 em 65,7%, SWE-Marathon em 51,7, Terminal-Bench Science 0.1 em apenas 38,1, e no interno Kimi Hallu Bench Hard a alucinação em nível de asserção caiu de 23,4% no K3 para 8,3%. A documentação de início rápido lista algumas limitações práticas: o modo de pensamento está sempre ativado, com esforço de raciocínio em low, high, max (padrão max); temperatura 1.0 e top-p 0.95 são valores fixos; saída padrão de 131.072 tokens, máximo de 1.048.576; entrada visual não aceita URLs públicas de imagens, exigindo base64 ou upload de arquivo com ID.
Impacto para desenvolvedores
O impacto direto para desenvolvedores concentra-se em três pontos: forma de integração, estrutura de custos e comportamento em contexto longo. Primeiro, este é o primeiro modelo da série K3.1, descrito como iteração de pós-treinamento do K3, não uma arquitetura nova, portanto o custo de migração pode ser menor que uma troca entre gerações, mas os identificadores de API e os parâmetros do modo de pensamento precisam ser reconfirmados: como o modo de pensamento está sempre ativado e o esforço de raciocínio padrão é max, caminhos de chamada que dependiam de desativar o raciocínio ou controlar o orçamento de pensamento precisam ser redesenhados, sob pena de latência e consumo de tokens acima do esperado. Segundo, a fonte relata que o modelo aceita texto, imagem e vídeo via API, mas explicitamente não aceita URLs públicas de imagens, exigindo base64 ou upload de arquivo com ID, o que é uma restrição concreta para a construção de requisições, tamanho e fluxo de upload em pipelines multimodais. Terceiro, o contexto de 1M e o limite máximo de saída de 1.048.576 tokens significam que repositórios ou logs mais longos podem ser colocados em uma única requisição, mas a fonte lembra que se deve retornar a mensagem completa do assistente, e o K3 já alertava que descartar o histórico de raciocínio no harness causa saída instável; assim, manter a prática de truncar o histórico de raciocínio pode anular o ganho do contexto longo. Sobre preços, a fonte afirma que a versão padrão custa 2 dólares por milhão de tokens de entrada e 10 dólares de saída, e a Highspeed 4/20 dólares, ambos abaixo dos 3/15 dólares do K3 — trata-se do preço do fornecedor repassado pela fonte na data da reportagem, sujeito à página de preços do KimiSeek e à cobrança real das chamadas; preços mudam. Cabe esclarecer que o K3.1 Pro atualmente não consta no catálogo de modelos ao vivo do KimiSeek; a disponibilidade de API mencionada pela fonte refere-se ao lado do fornecedor.
Integração e avaliação
Recomenda-se avançar em duas decisões independentes, ambas análises condicionais e não conclusões da fonte. Decisão um: migrar ou não agentes de codificação ou de terminal existentes do K3 para o K3.1 Pro. A mudança relatada pela fonte é melhora geral nos benchmarks de codificação e redução de preço, mas tarefas de terminal científico ficaram claramente atrás. A escolha depende da composição da sua carga de trabalho: se as tarefas forem principalmente codificação em nível de repositório, correções estilo SWE e automação de terminal, pode-se fazer um lançamento gradual com pouco tráfego; se incluírem alta proporção de computação científica, simulação ou tarefas de terminal de pesquisa, deve-se manter o modelo anterior ou roteamento paralelo. Critério mensurável de avaliação: comparar, no seu próprio conjunto de tarefas de codificação, a taxa de conclusão e a proporção que exige correção humana entre K3 e K3.1 Pro, registrando também o total de tokens necessário para atingir a mesma qualidade, convertendo o custo por tarefa com a estrutura de preços repassada pela fonte; só ampliar o tráfego quando a taxa de conclusão não cair e o custo por tarefa diminuir. Decisão dois: ativar ou não a variante Highspeed. A mudança relatada pela fonte é que a Highspeed é 2 a 3 vezes mais rápida, mas com preço unitário maior e esforço de raciocínio fixo em max. A escolha depende de haver restrição de latência interativa: se for para completação inline em IDE ou ciclos de agente com alternância humano-máquina, e as requisições tolerarem o comprimento de saída do esforço fixo max, pode-se testar a Highspeed primeiro; se forem tarefas em lote offline e sensíveis a custo, a versão padrão é mais razoável. Critério de avaliação: medir, sob concorrência fixa, a latência P95 ponta a ponta e o número de tarefas concluídas por segundo, calculando se a redução de latência compensa o aumento do preço unitário. Pré-requisito comum às duas decisões: primeiro verificar se as restrições de parâmetros na documentação de início rápido batem com o cliente existente, especialmente a temperatura e top-p fixos e a não aceitação de URLs públicas em entrada visual; antes de qualquer troca, manter um interruptor de reversão, pois os pesos abertos ainda não foram lançados e não será possível auto-hospedar no curto prazo.
Limites e pontos a confirmar
É preciso deixar claro: o Kimi K3.1 Pro atualmente não está no catálogo de modelos ao vivo do KimiSeek; a disponibilidade de API mencionada pela fonte refere-se ao lado do fornecedor, e a integração deve ser guiada pela documentação do fornecedor e pelo catálogo real. A maioria dos números de benchmark da fonte é autodeclarada pela Moonshot, obtida em grande parte com esforço de raciocínio máximo e harness do Claude Code; os gráficos comparativos vêm da página de comparação do fornecedor, não confirmados nas páginas dos concorrentes, portanto não devem ser usados como conclusão de desempenho verificada de forma independente; algumas das vitórias vêm de benchmarks internos. O atraso evidente em tarefas de terminal científico é uma deficiência listada pela própria fonte, mas seus valores específicos também seguem o critério autodeclarado. Os pesos abertos estão previstos para novembro de 2026, uma expectativa repassada pela fonte, sujeita a mudanças; no momento não é possível auto-hospedar, e a escala de 2,8T aponta para implantação de serviço em múltiplos nós. Os preços são do fornecedor, repassados pela fonte na data da reportagem, e podem ser ajustados a qualquer momento. Limites de parâmetros de requisição, modo de pensamento sempre ativado e temperatura fixa vêm da documentação de início rápido citada pela fonte; o comportamento real deve seguir a documentação mais recente do fornecedor. Além disso, já houve reportagens recentes cobrindo o lançamento deste modelo; o valor desta fonte está em complementar restrições de integração e detalhes técnicos, não em confirmar a estreia.