Liquid AI lança LFM3: seis modelos de classe 2B com um backbone compartilhado e as escolhas de pesos abertos na borda
Segundo o blog da Liquid AI de 27 de outubro de 2026, o LFM3 unifica modelos de texto, visão, áudio, omni e decisão em um backbone compartilhado de nível 1,7B, com a alegação de pesos totalmente abertos e ajuste fino em uma única GPU; desenvolvedores precisam reavaliar as duas rotas: modelo único omni versus modelos pequenos especializados.

O que mudou
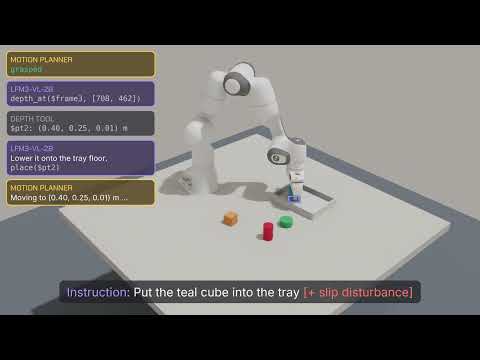
A Liquid AI publicou a série LFM3 em seu blog oficial em 27 de outubro de 2026. Segundo o blog, a série inclui seis modelos de classe 2B: LFM3-1.7B (texto), LFM3-VL-2B (entrada de texto, imagem e vídeo), LFM3-Audio-2B (entrada de texto e áudio, saída de texto e fala), LFM3-Omni-2B (entrada omni, saída de texto e fala), além dos modelos de decisão d1-2B e d1-omni-2B baseados nos ramos de visão e omni; há também o LFM3-1.7B-Base para pós-treinamento próprio. O fabricante afirma que todos os modelos derivam do mesmo backbone, estão disponíveis no Hugging Face e podem ser ajustados em uma única GPU; o modelo de texto ocupa cerca de 1 GB em precisão 4-bit, e a janela de contexto do backbone se estende a 256K tokens. O blog também traz alguns números comparativos, como LFM3-1.7B obtendo 38,42 no WebArena-Verified contra 3,02 do antecessor LFM2.5-2.6B; a média do LFM3-VL-2B em 62 benchmarks visuais subiu de 57,6 para 71,4. O fabricante também alega que, por parâmetro, o LFM3-1.7B equivale ao LFM2-1.2B em prompts curtos em dispositivos de borda, e é cerca de 25% mais rápido com 8K tokens de contexto. Todos esses números são declarados pelo fabricante, sem reprodução independente.
Impacto para desenvolvedores
O impacto central deste lançamento para desenvolvedores não é mais um modelo disponível, mas uma mudança na granularidade da escolha: antes, para rodar multimodalidade no dispositivo, muitas vezes era preciso encadear ASR, modelo de linguagem visual e TTS em um pipeline; agora o fabricante oferece a opção de um único modelo omni, mas mantém modelos unimodais, o que indica que a fusão multimodal pode não compensar em todos os cenários. As restrições de inferência também mudam: o modelo visual exige transformers 5.21.0 ou superior, os modelos de áudio e omni exigem 5.20.2 ou superior, o d1 exige 5.19 ou superior, e a maioria dos exemplos depende de trust_remote_code, tornando a atualização do framework e a auditoria de código remoto personalizado tarefas prévias à integração. Em memória para borda, cerca de 1 GB em 4-bit para o modelo de texto é um número planejável, mas o blog não informa o consumo de VRAM ou memória dos modelos visual e de áudio; o custo real de recursos para entrada de vídeo e saída de fala em streaming precisa ser medido por conta própria. O blog destaca a eficiência do novo codificador visual e do LiquidCodec, alegando primeiro token de áudio em até 50 ms e síntese de fala cerca de 87 vezes em tempo real em uma única thread de CPU; essas métricas dependem fortemente de hardware e comprimento de entrada e não devem ser usadas diretamente para planejamento de capacidade em produção. O fabricante também oferece notebooks de ajuste fino cobrindo SFT, DPO, GRPO e pré-treinamento contínuo, que para equipes que precisam de terminologia privada e chamadas de ferramentas é a parte mais valiosa de testar antes dos scores de benchmark.
Integração e avaliação
Recomendação 1 (análise condicional): se a aplicação na borda precisa processar fala e imagem na mesma requisição, compare primeiro o modelo omni único com a combinação "modelo de áudio + modelo visual". A condição é que exista de fato correlação entre modalidades na mesma requisição, por exemplo, fazer uma pergunta falada sobre um quadro de imagem; se áudio e vídeo não se relacionam no negócio, modelos especializados costumam oferecer melhor controle. Critério testável: comparar latência do primeiro token, tempo de conclusão ponta a ponta e pico de memória nos mesmos exemplos reais, e verificar se o modelo omni apresenta degradação evidente em subtarefas de texto puro ou fala pura em relação aos modelos especializados. Recomendação 2 (análise condicional): se você já tem um serviço de inferência baseado na série LFM2.5, não troque apenas com base em números do fabricante como 38,42 contra 3,02 no WebArena-Verified; faça primeiro um A/B com suas próprias trajetórias de agente. A condição é que a carga de trabalho seja predominantemente de chamadas de ferramentas em contexto longo; o blog afirma que os ganhos se concentram em tarefas de agente e contexto longo, e que a comparação em prompts curtos é por parâmetro, não equivalência absoluta de desempenho. Critério testável: registrar no seu próprio conjunto de tarefas a taxa de sucesso de chamadas de ferramentas, a taxa de conformidade de formato e o tempo real por mil tokens, em vez de olhar apenas rankings públicos. Recomendação 3 (análise condicional): se você se interessa mais por julgamento estruturado do que por geração de texto, avalie se o d1-2B pode substituir a solução "pequeno modelo de linguagem + pós-processamento de parsing". O pré-requisito é que o negócio aceite saídas de probabilidade calibradas em vez de linguagem natural; se o downstream precisa de texto interpretável, a rota d1 não é adequada. Critério testável: usar tickets ou faturas históricas anotadas para calcular o erro de calibração de cada campo e comparar a latência de uma passagem direta com o pipeline atual.
Limites e pontos a confirmar
A fonte é o blog do fabricante; scores de benchmark, velocidade e números de memória são todos autodeclarados, sem reprodução independente ou metodologia completa de avaliação, e a consistência interna das comparações do blog (por exemplo, parte das comparações de codificadores usa um backbone de linguagem LFM2.5-230M uniforme) também precisa ser verificada por conta própria. O blog afirma que todos os modelos LFM3 têm pesos abertos, mas o texto não especifica os termos de licença; pesos abertos não equivalem a licença de código aberto, e os direitos de uso comercial, redistribuição e publicação após ajuste fino devem ser confirmados no cartão do modelo e no texto da licença, não inferidos da disponibilidade de download dos pesos. Os modelos LFM3 não têm entradas correspondentes no catálogo online do KimiSeek atualmente; esta versão não está disponível no KimiSeek no momento; o blog também não oferece API hospedada, e a disponibilidade mencionada refere-se ao download de pesos no Hugging Face e à execução local. Se surgirem serviços hospedados ou preços separados no futuro, vale consultar as páginas oficiais. Além disso, os exemplos dependem de trust_remote_code, e ambientes de produção exigem auditoria própria do código remoto; o desempenho real e o consumo de recursos de entrada de vídeo, fala em streaming e tradução de fala multilíngue têm apenas poucos exemplos no blog e precisam de validação própria.
Ilustrações da notícia original