Meta abre os pesos do Muse Spark Open: MoE de 816 bilhões pode rodar localmente em dois Mac Studio, com benchmarks de programação abaixo do GLM 5.3 max e do Kimi K3 max
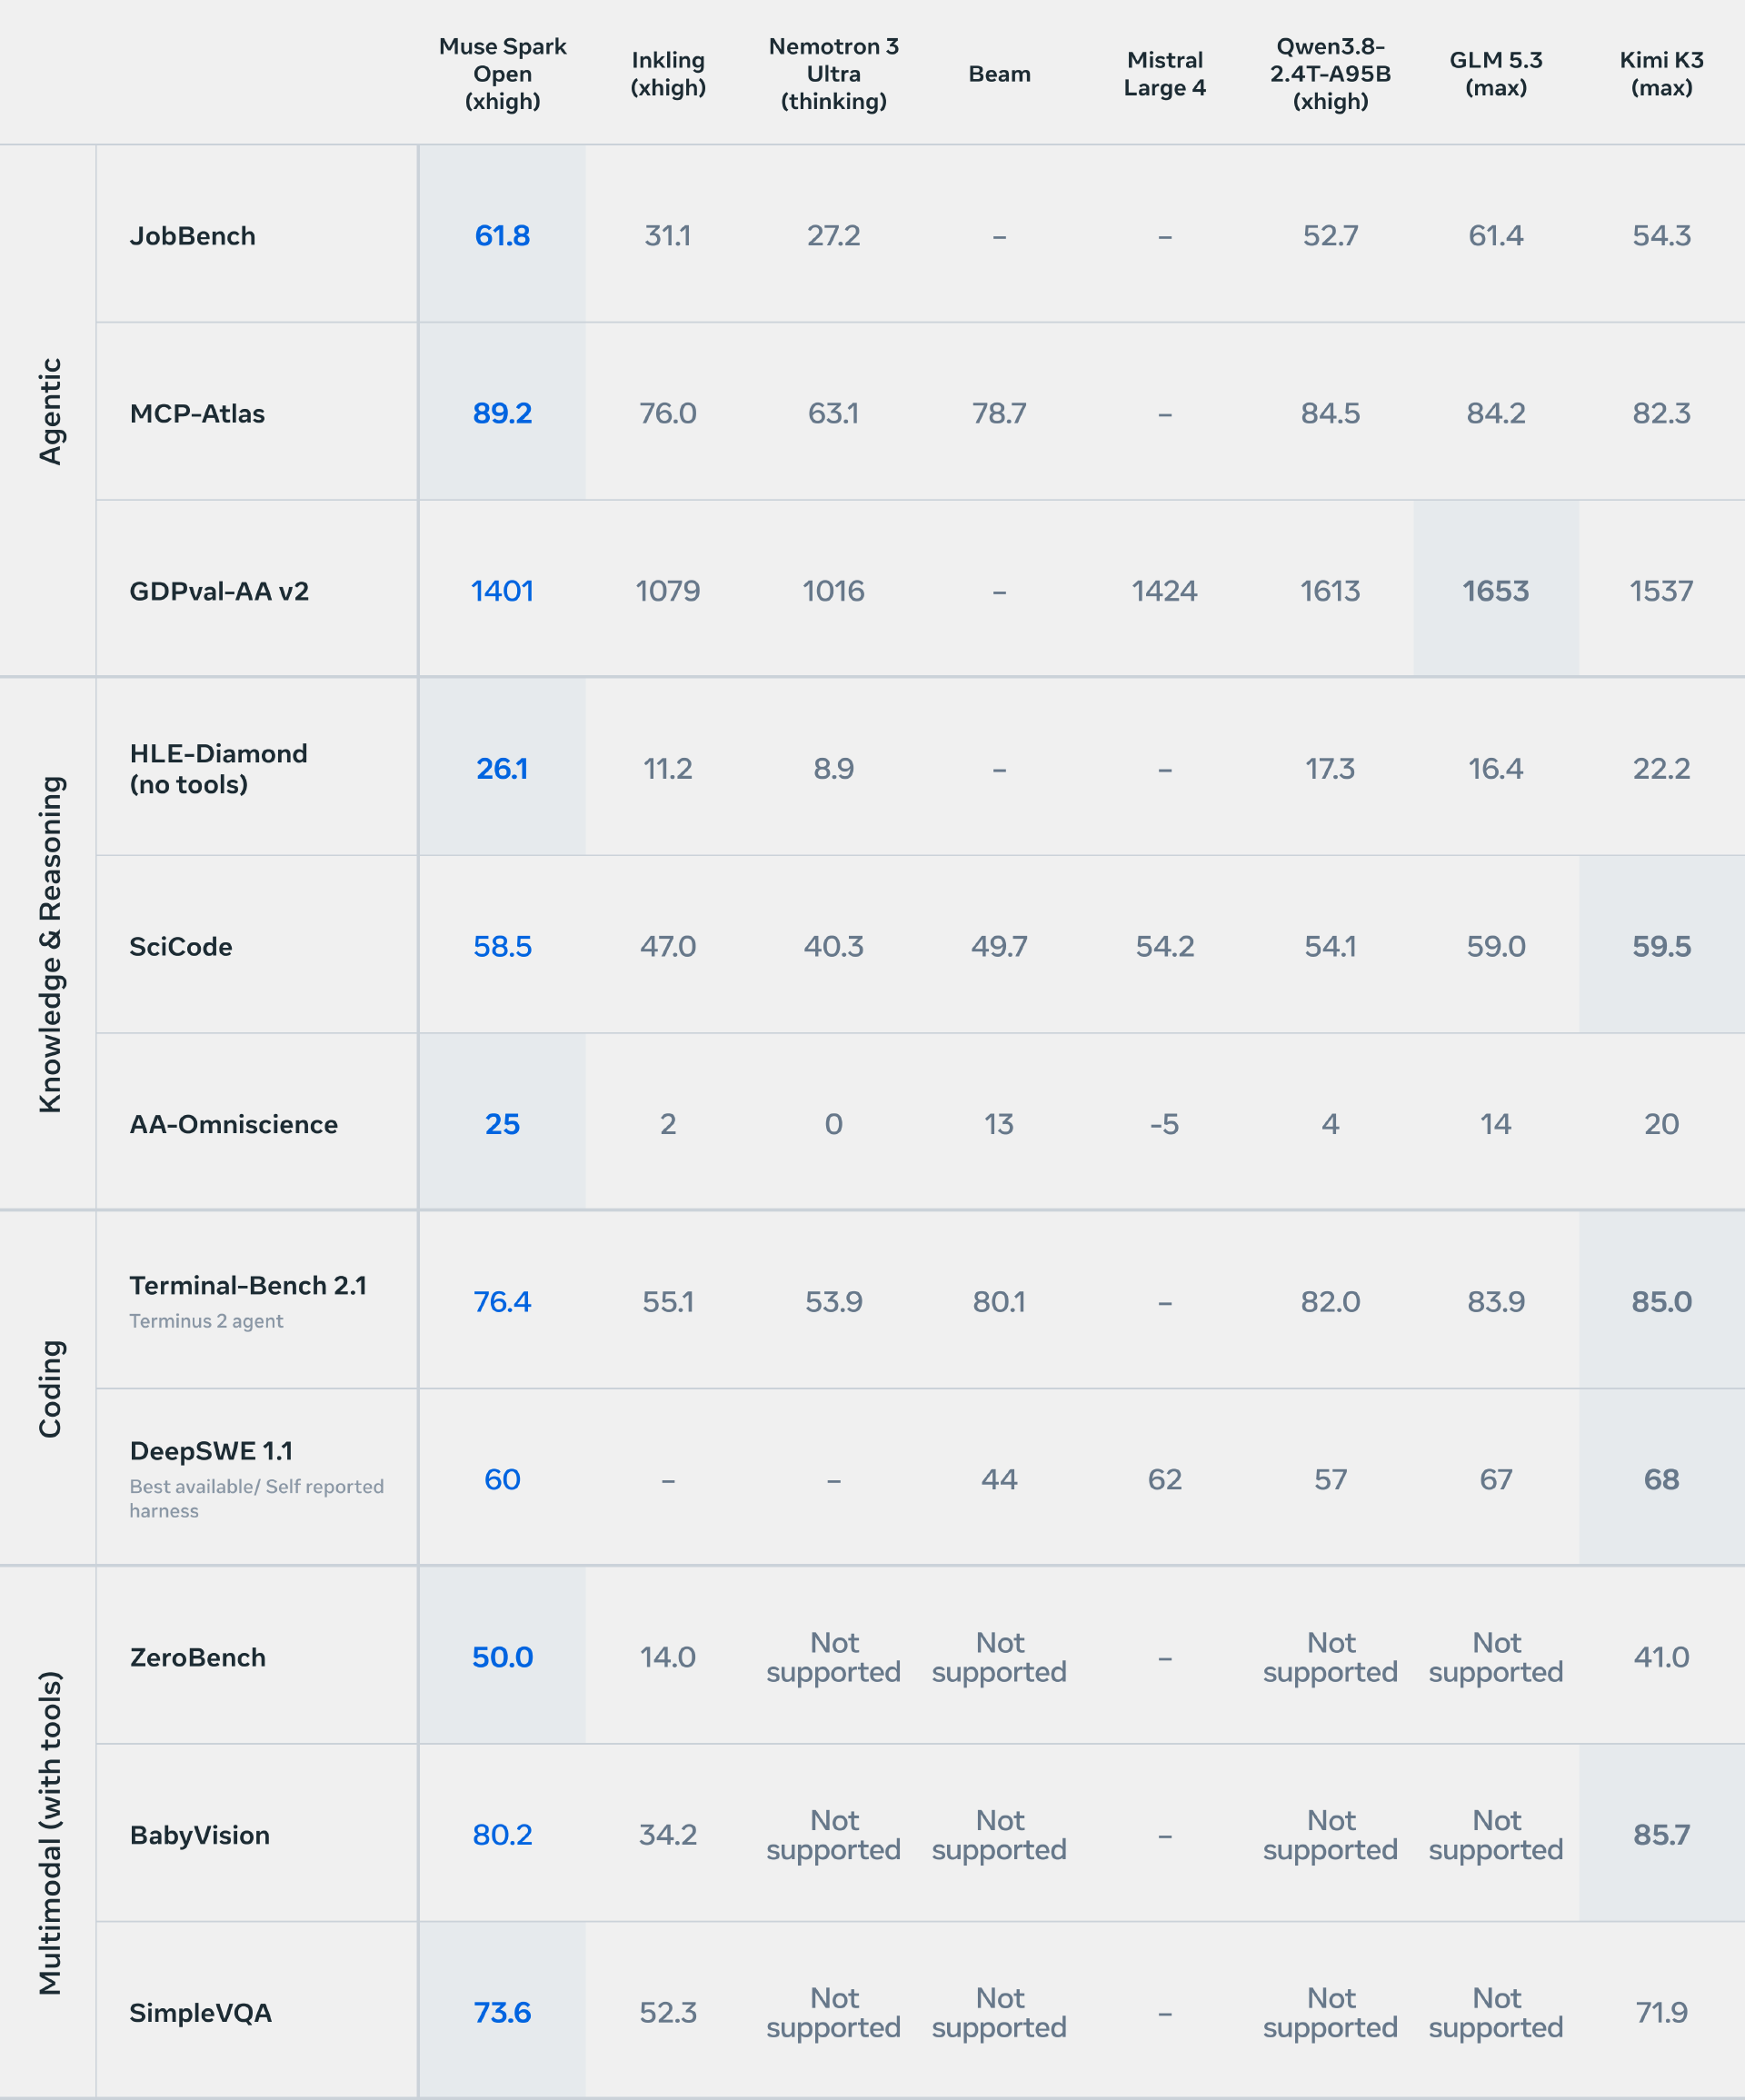
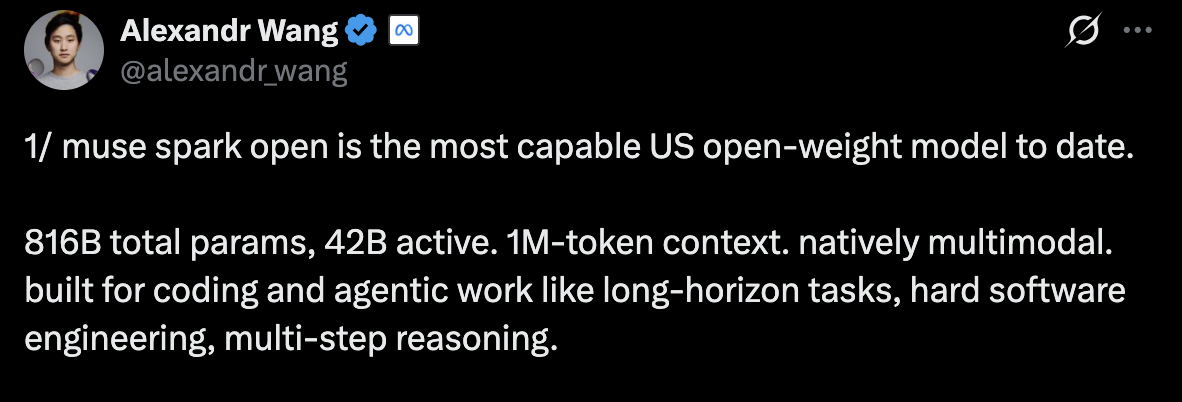
Segundo o InfoQ em 18 de outubro de 2026, a Meta abriu os pesos do Muse Spark Open em 15 de outubro: um MoE esparso com 816 bilhões de parâmetros totais e cerca de 42 bilhões ativados, contexto de aproximadamente 1,05 milhão de tokens e entradas de texto, imagem, áudio e vídeo, implantável em duas Mac Studio M5 Ultra via MLX; a reportagem afirma que seus resultados no Terminal-Bench 2.1 e DeepSWE 1.1 ficam abaixo do GLM 5.3 max e do Kimi K3 max, com licença Muse Model License.
O que mudou
Segundo o InfoQ em 18 de outubro de 2026, a Meta anunciou em 15 de outubro, no horário local, a abertura dos pesos do modelo Muse Spark Open, posicionado como um grande modelo de agente voltado para engenharia de software, execução de tarefas de longo horizonte e raciocínio em múltiplas etapas, e que a Meta descreve como o modelo de pesos abertos mais capaz dos Estados Unidos até o momento. O modelo usa arquitetura de mistura de especialistas esparsa, com 816 bilhões de parâmetros totais e cerca de 42 bilhões ativados por token, suporta contexto de 1.048.576 tokens, aceita entradas de texto, imagem, áudio e vídeo, e gera texto. A reportagem informa que os resultados divulgados pela Meta são JobBench 61,8, MCP-Atlas 89,2 e OSWorld Verified 80,4, e, para programação, Terminal-Bench 2.1 76,4 e DeepSWE 1.1 60, observando que estes dois últimos ficam abaixo dos modelos de pesos abertos da China GLM 5.3 max e Kimi K3 max. A execução local é feita via MLX em duas Mac Studio com M5 Ultra, e a Apple divulgou que um teste distribuído em quatro máquinas ultrapassa 36 tokens por segundo na geração; a documentação oficial indica pesos BF16 de cerca de 1,65 TB e NVFP4 de cerca de 537 GB. A licença é a Muse Model License, que exige a exibição de um aviso de atribuição especificado e, para licenciados com receita anual combinada superior a 20 milhões de dólares que ofereçam o modelo como serviço, requer notificação e acordo escrito separado, além de listar exceções como uso interno, pesquisa e outros casos.
Impacto para desenvolvedores
Para desenvolvedores, o significado direto deste lançamento não é "mais um peso para baixar", mas sim que ele decompõe as variáveis de decisão da implantação de grandes modelos do número de parâmetros em três coisas: armazenamento dos pesos, computação por token e comunicação entre dispositivos. A distinção entre 816 bilhões de parâmetros totais e cerca de 42 bilhões ativados é crucial: o primeiro determina se cabe, o segundo se é possível calcular. Segundo os números da reportagem, BF16 de cerca de 1,65 TB exige 8 GPUs B300, NVFP4 de cerca de 537 GB exige 4 GPUs B300, e o teste da Apple usa NVFP4, não BF16; isso significa que quantização e paralelismo multi-máquina são pré-requisitos para a implantação em desktop, e nenhum deles explica o resultado sozinho. Além disso, dois Macs com 512 GB de memória cada não se combinam em uma máquina de cerca de 1 TB com endereçamento unificado; a comunicação entre máquinas exige RDMA e comunicação coletiva do MLX, de modo que os ganhos de escala ficam limitados pela comunicação. Para equipes que já usam GLM 5.3 max ou Kimi K3 max em codificação e tarefas de longo horizonte, essa comparação oferece um candidato para substituição ou complementação, mas a reportagem também lembra que o Muse Spark Open não lidera no Terminal-Bench 2.1 nem no DeepSWE 1.1, e que as demonstrações oficiais (desenvolvimento iOS do Ice Cubes, seleção quadro a quadro no DaVinci Resolve) são vitrines do fabricante e não podem ser extrapoladas para dizer que tarefas semelhantes funcionam sem supervisão.
Integração e avaliação
O que segue são sugestões e análises condicionais baseadas no conteúdo da reportagem, não fatos verificados. Primeiro, se sua carga de trabalho envolve chamadas de ferramentas de longo horizonte e exige que os dados não saiam da máquina local, avalie primeiro a taxa de conclusão de tarefas do Muse Spark Open via API gerenciada antes de decidir se implanta por conta própria; os parceiros de ecossistema citados na reportagem incluem Baseten, Fireworks AI, Groq, Modal, Nebius, Together AI e OpenRouter, e as ferramentas de implantação cobrem SGLang, vLLM, TensorRT-LLM, llama.cpp e MLX. A condição para decidir se implanta por conta própria é ter aceleradores compatíveis com NVFP4 ou dois Macs com muita memória; as métricas avaliáveis são a taxa de sucesso ponta a ponta e a diferença de latência por tarefa entre a API gerenciada e a inferência local no mesmo conjunto de tarefas reais de chamadas de ferramentas. Segundo, ao escolher entre NVFP4 e BF16, a premissa dada pela reportagem é NVFP4 de cerca de 537 GB e BF16 de cerca de 1,65 TB; se sua memória de GPU ou unificada for insuficiente, será obrigatório usar NVFP4, com o custo de verificar a estabilidade de contextos longos após a quantização, e as métricas avaliáveis são a queda na precisão de recuperação de informação perto de 1,05 milhão de tokens e na taxa de sucesso de chamadas de ferramentas em comparação com BF16. Terceiro, se você oferece modelo como serviço a terceiros e sua receita anual combinada pode ultrapassar o limite de 20 milhões de dólares citado na reportagem, confirme a aplicabilidade da notificação e do acordo escrito separado antes de aplicar o modelo ou modelos derivados no negócio, e verifique se exceções como uso interno, pesquisa e produtos próprios que não sejam modelo como serviço cobrem seu cenário; esta é uma questão de termos de licença, que exige julgamento jurídico e não de engenharia. Quarto, se você planeja escalar com vários Macs, não estime a capacidade disponível pela soma da memória das máquinas; a reportagem aponta que a comunicação entre máquinas é um gargalo independente, e a métrica avaliável é se o ganho na velocidade de geração por token em configurações de duas e quatro máquinas cresce linearmente com o número de máquinas.
Limites e pontos a confirmar
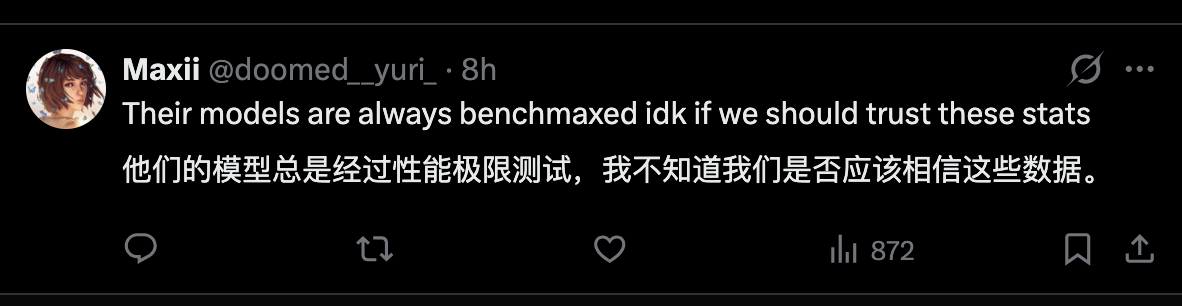
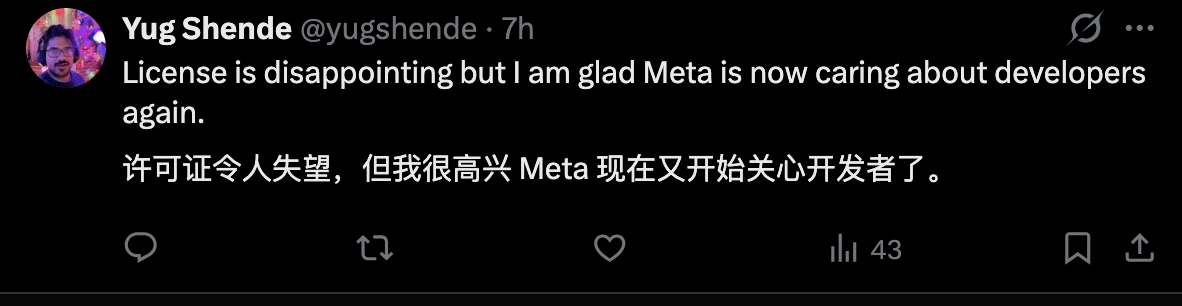
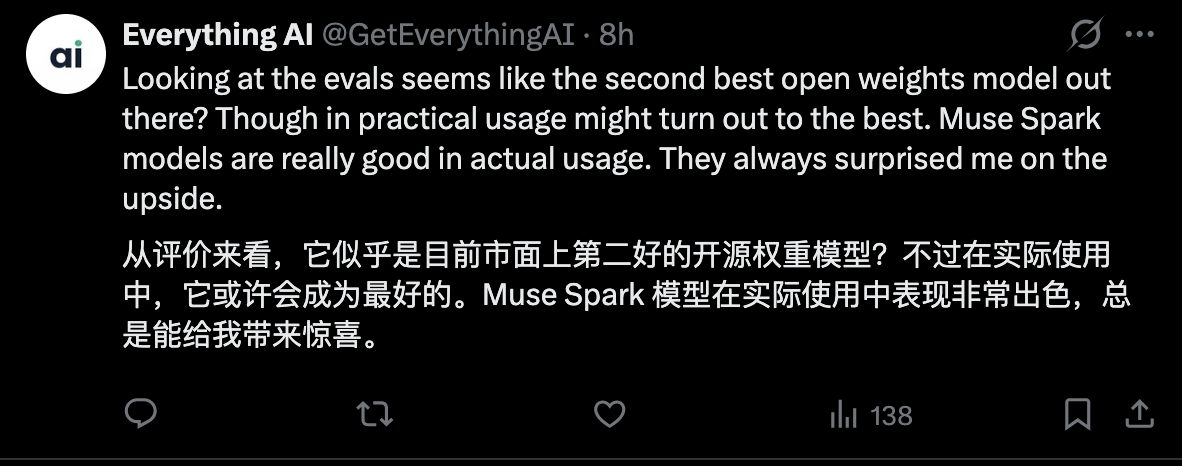
É preciso deixar claro: o Muse Spark Open e sua versão 816B-A42B não aparecem no catálogo de modelos em tempo real deste site, e o site não possui uma entrada para esse modelo; portanto, as disponibilidades gerenciadas e de API mencionadas acima referem-se ao fabricante e aos parceiros de serviço terceirizados listados por ele, e não indicam que sejam acessíveis por este site. Todas as pontuações de avaliação, tamanhos de peso, configurações de hardware e termos de licença citados na reportagem vêm da versão oficial da Meta e da transcrição do InfoQ; este artigo não as reproduziu de forma independente nem realizou testes. A comunidade tem reservas quanto à confiabilidade dos resultados de rankings, já citadas na reportagem. Pesos abertos não significam ausência de condições comerciais; as cláusulas de atribuição e de limite de receita da Muse Model License precisam ser confirmadas item por item no texto original, e a reportagem deixa explícito que existem exceções como uso interno e pesquisa, o que não deve ser simplificado como "todas as empresas de alta receita precisam pagar". As afirmações da reportagem sobre aceleração de 1,03 a 3,95 vezes em nível de operador e cerca de 3% de aceleração ponta a ponta em AMD MI350 pertencem a duas métricas diferentes, de operador e ponta a ponta, e não podem ser extrapoladas como aumento geral de velocidade de inferência. As demonstrações oficiais e citações de pessoas são declarações de terceiros e não podem ser consideradas evidência de capacidade sem supervisão. Além disso, o suporte a entradas de vídeo e áudio indica apenas capacidade de compreensão, não geração nativa; a implantação local reduz a necessidade de envio externo de dados, mas não concede automaticamente verificações de segurança e controles de acesso do lado de serviços gerenciados, e um agente com permissões amplas de arquivos e comandos ainda pode causar alterações equivocadas ou perda de dados.
Ilustrações da notícia original