Nemotron 3.5 Super VL chega ao SageMaker JumpStart: modelo alega contexto de 1 milhão, endpoint limita a 15.600
Um blog da AWS de 9 de novembro anunciou que o Nvidia Nemotron 3.5 Super VL está disponível no SageMaker JumpStart, com variantes NVFP4 e BF16. São 120B parâmetros totais e 12B ativos, com pesos sob licença OpenMDW 1.1; porém, a configuração de serviço do endpoint gerenciado limita o contexto a 520 a 15.600 tokens.
O que mudou
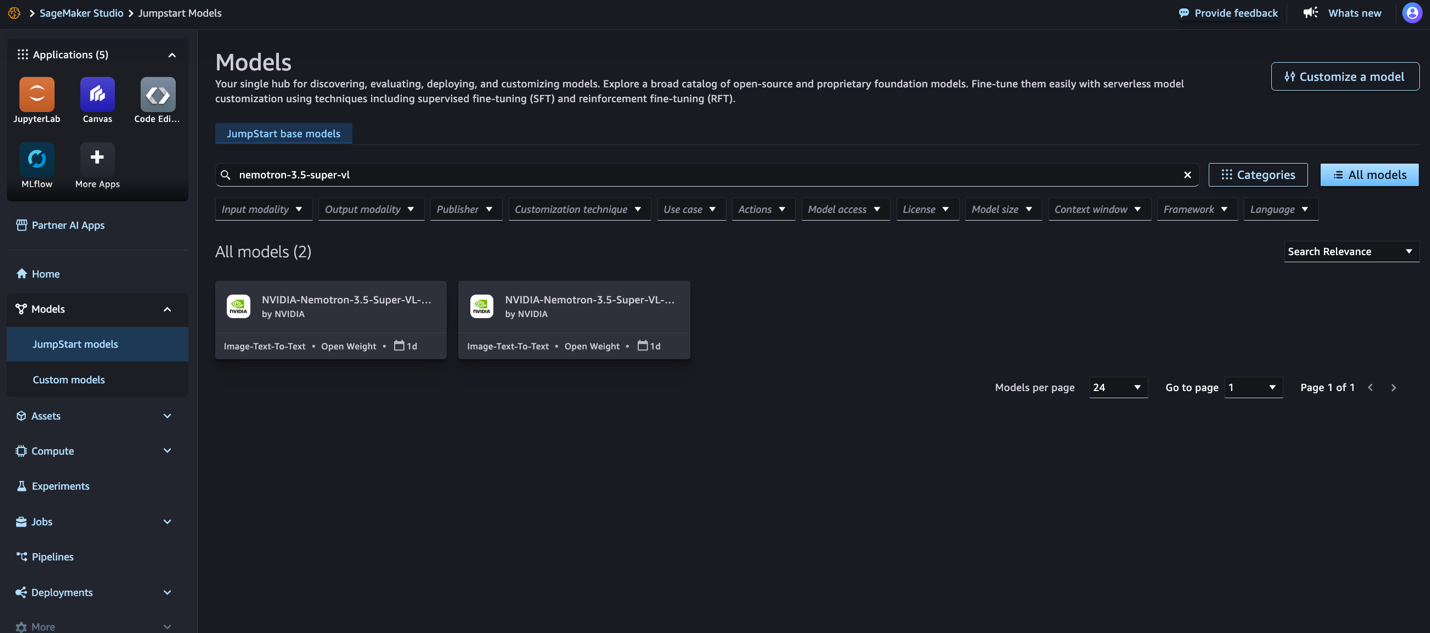
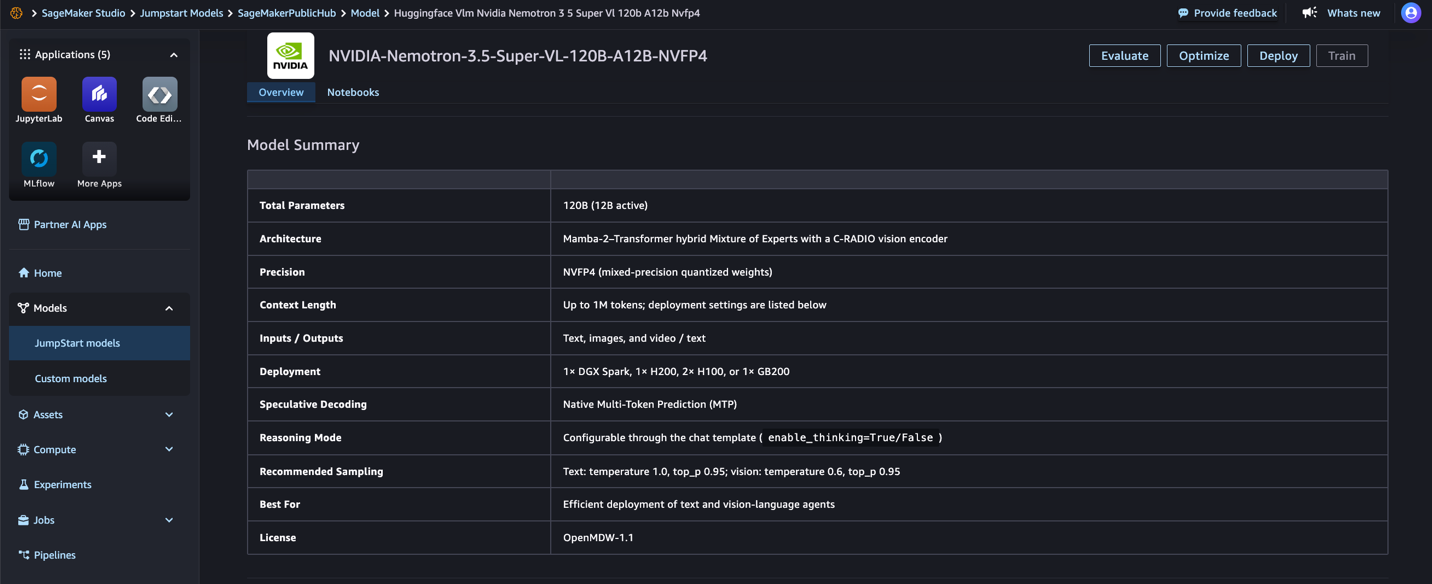
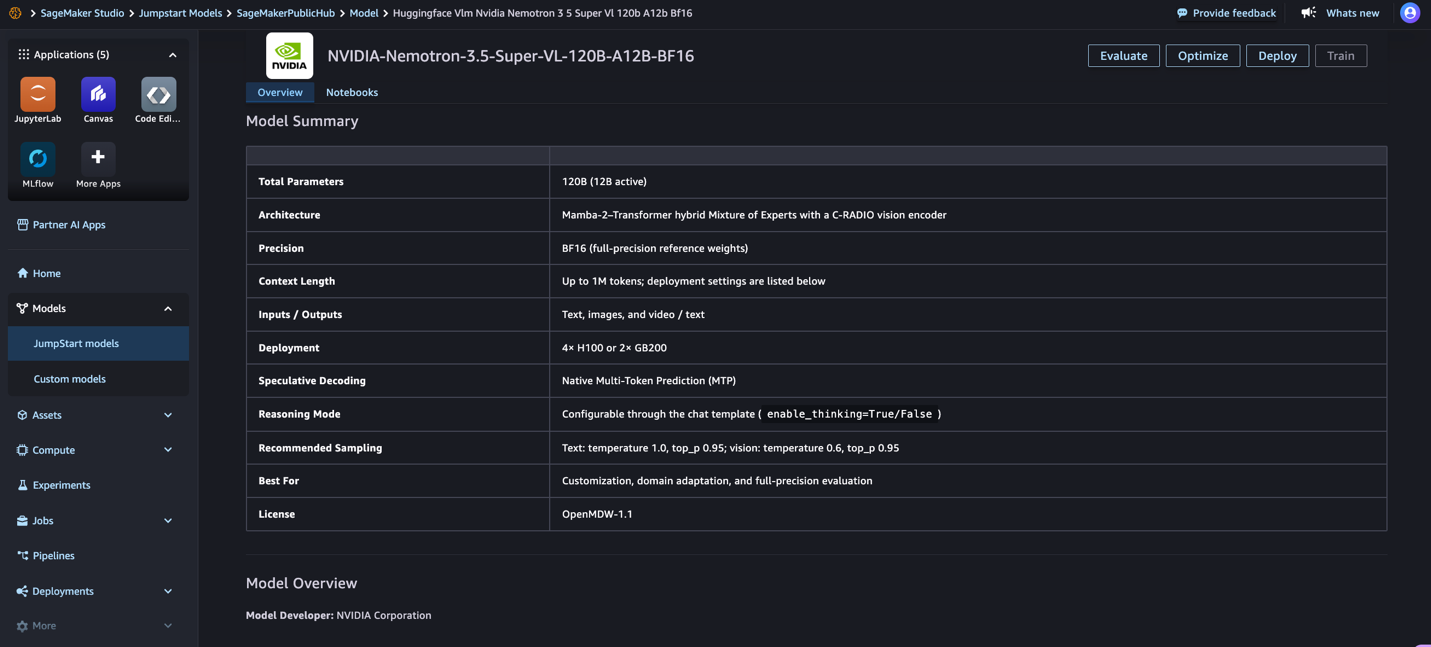
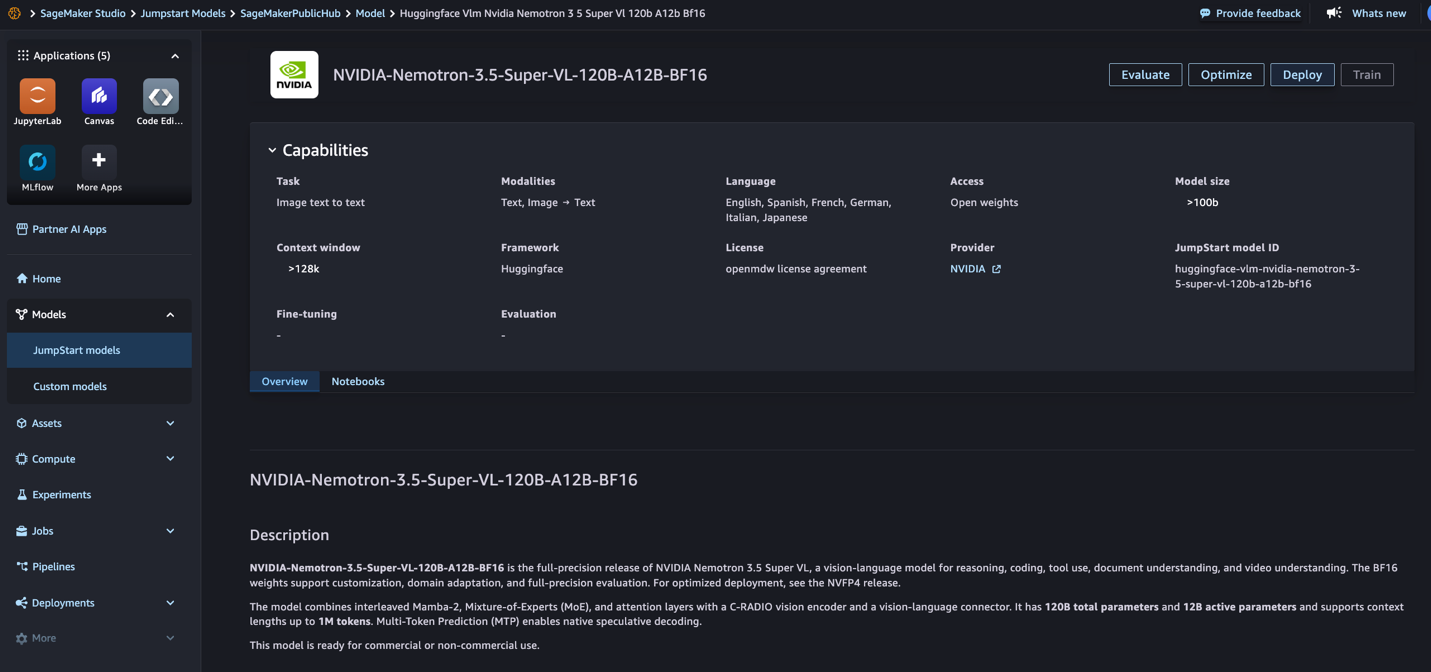
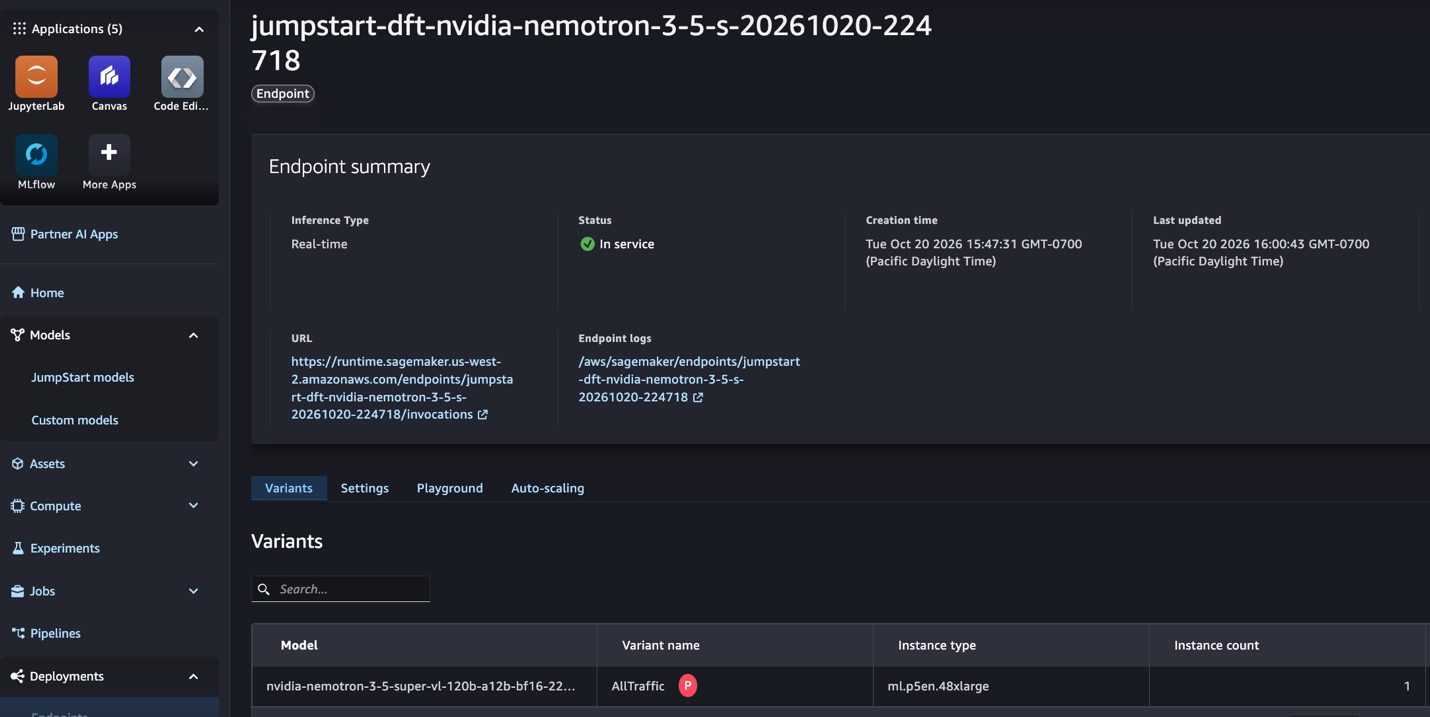
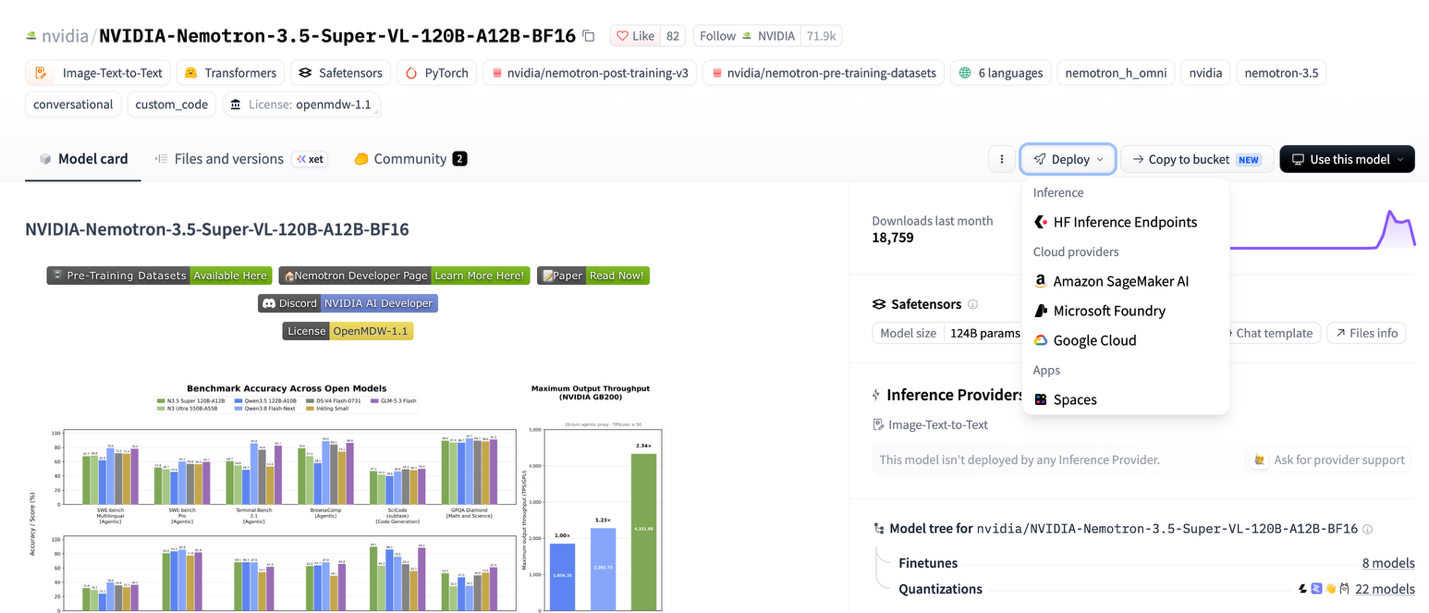
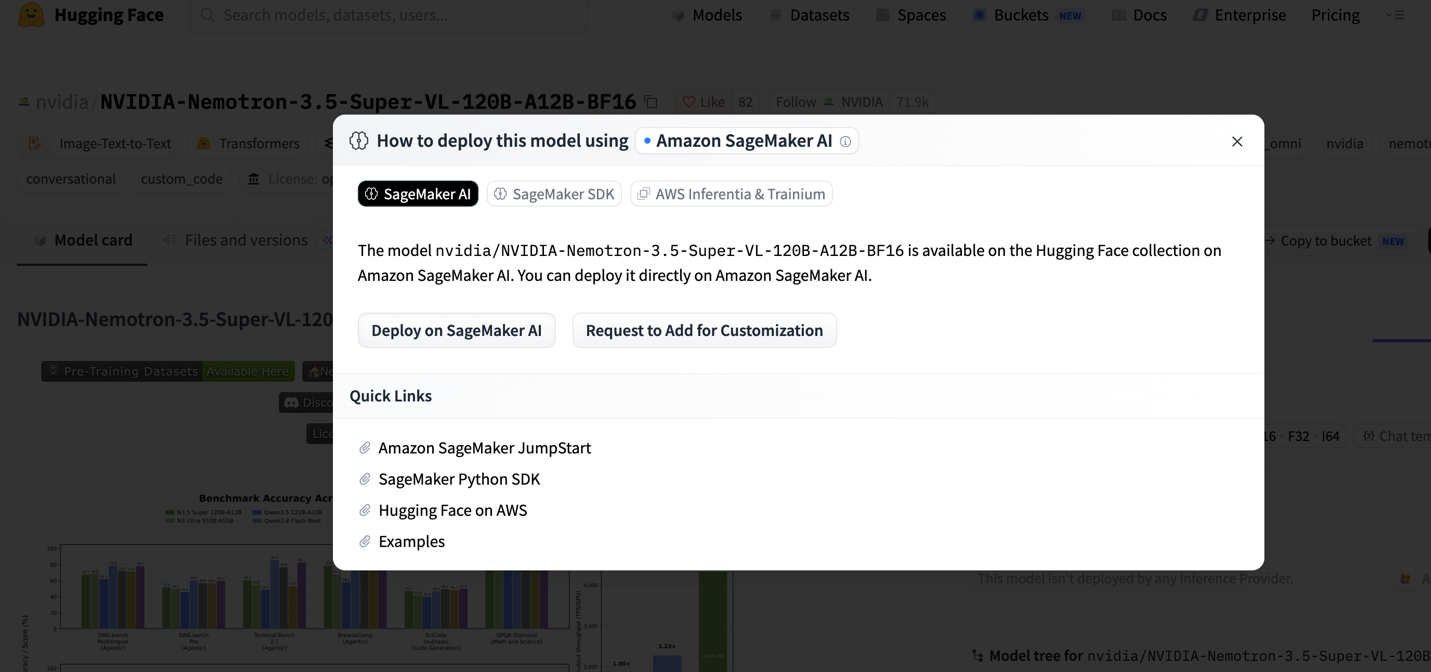
Segundo um blog da AWS publicado em 9 de novembro de 2026 (autores Venu Kanamatareddy, Evan Kravitz e Naidile Murali), o Nvidia Nemotron 3.5 Super VL já está disponível no Amazon SageMaker JumpStart. Conforme o blog, o modelo é um modelo de visão e linguagem da série Nemotron 3.5, que aceita entradas de imagem, vídeo e texto e produz texto, com backbone de linguagem de 120B parâmetros totais e 12B ativados por token: 88 camadas empilhadas alternando Mamba-2 e MoE (512 especialistas roteados, 22 ativados por token), intercaladas com 8 camadas de atenção, backbone inicializado a partir do Nemotron 3 Super Base e destilado do Nemotron 3 Ultra Base, e lado visual usando um codificador C-RADIO. O JumpStart oferece duas variantes: a NVFP4, obtida do BF16 por destilação com reconhecimento de quantização, com cerca de 75GB, roda em instâncias G7 com RTX PRO 4500 Blackwell, executando com pesos e ativações de 4 bits; a BF16, com pesos de referência em precisão total, tem cerca de 249GB e roda em 8 H200 de uma ml.p5en.48xlarge. Os pesos são fornecidos sob a licença OpenMDW 1.1 e o modelo suporta inglês, francês, alemão, italiano, japonês, espanhol e chinês. O blog afirma que o modelo suporta contexto de até 1 milhão de tokens, mas a configuração de serviço do JumpStart vai apenas de 520 a 15.600 tokens; o checkpoint traz uma cabeça de predição multi-token própria, a configuração de serviço do JumpStart não habilita decodificação especulativa e o endpoint também não carrega adaptadores LoRA.
Impacto para desenvolvedores
O primeiro efeito para desenvolvedores está na forma da interface. Segundo o blog, o endpoint do JumpStart expõe uma interface de chat completions baseada em vLLM, com o raciocínio habilitado por padrão, e o conteúdo de pensamento é retornado no campo reasoning da mensagem, separado do content; isso significa que clientes que hoje leem apenas um único campo content precisam ser adaptados, sob pena de perder o texto principal ou tratar o processo de raciocínio como texto principal. Mídias precisam ser enviadas embutidas como data URLs base64, porque o endpoint tem isolamento de rede e não consegue buscar URLs, o que aumenta bastante o tamanho do corpo da requisição e inviabiliza diretamente abordagens como “mandar um link para o modelo baixar sozinho”. O segundo efeito está no planejamento de capacidade. O model card fala em contexto de até 1 milhão de tokens, mas a configuração de serviço do endpoint gerenciado oferece na prática apenas 520 a 15.600 tokens, e cada requisição aceita somente uma imagem e um vídeo. Uma imagem de página de 1.536×1.024 consome cerca de 1.536 tokens, e o blog também afirma claramente que o modelo recebe imagens, não PDFs brutos, sendo necessário renderizar cada página como imagem. A partir disso, infere-se que um PDF de algumas dezenas de páginas não pode ser enviado de uma vez por esse caminho gerenciado, restando fazer requisições página a página ou juntar várias páginas em uma única imagem e então comprimir o orçamento de contexto. O terceiro efeito está na expectativa de latência. A medição apresentada no blog é que, na configuração generate (250 tokens de entrada, 1.500 tokens de saída, 5 fluxos concorrentes em streaming), a NVFP4 em G7 gera cerca de 63 tokens/segundo por requisição, com primeiro token em cerca de 0,45 segundo; porém, a mesma g7.24xlarge, na configuração summarize com 10.000 tokens de entrada, tem primeiro token de 12,62 segundos. Requisições de imagem e vídeo costumam cair no lado dos prompts longos, e essa ordem de grandeza do primeiro token merece ser medida antes de usar o modelo como agente de GUI interativo. Em qualidade, o blog cita cinco benchmarks multimodais do model card da NVIDIA (com raciocínio habilitado): MMLongBench-Doc 62,82 contra 62,82, OCRBench v2 inglês 68,12 contra 68,34, CharXiv reasoning 80,82 contra 79,88, Video-MME v2 32,85 contra 32,54 e OSWorld-Verified 51,14 contra 52,30, sendo o primeiro valor BF16 e o segundo NVFP4. O blog afirma que as configurações de avaliação foram mantidas consistentes, mudando apenas o checkpoint. São números divulgados pelo próprio fabricante, sem reprodução independente conhecida.
Integração e avaliação
As três recomendações a seguir são condicionais e baseadas nos fatos relatados, não conclusões já verificadas. Primeiro, decida a variante. A mudança relatada é que o JumpStart oferece simultaneamente os checkpoints NVFP4 e BF16, com NVFP4 como padrão e início em ml.g7.24xlarge, e BF16 apenas em ml.p5en.48xlarge. A escolha a fazer é: para serviço puramente de inferência, comece com NVFP4; só baixe os pesos de referência BF16 para autohospedar se for fazer SFT, aprendizado por reforço, destilação, adaptação de domínio ou quantização personalizada. A premissa que muda essa escolha é a necessidade de ajuste fino: o blog afirma claramente que o endpoint oferece apenas os pesos base e não carrega adaptadores LoRA; se seu plano depende de troca dinâmica de LoRA, o caminho gerenciado simplesmente não se aplica. Um critério testável é rodar os dois checkpoints no mesmo lote de capturas de tela de documentos e trechos de vídeo seus, comparar a diferença entre acurácia da tarefa e conformidade da saída JSON, e definir como aceitável uma diferença não superior ao nível de erro correspondente à sua taxa atual de revisão humana. Segundo, decida a configuração de serviço antes de falar de contexto. A mudança relatada é que inference_config_name determina o comprimento do modelo: generate 2.275, interact 520, summarize 13.650, modify 15.600 tokens, e os exemplos de imagem, vídeo e raciocínio do blog usam todos modify. Na escolha, use modify para requisições com imagem, vídeo ou raciocínio em várias etapas, generate para extração de texto curto, e estime quantas páginas cabem por requisição considerando “uma página consome cerca de 1.536 tokens”. A premissa é que documentos de várias páginas precisam ser divididos em várias requisições ou unidos em uma única imagem. Um critério testável é medir, antes do lançamento, a taxa de rejeição por comprimento excedido e o tempo de primeiro token p95, usando os 12,62 segundos com 10.000 tokens de entrada como referência mínima do orçamento de latência. Terceiro, decida o interruptor de raciocínio. A mudança relatada é que o raciocínio vem habilitado por padrão, o conteúdo de pensamento é retornado separadamente, e requisições de vídeo com raciocínio devem ter max_tokens de pelo menos 8.192. Na escolha, desligue com enable_thinking=False para tarefas que exigem respostas curtas e diretas, como extração de campos de tickets e descrição de imagens, e mantenha o raciocínio para análise em várias etapas e localização em GUI. A premissa que muda a escolha é se a tarefa realmente precisa de etapas intermediárias. Um critério testável é comparar, no mesmo lote de amostras, a acurácia de extração de campos, o número de tokens de saída e a latência ponta a ponta com o raciocínio ligado e desligado, verificando se os tokens economizados compensam uma perda de precisão aceitável. Antes de implantar, confirme também a cota de ml.g7 (zero inicial em contas novas) e o SageMaker Python SDK na versão 3.25 ou superior, e passe explicitamente o tipo de instância, pois caso contrário o SDK recorre a ml.m5.large e a construção falha.
Limites e pontos a confirmar
A versão Nemotron 3.5 Super VL não está atualmente no catálogo de modelos do KimiSeek; a disponibilidade citada refere-se ao AWS SageMaker JumpStart, um serviço gerenciado do fabricante, e não a um modelo já listado neste site. As demais incertezas também devem ser preservadas: os cinco benchmarks citados vêm do model card da NVIDIA e são números divulgados pelo próprio fabricante; o próprio blog explica que os números de desempenho de NVFP4 e BF16 foram obtidos em sistemas de GPU e configurações diferentes, não em uma comparação de precisão isolada, portanto não se pode inferir perda de quantização diretamente ao comparar 63 tokens/segundo com 140,85 tokens/segundo. O contexto de 1 milhão de tokens alegado no model card não é exposto no endpoint gerenciado, e o limite real depende da configuração de serviço; a amostragem de quadros de vídeo é fixada na inicialização do endpoint, que também rejeita media_io_kwargs por requisição, de modo que controlar a amostragem por requisição exige autohospedagem. Os pesos são fornecidos sob a licença OpenMDW 1.1; pesos abertos não equivalem a licença de código aberto, e os termos de uso comercial, redistribuição e modelos derivados precisam ser lidos no texto original da licença. O texto-fonte não informa preços; o custo depende da instância escolhida, conforme a página de preços do AWS SageMaker; embora o chinês esteja na lista de idiomas suportados, o texto-fonte não apresenta dados de benchmark para cenários em chinês.
Ilustrações da notícia original