NVIDIA lança Nemotron 3.5 Bolt E4B: modelo de agente local voltado a 4 GB de VRAM, atrás do Qwen3.5-4B em benchmarks de uso de ferramentas
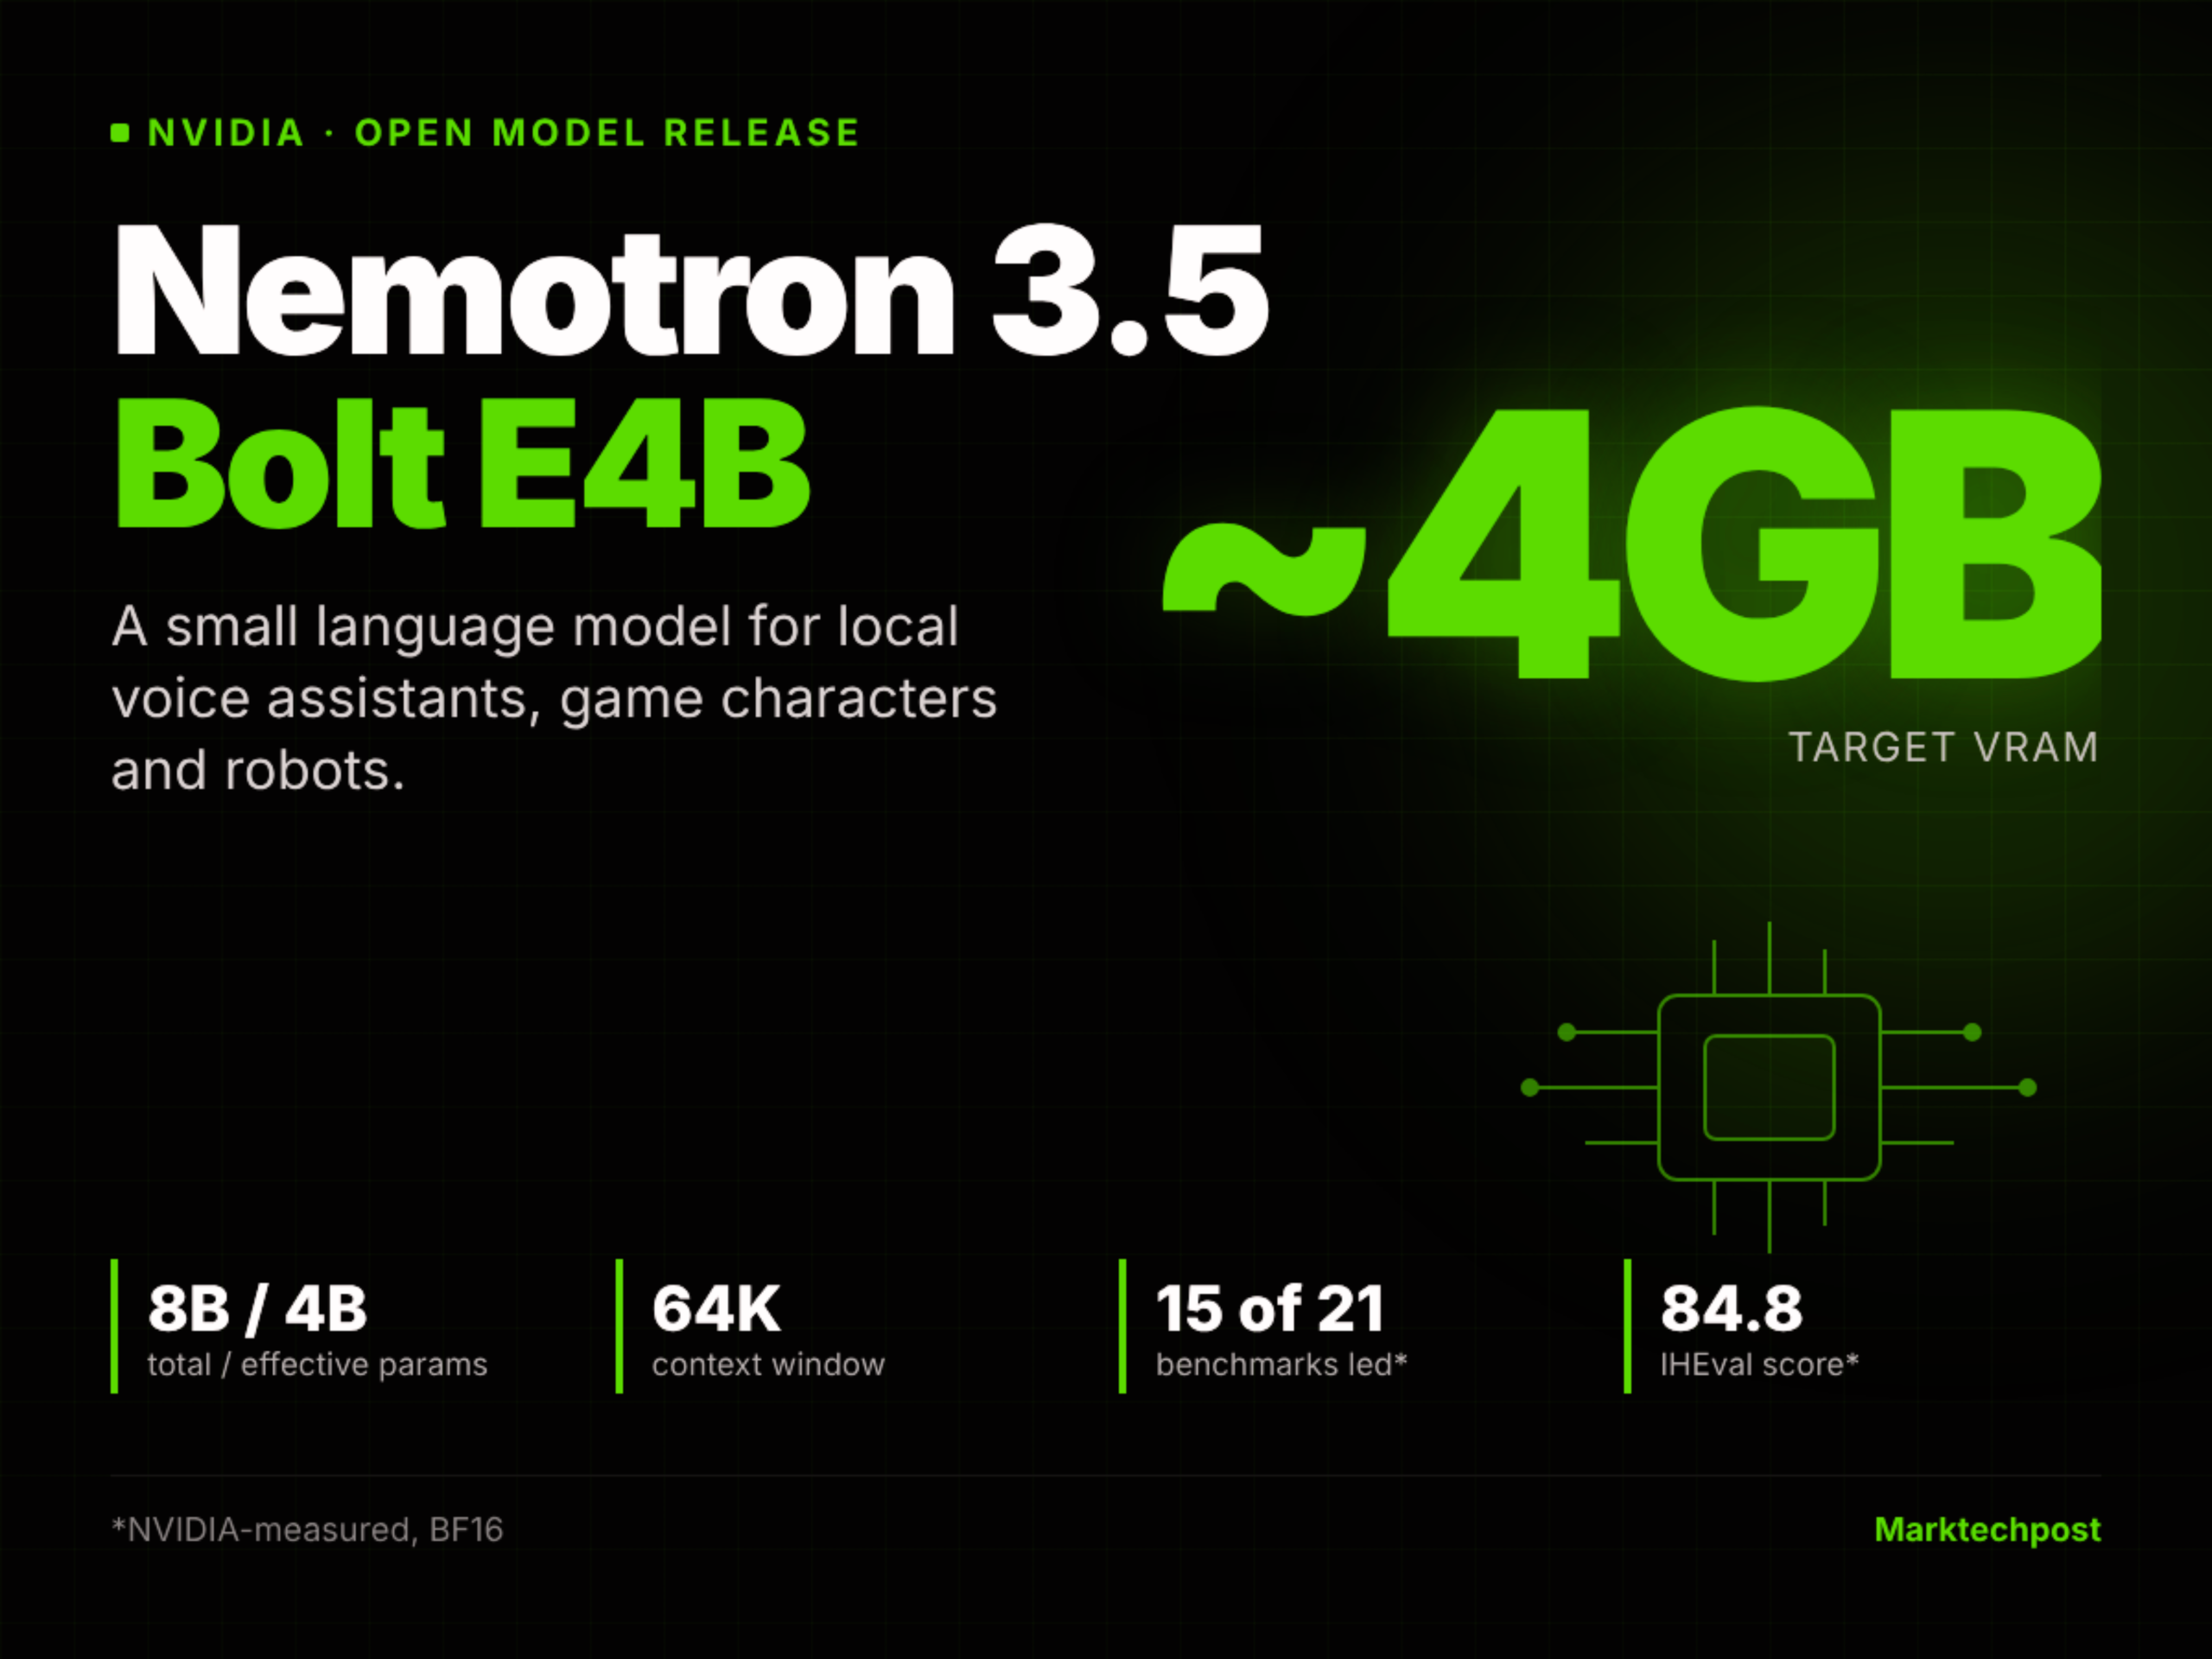
Segundo o MarkTechPost em 23 de outubro de 2026, a NVIDIA lançou o modelo de pesos abertos Nemotron 3.5 Bolt E4B, treinado a partir do Gemma 4 E4B apenas com aprendizado por reforço, com 8 bilhões de parâmetros totais, 4 bilhões efetivos e contexto de 64K, voltado a assistentes de voz locais, NPCs de jogos e robótica. Em 21 benchmarks medidos pelo próprio fabricante, lidera 15, mas no Tau2-Bench fica em 55,1 contra 75,1 do Qwen3.5-4B.
O que mudou
Uma reportagem do MarkTechPost de 23 de outubro de 2026 afirma que a NVIDIA lançou o Nemotron 3.5 Bolt E4B, partindo do Gemma 4 E4B do Google, pulando completamente o ajuste supervisionado e usando apenas RLVR e RLHF via NeMo-RL e NeMo-Gym no pós-treinamento; cada amostra de treino roda simultaneamente nos modos de raciocínio e não raciocínio, com proporção de 2:1 entre amostras não raciocinadas e raciocinadas no lote, e a penalidade de comprimento do ambiente GenRM inibe o alongamento das respostas; o dataset e a receita são públicos. O modelo tem 8 bilhões de parâmetros totais, 4 bilhões efetivos e contexto de 64K, suporta chamadas de ferramentas em múltiplas rodadas e instruções de chamadas assíncronas, traz um flag conversational_mode que gera respostas curtas adequadas à voz, e permite configurar a capacidade de raciocínio e o orçamento de pensamento em tempo de execução. A reportagem diz que é a terceira geração de modelos pequenos voltada a personagens de jogo do NVIDIA ACE, e mostra um robô Reachy Mini rodando num Jetson Orin Nano 8GB, em que o Cosmos 3 Edge cuida da visão e o Bolt das respostas de voz e chamadas de ferramentas. No lado da implantação, a NVIDIA quantizou o checkpoint BF16 para Q4_K_M com calibração por matriz de importância, usando cerca de 1 milhão de tokens de rollouts de RL para a calibração, e incluiu um drafter DFlash para decodificação especulativa: a reportagem afirma que o Bolt atinge 272,6 tokens/s no RTX 5070, contra 225,9 tokens/s do Gemma 4 E4B com seu drafter MTP. Testes de hardware (Q4_K_M, llama.cpp, batch size 1, 3K de entrada e 50 tokens de saída) mostram o RTX 5070 ocupando 3,5 GB de VRAM, com 548 ms para o primeiro token e 133,4 tokens/s; o Jetson AGX Orin 32GB ocupa 4,2 GB, com 3687 ms e 24,0 tokens/s; o Jetson Orin Nano 8GB ocupa 4,2 GB, com 5785 ms e 15,5 tokens/s. A reportagem enfatiza que "4GB" é uma faixa-alvo de VRAM e não o tamanho do arquivo: o GGUF Q4_K_M no Hugging Face tem 6,18 GB. O modelo publica os pesos sob licença OpenMDW-1.1, com dados e receita abertos, e já está disponível no Hugging Face, Ollama, LM Studio, Unsloth e Jetson AI Lab, além das formas NVIDIA NIM e In-Game Inferencing SDK, com uma API gratuita adicional na plataforma hospedada oficial da NVIDIA. Nos benchmarks, todos os números citados são em BF16, medidos pela NVIDIA no próprio framework NeMo-Gym: lidera em 15 dos 21, com IHEval 84,8 (Gemma 4 E4B 67,0, Qwen3.5-4B 60,6); Tau2-Bench 55,1, atrás do 75,1 do Qwen3.5-4B; RULER 64K em 87,0, também abaixo do 95,1 do Qwen3.5-4B; LongBench v2 (50,5 contra 59,9) e BFCL-v3 (68,5 contra 70,9) também favorecem o Qwen3.5-4B, enquanto o Gemma 4 E4B leva leve vantagem no EQ-Bench v3, com 41,1 contra 39,4. A reportagem também reproduz afirmações da NVIDIA: média cerca de 40% superior ao Nemotron 3 Nano 4B e, nas comparações com raciocínio ativado, até 80% menos tokens de saída.
Impacto para desenvolvedores
O efeito direto para desenvolvedores recai sobretudo sobre duas questões: orçamento de VRAM e divisão de tarefas. Os números de VRAM da reportagem referem-se apenas à inferência do modelo puro, sem reconhecimento de voz, síntese de voz ou modelos de visão; se você se basear na demonstração do Jetson Orin Nano 8GB, o modelo sozinho já ocupa 4,2 GB, e a margem restante define qual modelo de percepção cabe, se dá para aumentar a resolução de imagem e se é preciso migrar para um dispositivo de 16 GB ou mais. A diferença no tempo até o primeiro token também é decisiva: 548 ms no RTX 5070 e 5785 ms no Orin Nano são experiências de interação completamente distintas, e a segunda se aproxima mais de diálogo por turnos do que de conversa natural com interrupções. A distribuição de capacidades indica que ele serve melhor como peça especializada do que como modelo pequeno de uso geral. A NVIDIA reivindica liderança em apenas 15 dos 21 benchmarks de 5 domínios, e as derrotas se concentram em contexto longo e cadeia de ferramentas para agentes: Tau2-Bench, RULER 64K, LongBench v2 e BFCL-v3 perdem para o Qwen3.5-4B. Em contrapartida, notas de seguimento de instruções como IHEval 84,8 são seu ponto forte, e o conversational_mode também sinaliza intenção de projeto voltada a respostas curtas, rápidas e prontas para serem faladas. No conjunto, é um candidato para "conversa mais chamadas leves de ferramentas", e não a escolha padrão para planejamento complexo em múltiplas rodadas ou recuperação em contextos muito longos. É preciso considerar as diferenças de metodologia no julgamento. Todos esses números foram medidos pelo fabricante no próprio framework de teste e podem divergir de reproduções independentes; a reportagem também menciona que o Scale Labs, no MultiChallenge, aponta 56,03%, acima dos 53,1% autorreportados pela NVIDIA. A coexistência de dois conjuntos de números na mesma reportagem mostra que, na escolha, nenhuma nota isolada deve ser tratada como veredito, sobretudo quando a distribuição do seu negócio difere da dos benchmarks.
Integração e avaliação
A seguir, sugestões condicionais e análises de condições baseadas na reportagem, não conclusões já verificadas. Decisão 1: escolha a versão quantizada e a forma de implantação pela margem de VRAM do dispositivo-alvo. Se o dispositivo for um Jetson de 8 GB ou uma placa de 12 GB e precisar rodar voz e visão ao mesmo tempo, vale priorizar a verificação do caminho Q4_K_M com llama.cpp — os 4,2 GB ocupados e os 6,18 GB de arquivo indicam que o arquivo de pesos sozinho não cabe no orçamento de "4 GB"; a forma quantizada de execução é que é a utilizável. O critério testável é concreto: meça a latência até o primeiro token e os tokens/s no seu próprio comprimento de entrada (a reportagem usou 3K de entrada e 50 tokens de saída) e confirme que ainda há margem após somar o modelo de percepção; se o primeiro token ultrapassar o limite aceitável do projeto de interação, troque primeiro para um quantizado menor ou mais agressivo, em vez de continuar ajustando prompts. Decisão 2: decida se o Bolt entra em cena conforme a carga for ou não dominada por chamadas de ferramentas. Se o produto é um assistente de voz com diálogos curtos e algumas chamadas de ferramentas, vale testar seu conversational_mode e o contexto de 64K; se o núcleo for trajetórias longas de ferramentas com estado e múltiplas rodadas, a diferença de 55,1 contra 75,1 no Tau2-Bench sugere começar criando uma linha de base com o Qwen3.5-4B. O critério testável é montar um conjunto de avaliação fixo com as trajetórias reais de chamadas de ferramentas do seu negócio e comparar taxa de conclusão de tarefas e número médio de rodadas de chamadas sob o mesmo conjunto de definições de funções, em vez de olhar apenas se a resposta de uma rodada é fluente. Decisão 3: trate o orçamento de pensamento em tempo de execução como parâmetro a calibrar, não como interruptor. A reportagem afirma que o modelo suporta raciocínio configurável e orçamento de pensamento em tempo de execução, e que, nas comparações com raciocínio ativado, os tokens de saída caem até 80% (afirmação do fabricante). Isso significa que os mesmos pesos geram duas curvas distintas de latência e qualidade com o raciocínio ligado e desligado. A prática é definir um orçamento de latência para o fluxo de voz, escolher uma das opções dentro desse orçamento e usar o número de tokens de saída e o tempo até o primeiro pacote como métricas testáveis para verificar se a economia de tokens se sustenta na distribuição das suas tarefas. Decisão 4: a licença precisa ser verificada separadamente. A reportagem diz que os pesos saem sob OpenMDW-1.1, enquanto o modelo-base Gemma 4 E4B é Apache 2.0: os termos não são iguais. Antes de incorporar os pesos a um produto, leia diretamente o texto da licença para confirmar condições de distribuição, atribuição e uso comercial, em vez de inferir permissões a partir de rótulos como "pesos abertos".
Limites e pontos a confirmar
O Nemotron 3.5 Bolt E4B descrito neste texto não está disponível no KimiSeek: não há entrada correspondente na lista de modelos do site. A API gratuita mencionada na reportagem refere-se à disponibilidade desse modelo na plataforma hospedada oficial da NVIDIA e não tem relação com este site; a disponibilidade real e os termos devem ser confirmados na documentação do fabricante. Os limites conhecidos incluem: todas as notas de benchmark da reportagem são em BF16, medidas pela NVIDIA no próprio framework NeMo-Gym, não são reproduções independentes; a média cerca de 40% superior ao Nemotron 3 Nano 4B e a redução de até 80% nos tokens de saída com raciocínio ativado são autorreportadas pelo fabricante. A comparação de velocidade também tem diferenças de metodologia: 272,6 contra 225,9 tokens/s são resultados do Bolt com drafter DFlash e do Gemma 4 E4B com drafter MTP no RTX 5070, em metodologia diferente dos 133,4 tokens/s da tabela de hardware, e os dois não podem ser usados de forma intercambiável. No MultiChallenge, a NVIDIA autorreporta 53,1%, e um post no X reproduzido pela reportagem afirma que o Scale Labs aponta 56,03%: os dois números precisam ser atribuídos separadamente às suas fontes. Quanto à licença, o Bolt é publicado sob OpenMDW-1.1 e o modelo-base Gemma 4 E4B é Apache 2.0: pesos abertos não equivale a termos comerciais idênticos. Os dados de hardware cobrem apenas quatro faixas de dispositivos RTX e Jetson; não há dados para outras plataformas. Quanto ao formato de entrada, segundo a tabela comparativa da reportagem, o cartão do modelo Bolt indica entrada de texto, e a forma NIM ainda aceita imagem e áudio; os modais realmente disponíveis e suas limitações ainda dependem da documentação oficial, e a reportagem não traz dados de avaliação desses modais.