Reflection AI lança modelo de pesos abertos Beam: 501B de parâmetros totais, 23B ativados, pesos Apache 2.0 pendentes
Segundo o MarkTechPost, em 5 de outubro de 2026, a Reflection AI lançou o Beam, seu primeiro modelo de pesos abertos, com 501B de parâmetros totais e 23B ativados por token, voltado a tarefas de programação e agentes, com suporte a parâmetro de intensidade de raciocínio e contexto efetivo de 1 milhão de tokens; os pesos sob Apache 2.0 estão previstos para o final de outubro de 2026, e o modelo ainda está em red teaming e só tem lista de espera aberta.
O que mudou
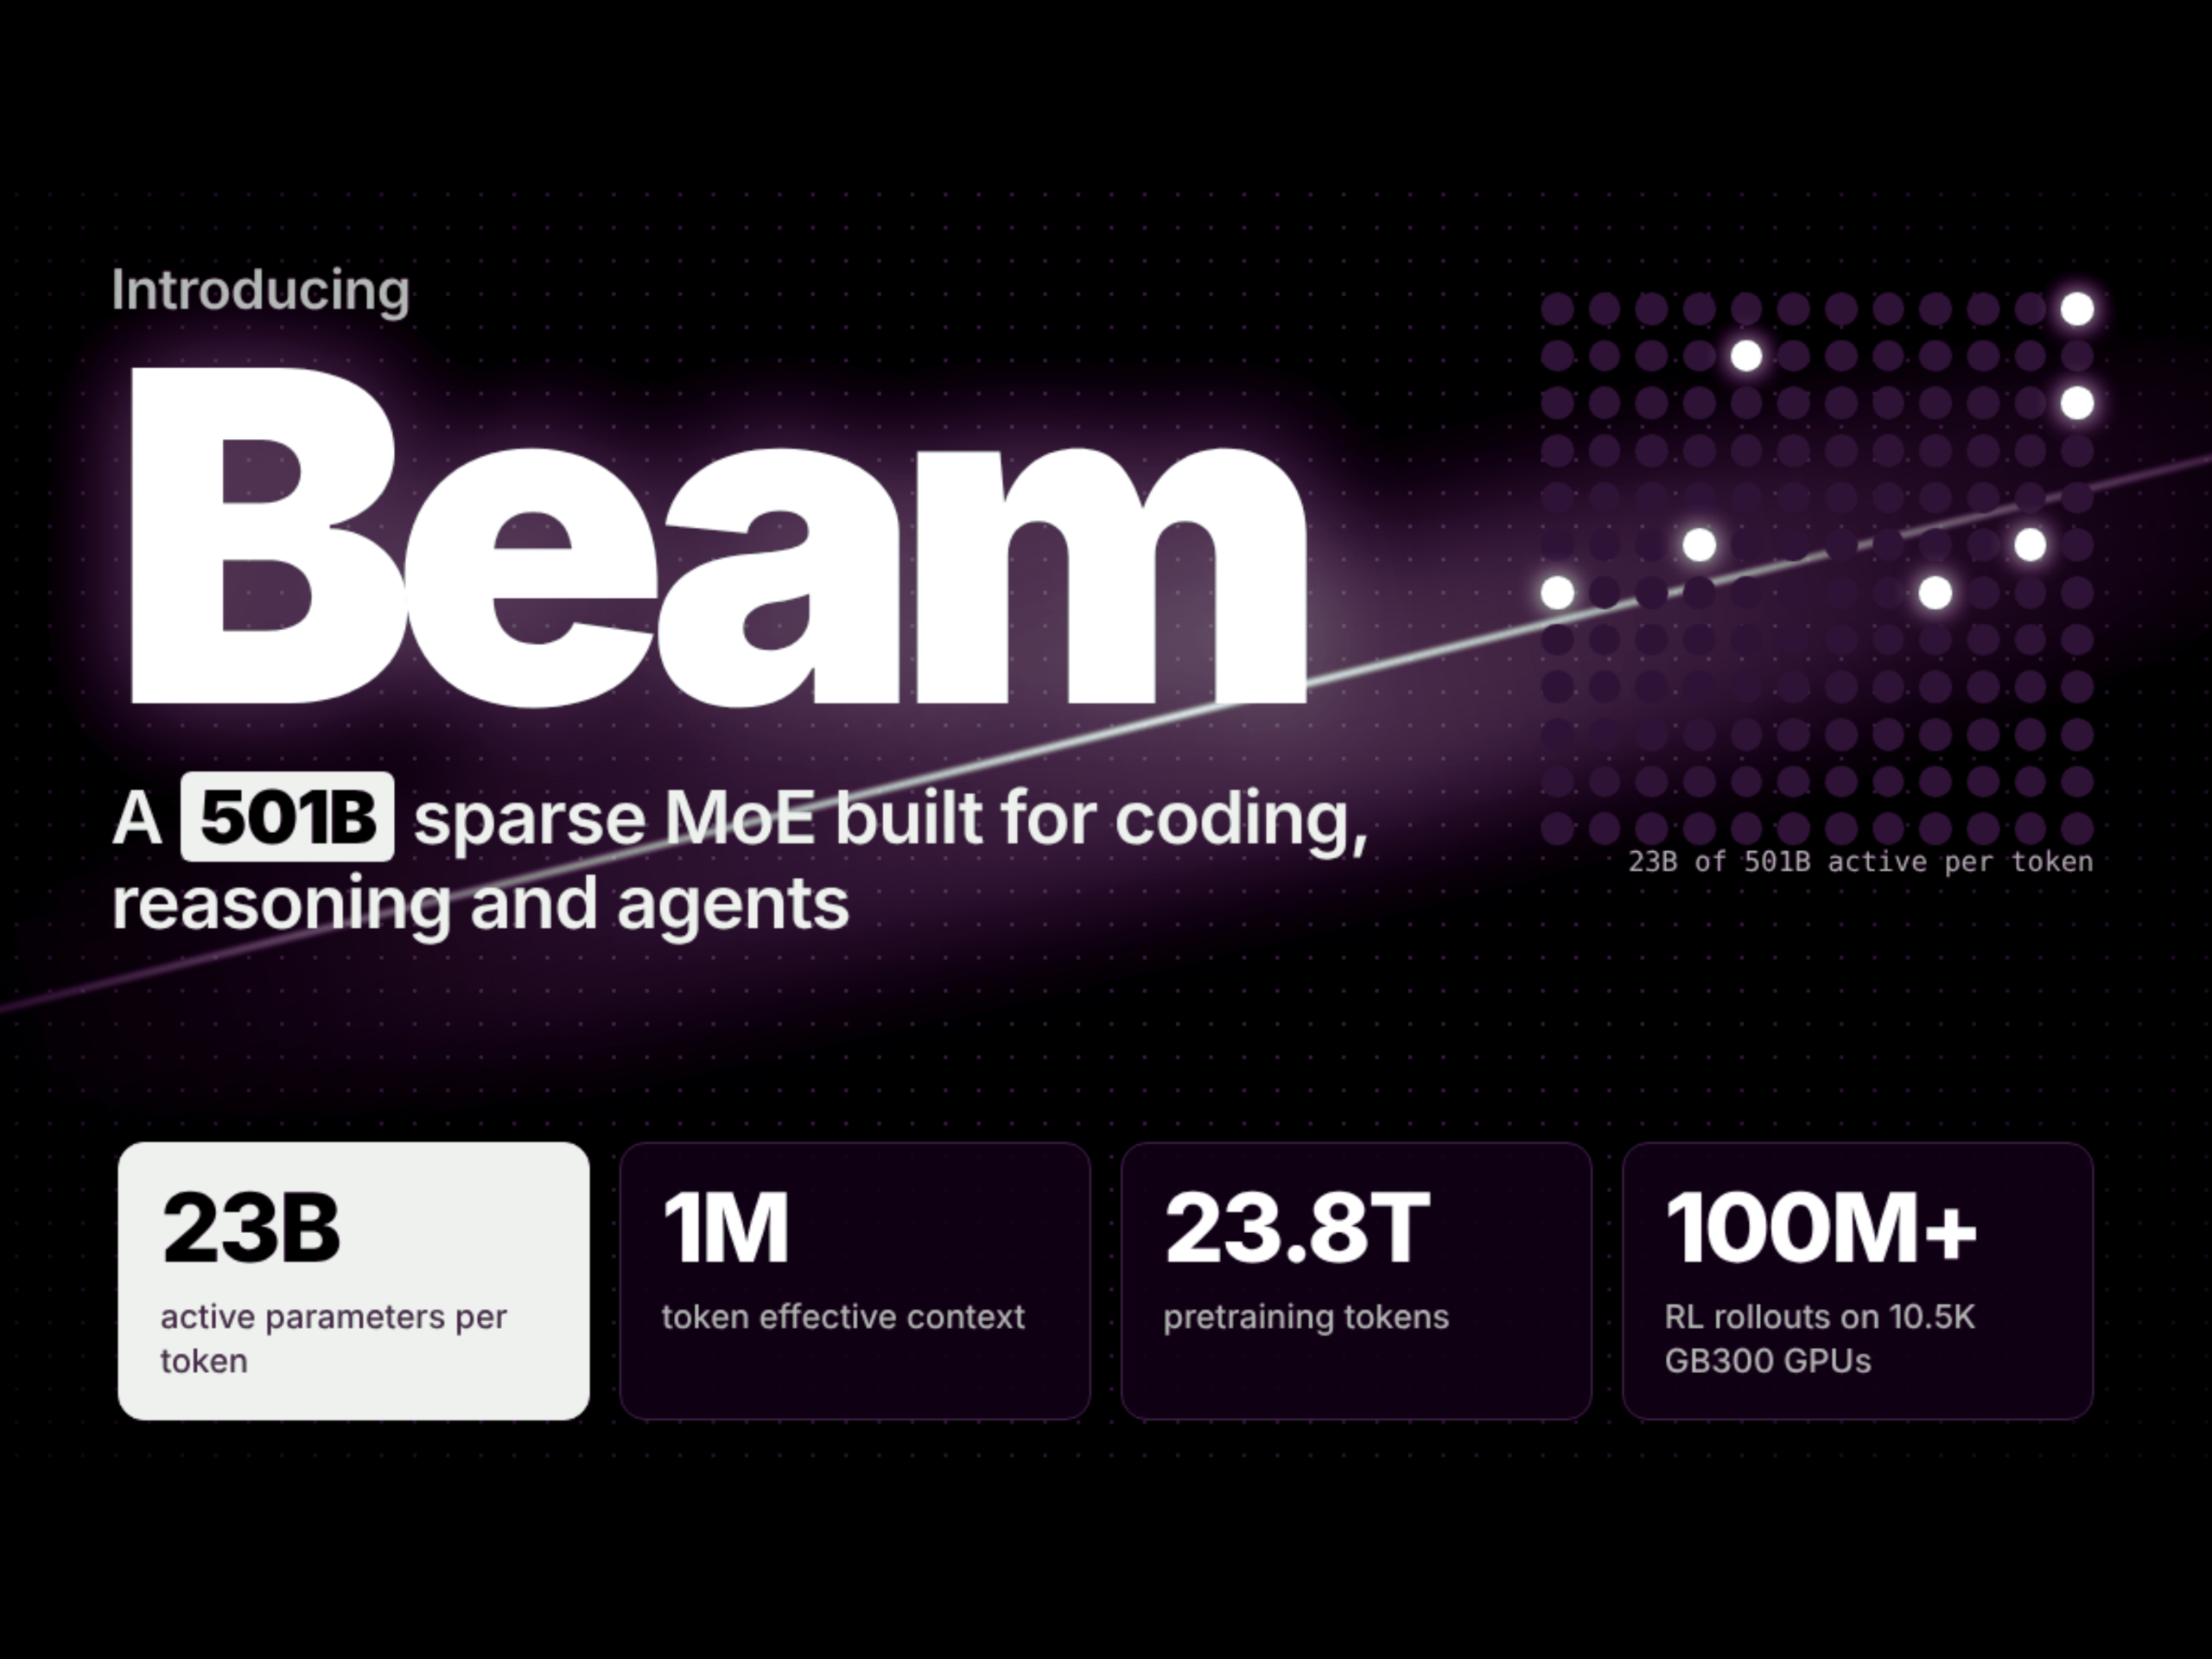
Segundo o MarkTechPost, em 5 de outubro de 2026, a Reflection AI lançou o Beam, seu primeiro modelo de pesos abertos. O Beam é um modelo esparso de mistura de especialistas, com 501B de parâmetros totais e 23B ativados por token, voltado a cargas de programação, raciocínio e agentes, com suporte apenas a entrada de texto e contexto efetivo de 1 milhão de tokens. A equipe da Reflection afirma que o Beam visa diretamente modelos abertos maiores, como o GLM 5.2, e que exige de 3 a 4 vezes menos poder de processamento de inferência em benchmarks de raciocínio, ao mesmo tempo que admite que o Kimi K3 ainda lidera em capacidade bruta. O modelo oferece um parâmetro de intensidade de raciocínio, ajustável conforme a dificuldade da tarefa e o orçamento de processamento. O pré-treinamento usou 23,8 trilhões de tokens e foi concluído em menos de 4 semanas em 6.144 GPUs NVIDIA GB300 NVL72; a fase de aprendizado por reforço usou 10,5 mil GPUs GB300 por 4 semanas, gerando mais de 100 milhões de rollouts, com contexto máximo de rollout de 256K tokens. Os resultados divulgados pela própria Reflection são SWE-bench Verified 80,9 e Terminal Bench v2.1 80,1. A informação é que o Beam ainda está na fase final de red teaming, a auto-hospedagem não está disponível no momento, o acesso antecipado se dá pela lista de espera da plataforma Reflection, e os pesos sob Apache 2.0 estão previstos para o final de outubro de 2026.
Impacto para desenvolvedores
Pelas especificações divulgadas na reportagem, o posicionamento do Beam não é apenas igualar o modelo aberto mais forte, mas reduzir os parâmetros ativados por token a 23B e, ao mesmo tempo, manter o total em 501B, trocando eficiência por menor barreira de implantação. Para os desenvolvedores, isso muda diretamente a estrutura de custos de inferência: se a afirmação de economia de 3 a 4 vezes no processamento se confirmar, a mesma tarefa de programação ou de agente pode atingir vazão próxima em menos GPUs, mas isso é uma afirmação da equipe da Reflection, não uma conclusão reproduzida de forma independente. O segundo nível de impacto está na licença: a reportagem diz que o Beam planeja adotar Apache 2.0, enquanto o Kimi K3 usado na comparação adota licença personalizada com exigência adicional de atribuição para produtos de escala muito grande, o GLM-5.2 e o DeepSeek V4.1 Flash usam MIT, e o Nemotron 3 Ultra usa OpenMDW-1.1. É preciso enfatizar que a abertura iminente dos pesos e a efetivação dos termos da licença são duas coisas distintas; o Apache 2.0, no momento da reportagem, ainda é um plano, e antes que os pesos sejam realmente lançados com a licença anexada, nenhum direito de uso deve ser considerado em vigor. O terceiro nível de impacto é a fronteira de capacidade: o Beam suporta apenas texto, diferente do DeepSeek V4.1 Flash e do Kimi K3 da comparação, que suportam texto e imagem, de modo que cargas multimodais ainda precisam de outro modelo. Em benchmarks, o DeepSeek V4.1 Flash e o Kimi K3 ainda lideram no Terminal Bench v2.1, o que mostra que vantagem de eficiência não equivale a superação ampla de capacidade.
Integração e avaliação
O que segue são recomendações e análises condicionais, não fatos da reportagem. Decisão um: incluir ou não o Beam no conjunto de candidatos para agentes de programação. A reportagem diz que seu SWE-bench Verified é 80,9 e o Terminal Bench v2.1 é 80,1, ambos autodeclarados pela Reflection; a premissa é que os pesos e a licença sejam realmente lançados, caso contrário a avaliação atual só pode ser feita pela lista de espera. O critério executável de avaliação é: em tarefas de geração de patches no próprio repositório, comparar a taxa de aprovação e o consumo de tokens por tarefa com o modelo em uso; só há valor de troca se a taxa de aprovação for próxima e o consumo de tokens cair de forma significativa. Decisão dois: como lidar com o trade-off entre custo e qualidade trazido pelo parâmetro de intensidade de raciocínio. A reportagem diz que o nível baixo desse parâmetro tende a respostas curtas e o alto permite raciocínio mais longo, um ponto de controle explícito exclusivo do Beam; ele se aplica a pipelines com distribuição de dificuldade muito variável. O princípio de escolha é: primeiro fixar as demais variáveis, rodar os níveis baixo, médio e alto no mesmo conjunto de problemas difíceis, registrar a taxa de acerto e o total de tokens de saída, encontrar o ponto de inflexão da curva de custo e então decidir qual nível definir como padrão, em vez de usar um único nível globalmente. Decisão três: verificação prévia de licença e conformidade. Antes do lançamento dos pesos, deve-se colocar como pré-condição de entrada em produção se ela realmente será lançada sob Apache 2.0 e se o arquivo de licença será fornecido junto com os pesos; se os termos de lançamento divergirem do esperado pela reportagem, a decisão de troca precisará ser refeita. O critério de avaliação é se o arquivo de licença é fornecido junto com os pesos e se os termos correspondem ao esperado.
Limites e pontos a confirmar
No momento da reportagem, o Beam ainda estava na fase final de red teaming, a auto-hospedagem não estava disponível e o acesso antecipado se dava apenas pela lista de espera da plataforma Reflection, portanto não é possível fazer testes locais com os pesos agora. Todas as pontuações de benchmark vêm da tabela divulgada pela própria Reflection, em que as pontuações dos concorrentes são citadas do Artificial Analysis e do DataCurve, sem reprodução independente de terceiros; SWE-bench Verified 80,9 e Terminal Bench v2.1 80,1 devem ser tratados como dados autodeclarados pelo fabricante. O Apache 2.0 é descrito como plano, e os pesos estão previstos para o final de outubro de 2026; até o momento desta verificação do catálogo atual, esta versão lançada do Beam não está listada no KimiSeek, e a disponibilidade de API e plataforma mencionada na reportagem se refere à Reflection AI, sem relação com o catálogo deste site. Os resultados de avaliação de segurança, segundo a reportagem, serão publicados no relatório técnico, e ainda não há dados concretos. A afirmação de economia de 3 a 4 vezes no processamento de inferência vem da equipe da Reflection, e as condições de teste, a escolha de linha de base e o método de medição não são explicados na reportagem. Se o ganho de eficiência pode ser reproduzido em ambiente auto-hospedado ainda é desconhecido.
Ilustrações da notícia original