Reflection Beam 发布开放权重 501B 模型:Apache 2.0 权重与 AWS 两条部署路径
Segundo um blog da AWS publicado em 16 de outubro de 2026, a Reflection AI lançou o Beam, um modelo de pesos abertos voltado à codificação agêntica e a tarefas de longo horizonte, com 501B parâmetros totais e 23B parâmetros ativados, contexto efetivo relatado de 1 milhão de tokens, pesos publicados no Hugging Face sob licença Apache 2.0, checkpoints BF16/FP8/NVFP4 e dois caminhos de implantação: SageMaker JumpStart e HyperPod.
O que mudou
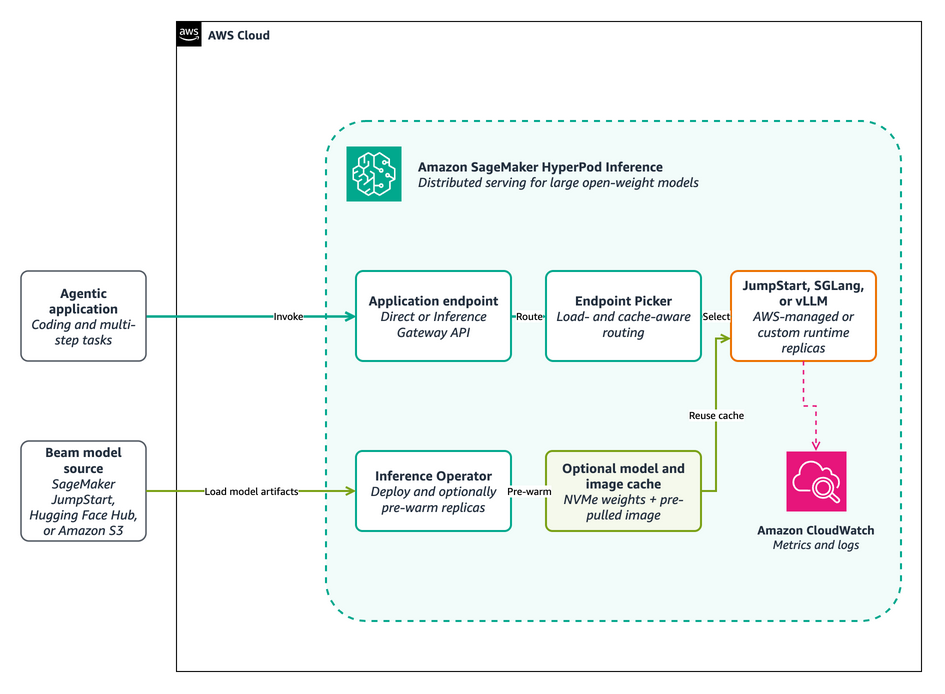
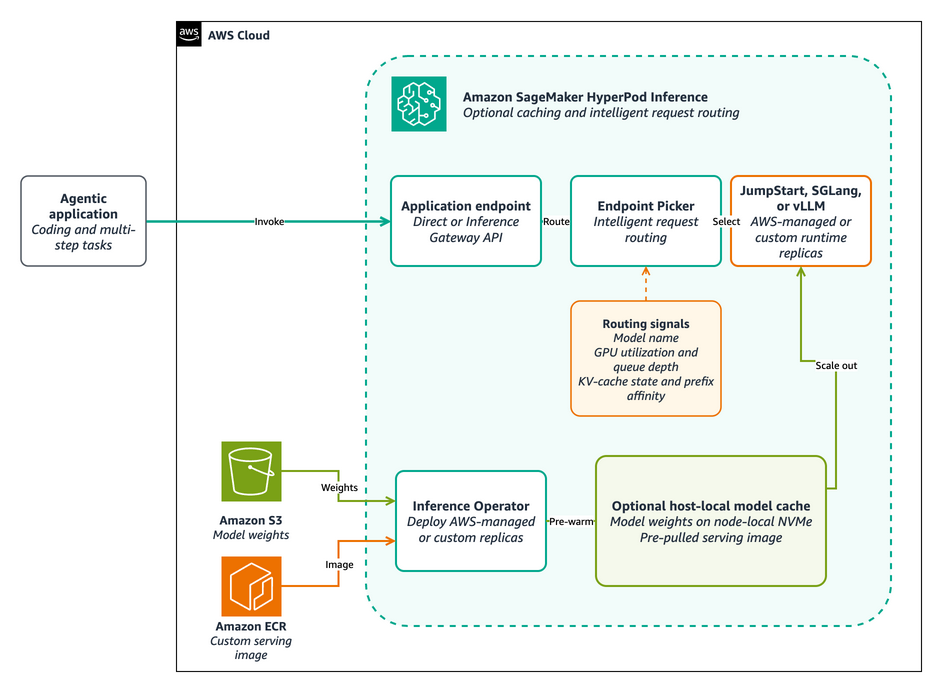
Segundo um blog oficial da AWS de 16 de outubro de 2026, a Reflection AI lançou o Beam, um modelo de pesos abertos posicionado para codificação agêntica e tarefas de longo prazo, como manutenção de código, chamada de ferramentas, interpretação de resultados e conclusão de fluxos de trabalho de múltiplas etapas. O modelo tem arquitetura esparsa de mistura de especialistas (MoE), com 501 bilhões de parâmetros totais e 23 bilhões de parâmetros ativados; a Reflection relata comprimento de contexto efetivo de 1 milhão de tokens. A Reflection publicou os pesos do Beam no Hugging Face sob licença Apache 2.0, e o Beam 1.0 oferece três variantes de checkpoint — BF16, FP8 e NVFP4 — para diferentes consumos de memória e hardwares. No lançamento, o modelo estava disponível no Amazon SageMaker JumpStart nas regiões Leste dos EUA (Norte da Virgínia) e Ohio. O blog também apresenta dois caminhos de implantação: endpoint em tempo real do SageMaker JumpStart (totalmente gerenciado) e SageMaker HyperPod Inference (com contêiner gerenciado do JumpStart ou SGLang e vLLM personalizados). O texto ainda traz orientação de escolha de instância por precisão: FP8 usa ml.p5.48xlarge com H100 ou ml.p5e/ml.p5en.48xlarge com H200; NVFP4 usa ml.p6-b200.48xlarge com B200; e destaca que os pesos BF16 têm a maior demanda de memória e exigem planejamento multinó. Em paralelo, trata-se de descrição reportada do blog; a KimiSeek não verificou de forma independente a capacidade do modelo, o suporte a instâncias nem a disponibilidade regional.
Impacto para desenvolvedores
A consequência direta para desenvolvedores é que se trata de um lançamento de pesos abertos, declarado sob licença Apache 2.0, o que é mais explícito, no plano da licença, do que apenas “pesos disponíveis para download”; ainda assim, os direitos de licença devem ser confirmados no repositório do Hugging Face e no texto dos termos, sem inferir de “pesos disponíveis” autorização para uso comercial, redistribuição ou treinamento derivado. Em engenharia, a estrutura esparsa 501B/A23B significa que memória de GPU e custo de implantação são determinados pelos parâmetros totais, enquanto o cálculo por token se aproxima da escala de 23B ativados; assim, memória dos pesos, sharding e layout de paralelismo são as restrições primárias: BF16 exige memória agregada multinó, e FP8 e NVFP4 restringem o hardware viável a instâncias específicas com H100/H200 e B200. Há trade-offs reais nas formas de implantação — o endpoint em tempo real do JumpStart encapsula modelo, contêiner e endpoint em um fluxo gerenciado, adequado para validação rápida; o HyperPod expõe cluster e runtime, permitindo fixar digest de imagem, commit SHA do Beam e parâmetros de paralelismo, adequado a equipes que precisam reproduzir resultados de desempenho ou personalizar quantização e parsers. O contexto efetivo de 1 milhão de tokens mencionado no blog afeta o orçamento de cache KV e a estratégia de batching, e o consumo de memória em contexto longo precisa ser medido, não estimado. Para avaliação, o modelo é voltado a chamadas de ferramentas em múltiplas etapas; benchmarks de pergunta e resposta de turno único não bastam para indicar seu desempenho em um ciclo agêntico real, sendo necessário construir cargas representativas de codificação e uso de ferramentas.
Integração e avaliação
A seguir estão sugestões de avaliação baseadas no blog, não conclusões verificadas. Primeiro, decida entre “gerenciado ou autogerenciado”: se o objetivo é integrar rapidamente e a equipe não tem operação de Kubernetes, use o endpoint em tempo real do JumpStart em um ciclo de vida delimitado (implantar, uma requisição, limpar), com critério de sucesso sendo o endpoint pronto e capaz de retornar resposta compatível com o schema de requisição publicado; só migre para SGLang ou vLLM no HyperPod quando precisar fixar parâmetros de runtime, quantização ou parsers personalizados, adotando como critério de aprovação a reprodutibilidade de digest de imagem, revisão do modelo e configuração de paralelismo. Segundo, faça uma decisão de capacidade por precisão: estime a memória agregada a partir do peso por réplica, cache KV e sobrecarga de runtime, e corrija com testes de carga; se o contexto alvo se aproximar do limite efetivo relatado, verifique primeiro se o tempo até o primeiro token p95 e o tempo por token de saída atendem ao orçamento de latência em contexto longo; se usar NVFP4 ou FP8, recheque se há degradação na qualidade da saída. Terceiro, defina uma linha de aceitação mensurável para o cenário agêntico: use requisições reais de correção de código e chamadas de ferramentas em múltiplas etapas, pressione repetidamente conforme a concorrência esperada, registre taxa de sucesso, tempo até o primeiro token p50/p95, latência ponta a ponta e throughput agregado de saída, e documente versão do modelo, digest de imagem, precisão, comprimento de contexto e estado de cache; sem isso, comparações entre configurações não são comparáveis. Quarto, valide em pequena escala antes de expandir: confirme cotas de serviço e capacidade regional do tipo de instância escolhido, lembrando que transferência de imagem, download de pesos e carregamento de shards consomem tempo considerável de cold start, e que estratégias de cache e auto scaling devem se basear em medições, não em suposições. Quinto, após os testes, limpe endpoints, clusters, pesos em cache e recursos IAM temporários conforme os exemplos oficiais, para evitar cobrança contínua.
Limites e pontos a confirmar
O Beam 1.0 (501B/A23B) deste lançamento não está atualmente listado na KimiSeek; portanto, os caminhos de implantação, formas de chamada e qualquer disponibilidade descritos aqui se referem aos canais de lançamento da Reflection AI e da AWS, não a serviços deste site; Kimi K3, GLM, Qwen e DeepSeek na KimiSeek são modelos diferentes e não constituem evidência de disponibilidade desta versão. Esta reportagem se baseia em uma única fonte, o blog da AWS; a KimiSeek não verificou de forma independente a contagem de parâmetros, o comprimento de contexto efetivo, o escopo real de aplicação da licença Apache 2.0, a compatibilidade de hardware de cada variante de checkpoint, o estado de disponibilidade nas duas regiões do Leste dos EUA nem o desempenho de benchmark do modelo; o blog não fornece pontuações públicas de benchmark de codificação ou agêntico, e as alegações de capacidade não devem ser tratadas como fatos verificados. Pesos abertos não equivalem a código aberto completo: termos de licença, dados de treinamento e materiais de reprodução ainda devem ser confirmados no repositório do Hugging Face e nas declarações oficiais da Reflection. Os recursos de cache, roteamento e gateway do HyperPod mencionados pertencem ao escopo funcional do SageMaker em 2026, e seu comportamento muda entre versões, exigindo consulta à documentação correspondente; tipos de instância e regiões também podem mudar com o tempo. Sobre custos, consulte as páginas de preços ou faturamento da Reflection AI, do Hugging Face e da AWS, pois preços e cotas variam. Além disso, os parâmetros de amostragem citados no blog (como temperature e top-p) são apenas valores iniciais de exemplo e não representam configurações recomendadas.
Ilustrações da notícia original